



47% госзаказчиков еще не приступили к импортозамещению

47% госзаказчиков еще не приступили к импортозамещению

47% госзаказчиков еще не приступили к импортозамещению

В 2020 году должна была завершиться программа импортозамещения программного обеспечения в государственном секторе, но с прошлого года неоднократно поднимается вопрос о переносе сроков. Компания «СёрчИнформ» опросила представителей отечественных компаний о ходе импортозамещения и о сложностях, с которыми они сталкиваются.

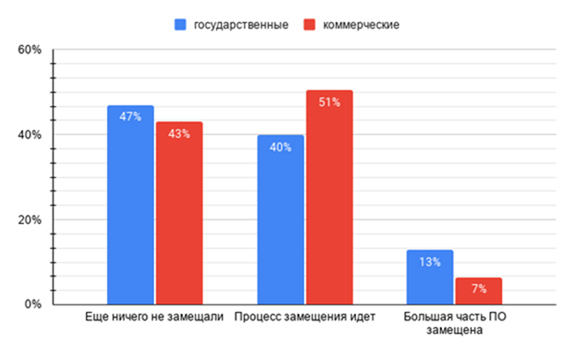
В госсекторе почти поровну тех, кто еще ничего не замещал (таких 47%) и тех, у кого процесс идет или подошел к завершению (в сумме 53%). Но число компаний, у которых большая часть уже замещена всего 13%.

В коммерческом секторе только для трети опрошенных компаний актуален вопрос импортозамещения – это крупные коммерческие организации с государственным участием. Из них 43% еще ничего не замещали, а активно процесс идет у половины опрошенных.

Таким образом за первоначально установленными сроками в рамках импортозамещения успевает только каждая десятая компания. 


«В коммерческом секторе процесс импортозамещения обогнал государственный по результативности. Это следствие специфики частного бизнеса, который демонстрирует динамичность, автономное принятие решений, наличие кадров и финансов. Впрочем, классические госкомпании не сильно отстали – показатель в условные 50% – это неплохой результат. Однако вызывает беспокойство, что совсем мало компаний завершают или завершили переход на отечественное ПО. Это свидетельство не прикладных, а системных проблем импортозамещения», – комментирует Алексей Парфентьев, руководитель отдела аналитики «СёрчИнформ».

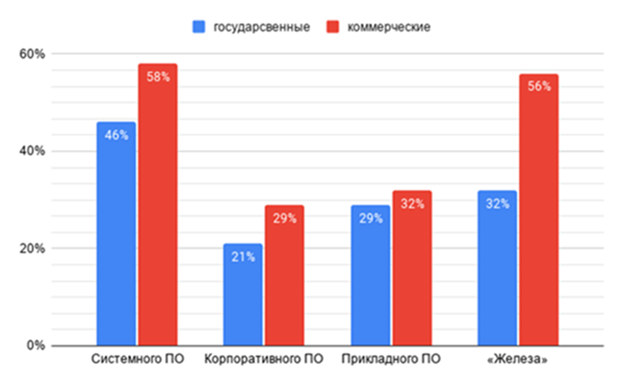
В анкете также был вопрос о сложностях в импортозамещении. Расклад ответов отражает ситуацию по доступности программ и оборудования российского производства для заказчиков. На российском рынке нет трудностей с разработкой корпоративных систем, но сохраняется дефицит ПО для широкого круга пользователей.


«Системное ПО поддается замещению труднее всего. Это ожидаемый результат опроса, ведь дело не только в трудозатратах, но и в необходимости переобучать сотрудников, адаптировать парк уже имеющегося прикладного ПО. Быстро это не сделаешь – потребуются годы на отладку, доработку и интеграцию ПО в крупные компании, – комментирует Алексей Парфентьев. – Переход на отечественное оборудование на деле вообще не стартовал, т.к. базового железа (процессоров, жестких дисков, плат и чипсетов) в промышленных масштабах пока не производится. С этим можно связать относительно невысокое число ответов: респонденты считают работу по замещению оборудования наименее актуальной, ее черед просто еще не пришел».

«СёрчИнформ» провела опрос в сентябре-ноябре, в нем приняли участие больше 800 компаний. Анкетирование проводилось в рамках глобального исследования уровня информационной безопасности во время серии конференций Road Show SearchInform.

Claude помог хакерам пробраться во внутренний репозиторий OpenAI

Команда белых хакеров превратила загрузку одной картинки на официальном форуме OpenAI в пропуск к корпоративным аккаунтам ChatGPT, Codex и закрытому репозиторию компании. Взлом занял менее трёх суток, а значительную часть работы помог выполнить ИИ.

Как рассказали исследователи HackTron AI, точкой входа стал форум community.openai.com на платформе Discourse.

При загрузке изображений он использовал ImageMagick и библиотеку libheif, в которой обнаружилось переполнение буфера. Специально подготовленный HEIC-файл позволил удалённо выполнить код и получить административный доступ к форуму.

На этом цепочка только разогрелась. Исследователи воспользовались отдельной ошибкой в системе единого входа OpenAI: токены аутентификации форума подходили для ChatGPT и Codex. Среди них оказались токены сотрудников компании.

Через скомпрометированный аккаунт разработчика команда добралась до внутреннего монорепозитория OpenAI на GitHub. Чтобы доказать доступ и не устраивать экскурсию по чужому коду, специалисты создали безопасный тестовый pull request, после чего остановили проверку и сообщили о проблеме.

В роли помощников выступили модели Claude Opus 4.8 и Opus 5. Первая исследовала уязвимость, но споткнулась о защитные механизмы. Более новая версия, по данным HackTron, помогла собрать рабочий эксплойт за несколько часов.

OpenAI устранила уязвимость в своей инфраструктуре примерно через 14 часов после отчёта, ограничила права токенов Community и отозвала затронутые сессии. Discourse отдельно исправила проблему обработки изображений.

За находку OpenAI выплатила исследователям $6500. Скромная сумма для цепочки, которая началась с картинки на форуме, а закончилась pull request во внутреннем репозитории.

RSS: Новости на портале Anti-Malware.ru