



Плагины для Chrome будут показывать список собираемых данных

Плагины для Chrome будут показывать список собираемых данных

Плагины для Chrome будут показывать список собираемых данных

Интернет-магазин Chrome Web Store откроет раздел, в котором разработчики расширений для браузера смогут публиковать списки данных, собираемых их продуктами, и свои планы по использованию этой информации. В Google надеются, что нововведение позволит повысить прозрачность политик конфиденциальности и усилить защиту пользовательских данных.

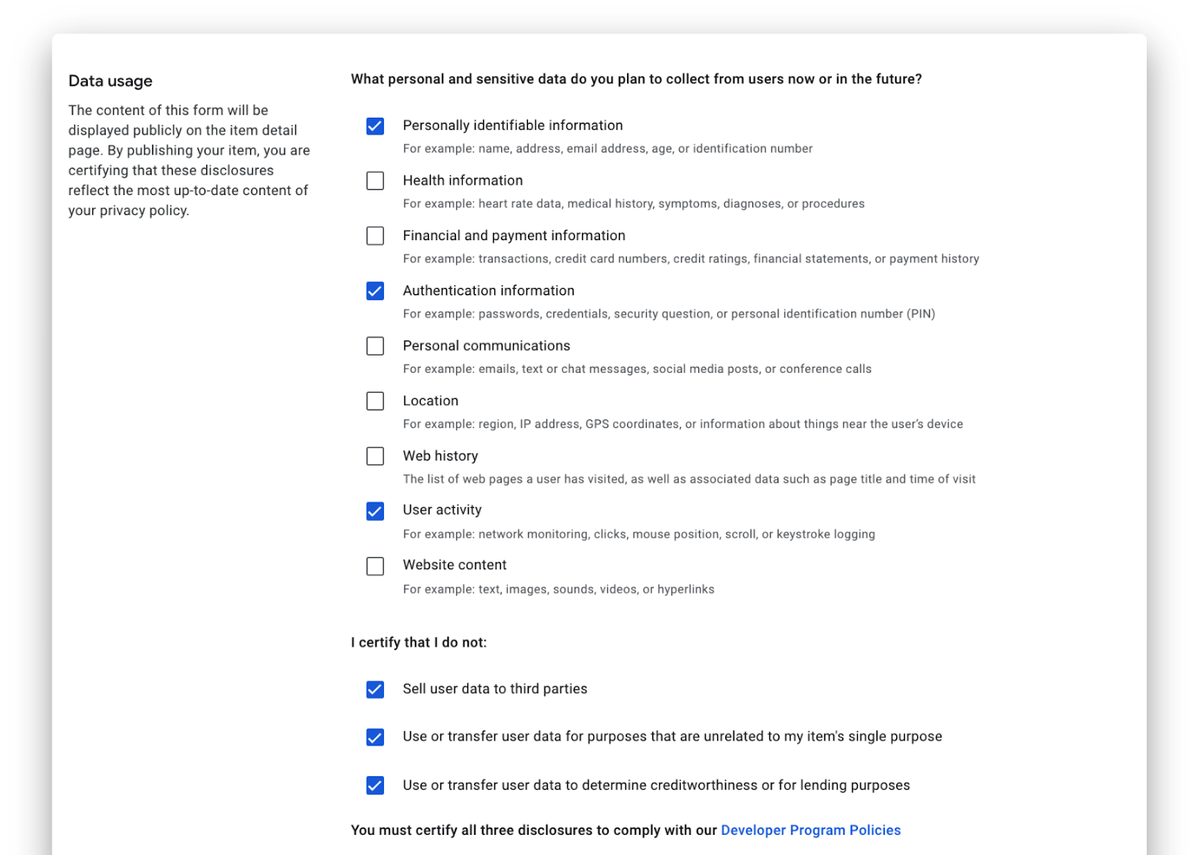
Открытие нового раздела Chrome Web Store запланировано на 18 января. В Google также создали веб-форму, облегчающую публикацию практик в отношении приватности пользователей. Эта форма отчетности уже доступна разработчикам через консоль; ее содержимое пользователи смогут увидеть, вызвав кнопкой Privacy practices в соответствующей позиции каталога.

Помимо списка данных, собираемых плагином, декларация разработчика должна содержать удостоверение соответствия требованиям Chrome Web Store. Автор должен однозначно заявить, что он не продает информацию о пользователях третьим лицам, не использует ее в целях, не предусмотренных назначением продукта, и не передает их для оценки кредитоспособности потенциальных клиентов.


Названные ограничения уже добавлены в политики Chrome Web Store по защите конфиденциальности пользовательских данных.

Аналогичные нововведения недавно озвучила Apple. Компания расширит требования к публикациям в своем магазине, обязав разработчиков предоставлять информацию о характере и использовании данных, собираемых приложениями. Запуск обновленного интерфейса пользователя App Store запланирован на 8 декабря.

Подпишитесь на новости

Наталья Касперская поставила под сомнение доверие к генеративному ИИ

Генеративный ИИ умеет писать тексты и код, но можно ли на него полагаться? Наталья Касперская считает, что с доверием к таким системам пока больше вопросов, чем ответов. В интервью корреспонденту Anti-Malware.ru Олесе Афанасьевой на BIS Summit она назвала критерий доверенности применительно к генеративному ИИ загадкой.

По объяснению Касперской, доверенная система должна работать с заранее заданными параметрами и обеспечивать предсказуемый результат.

Генеративный ИИ, по её оценке, под это определение не подпадает: он не способен каждый раз выдавать один и тот же результат.

«Критерий доверенности в применении к генеративному искусственному интеллекту для меня является загадкой», — заявила она.

Главная проблема, считает Касперская, — масштаб моделей. Огромное количество параметров и данных делает полноценную проверку такой системы практически недостижимой. Можно протестировать отдельные ответы и сценарии, но это ещё не доказывает надёжность всей модели.

«Вы можете сделать какие-то выборочные проверки, частичные. Они будут выборочными и частичными, они ничего не докажут», — подчеркнула Касперская.

Получается неудобный вопрос для бизнеса и государства: как доверять системе, поведение которой нельзя исчерпывающе проверить? По словам председателя правления АРПП «Отечественный софт», задача создания доверенного ИИ поставлена, но готового способа её решения она пока не видит.

Одними разговорами, считает Касперская, проблему не закрыть. Нужна совместная работа специалистов по ИИ и информационной безопасности, методистов и разработчиков стандартов.

RSS: Новости на портале Anti-Malware.ru