


Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Группа исследователей из Университета Техаса и Университета Пердью предложила необычную идею: большие языковые модели (LLM), вроде ChatGPT, могут «тупить» от некачественных данных примерно так же, как люди — от бесконечных часов в соцсетях.

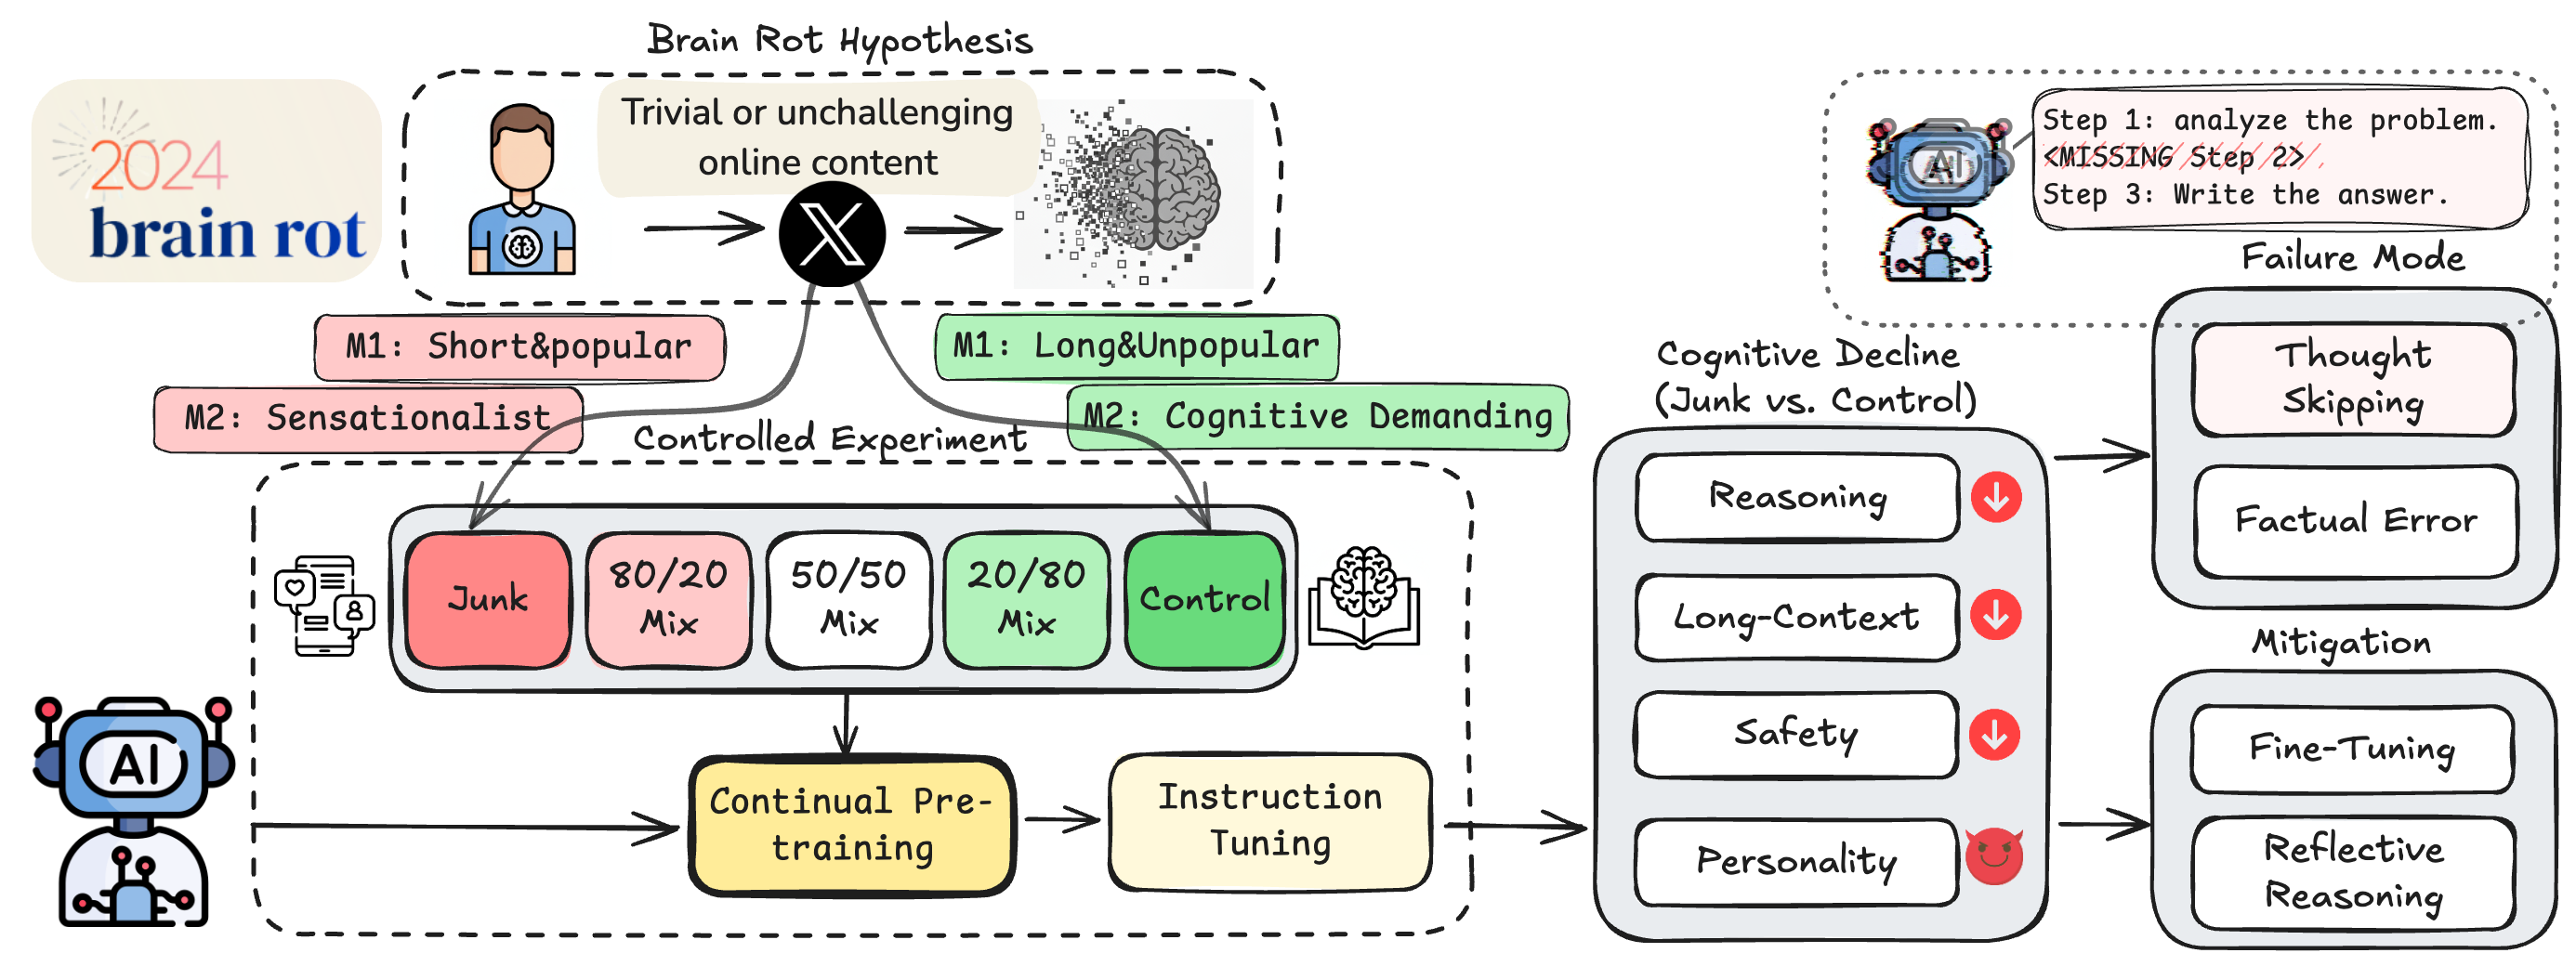
В отчёте специалисты выдвигают «гипотезу гниения мозга LLM». Суть проста: если продолжать дообучать языковую модель на «мусорных» текстах из интернета, она со временем начнёт деградировать — хуже запоминать, терять логику и способность к рассуждению.

Авторы понимают, что отличить хороший контент от плохого сложно. Поэтому они решили изучить 100 миллионов твитов с HuggingFace и отобрать те, что подходят под определение «junk».

В первую группу попали короткие твиты с большим количеством лайков и репостов — те самые, которые вызывают максимальное вовлечение, но несут минимум смысла. Во вторую — посты с «низкой семантической ценностью»: поверхностные темы, кликбейт, громкие заявления, конспирология и прочие «триггерные» темы.


Чтобы проверить качество отбора, результаты GPT-4o сверили с оценками трёх аспирантов — совпадение составило 76%.

Учёные обучили четыре разные языковые модели, комбинируя «мусорные» и «качественные» данные в разных пропорциях. Потом прогнали их через тесты:

  • ARC — на логическое рассуждение,
  • RULER — на память и работу с длинным контекстом,
  • HH-RLHF и AdvBench — на этические нормы,
  • TRAIT — на анализ «личностного стиля».

Результаты оказались любопытными: чем больше в обучающем наборе было «интернет-мусора», тем хуже модель справлялась с задачами на рассуждение и память. Однако влияние на «этичность» и «черты личности» было неоднозначным: например, модель Llama-8B с 50% «мусора» даже показала лучшие результаты по «открытости» и «низкой тревожности».

Исследователи сделали вывод: переизбыток интернет-контента может привести к деградации моделей и призвали разработчиков тщательнее отбирать данные для обучения. Особенно сейчас, когда всё больше онлайн-текста создаётся уже самими ИИ — и это может ускорить эффект так называемого model collapse, когда модели начинают обучаться на собственных ошибках.

Учёные шутят: если так пойдёт и дальше, возможно, придётся вернуться к книгам — хотя бы ради того, чтобы «накормить» модели чем-то действительно качественным.

Подпишитесь на новости

GrayKey обещает полиции доступ к данным iPhone в обход автоперезагрузки

Apple усложнила доступ к заблокированным iPhone, а производитель инструментов для полиции нашёл ответ. Magnet Forensics заявляет, что научилась сохранять смартфоны в состоянии, удобном для извлечения данных. Речь о GrayKey Preserve и функции Evidence Preservation Mode для обычных устройств GrayKey.

Как сообщает 404 Media, получившее закрытое видео компании, инструменты нацелены на обход inactivity reboot. Эта функция перезагружает iPhone после 72 часов без разблокировки и затрудняет доступ к конфиденциальным данным.

По заявлениям Magnet, инструменты сохраняют состояние After First Unlock — после первой разблокировки. Причём даже при последующей перезагрузке устройства. Это должно дать специалистам больше времени на работу с изъятым телефоном.

Компания также обещает остановить автоматическое удаление отдельных данных: кешированных геопозиций, недавно удалённых фотографий и сообщений iMessage. Фактически — поставить их срок хранения на паузу.

Как именно это устроено, неизвестно. Исследовательница в области безопасности iPhone Йиска Классен предполагает манипуляции с часами устройства или отключение задач, отвечающих за истечение срока хранения данных. Но по одному видео подтвердить механизм нельзя.

Apple и Magnet не ответили на запросы издания. Независимой проверки заявленных возможностей в публикации нет, как и подтверждения, что инструменты работают с любым iPhone.

RSS: Новости на портале Anti-Malware.ru