


Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Группа исследователей из Университета Техаса и Университета Пердью предложила необычную идею: большие языковые модели (LLM), вроде ChatGPT, могут «тупить» от некачественных данных примерно так же, как люди — от бесконечных часов в соцсетях.

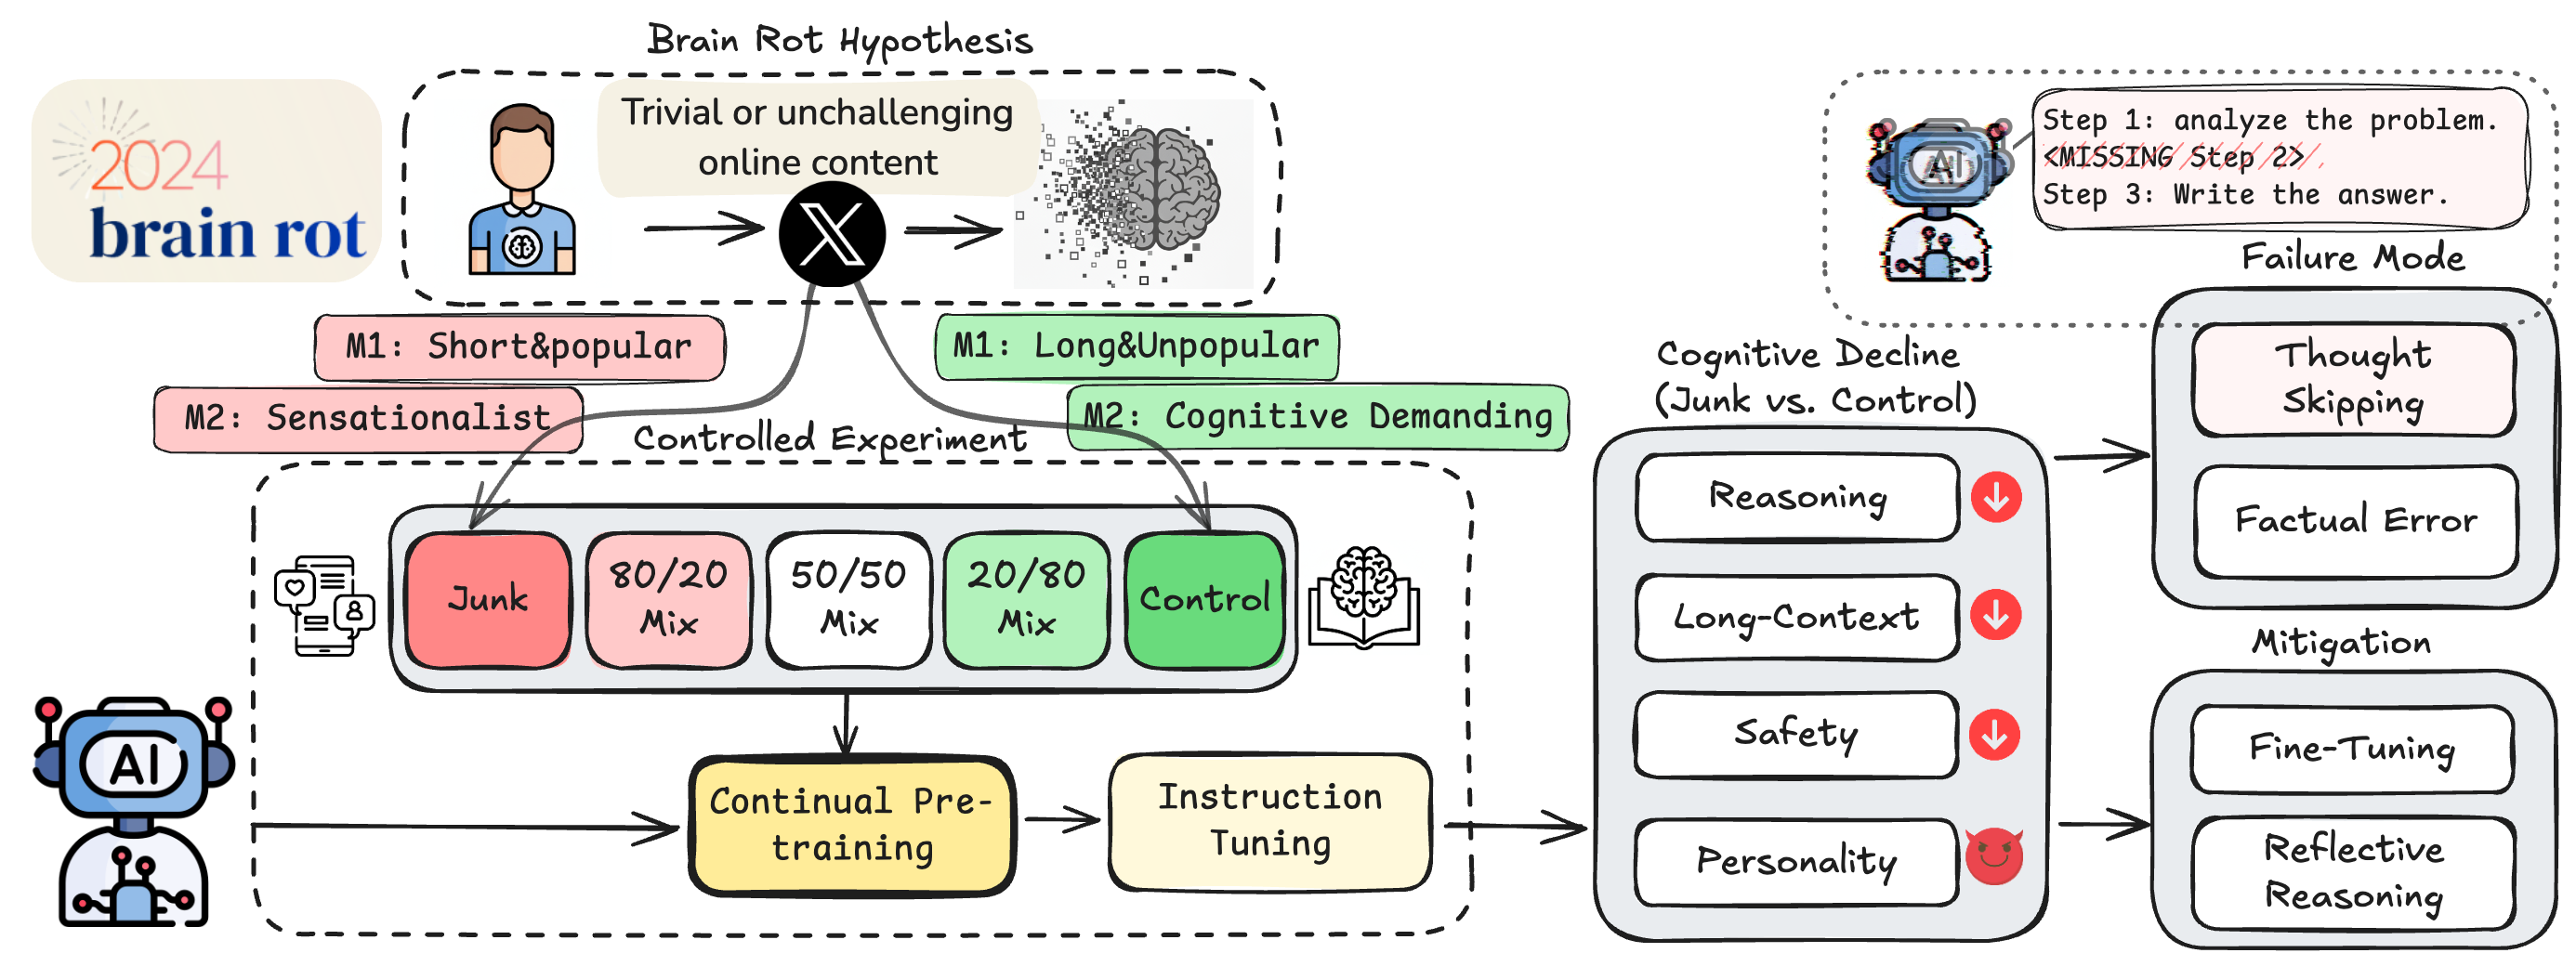
В отчёте специалисты выдвигают «гипотезу гниения мозга LLM». Суть проста: если продолжать дообучать языковую модель на «мусорных» текстах из интернета, она со временем начнёт деградировать — хуже запоминать, терять логику и способность к рассуждению.

Авторы понимают, что отличить хороший контент от плохого сложно. Поэтому они решили изучить 100 миллионов твитов с HuggingFace и отобрать те, что подходят под определение «junk».

В первую группу попали короткие твиты с большим количеством лайков и репостов — те самые, которые вызывают максимальное вовлечение, но несут минимум смысла. Во вторую — посты с «низкой семантической ценностью»: поверхностные темы, кликбейт, громкие заявления, конспирология и прочие «триггерные» темы.


Чтобы проверить качество отбора, результаты GPT-4o сверили с оценками трёх аспирантов — совпадение составило 76%.

Учёные обучили четыре разные языковые модели, комбинируя «мусорные» и «качественные» данные в разных пропорциях. Потом прогнали их через тесты:

  • ARC — на логическое рассуждение,
  • RULER — на память и работу с длинным контекстом,
  • HH-RLHF и AdvBench — на этические нормы,
  • TRAIT — на анализ «личностного стиля».

Результаты оказались любопытными: чем больше в обучающем наборе было «интернет-мусора», тем хуже модель справлялась с задачами на рассуждение и память. Однако влияние на «этичность» и «черты личности» было неоднозначным: например, модель Llama-8B с 50% «мусора» даже показала лучшие результаты по «открытости» и «низкой тревожности».

Исследователи сделали вывод: переизбыток интернет-контента может привести к деградации моделей и призвали разработчиков тщательнее отбирать данные для обучения. Особенно сейчас, когда всё больше онлайн-текста создаётся уже самими ИИ — и это может ускорить эффект так называемого model collapse, когда модели начинают обучаться на собственных ошибках.

Учёные шутят: если так пойдёт и дальше, возможно, придётся вернуться к книгам — хотя бы ради того, чтобы «накормить» модели чем-то действительно качественным.

Подпишитесь на новости

Рынок микроэлектроники в России может достичь 1,5 трлн рублей

России понадобится больше чипов, однако есть вопрос, кто их произведёт. Сбербанк подготовил три сценария развития спроса на микроэлектронику до 2036 года для стратегии «Объединённой микроэлектронной компании». В базовом варианте потребление почти удвоится: с эквивалента 0,8-1 млн кремниевых пластин диаметром 200 мм в 2025 году до 1,6-1,8 млн.

В деньгах рынок может вырасти с 500-600 млрд до 1,4-1,5 трлн рублей. Документ изучил CNews.

Оптимистичный сценарий предусматривает спрос на 2-2,2 млн пластин, консервативный — на 1,1-1,3 млн. Разница зависит от выполнения проектов, темпов локализации и запуска производств.

Главный двигатель роста — импортозамещение: оно должно обеспечить около 0,6 млн дополнительных пластин. Естественное расширение рынка добавит примерно 0,2 млн. Около 57% спроса приходится на вычислительную инфраструктуру и телеком — серверы, хранилища и сетевое оборудование.

Но одними прогнозами технологический разрыв не закрыть. Память и логические микросхемы формируют более 60% спроса, причём около 70% этого сегмента связано с технологиями, пока недоступными российским производителям.

До 2030 года в развитие ОМК планируют вложить 1 трлн рублей: 750 млрд из бюджета и 250 млрд от Сбербанка. Спрос обещает вырасти. Производственные возможности ещё предстоит подтянуть.

RSS: Новости на портале Anti-Malware.ru