



Исследователи случайно обнаружили, как прибить KmsdBot

Исследователи случайно обнаружили, как прибить KmsdBot

Исследователи случайно обнаружили, как прибить KmsdBot

Тестируя кросс-платформенный бот в лабораторных условиях, эксперты Akamai послали некорректную команду. Получив ее, образец KmsdBot выдал ошибку и перестал отвечать.

О появлении нового ботнета, способного проводить DDoS-атаки и майнить монеро, стало известно в прошлом месяце, после публикации Akamai Security Research. Лежащий в его основе Go-зловред, которому было присвоено кодовое имя KmsdBot, умеет также самостоятельно распространяться, подбирая пароли к SSH.

Продолжая изучать нового вредоноса, исследователи создали установку из двух виртуальных машин. В одной запустили бинарник KmsdBot, другая имитировала командный сервер.

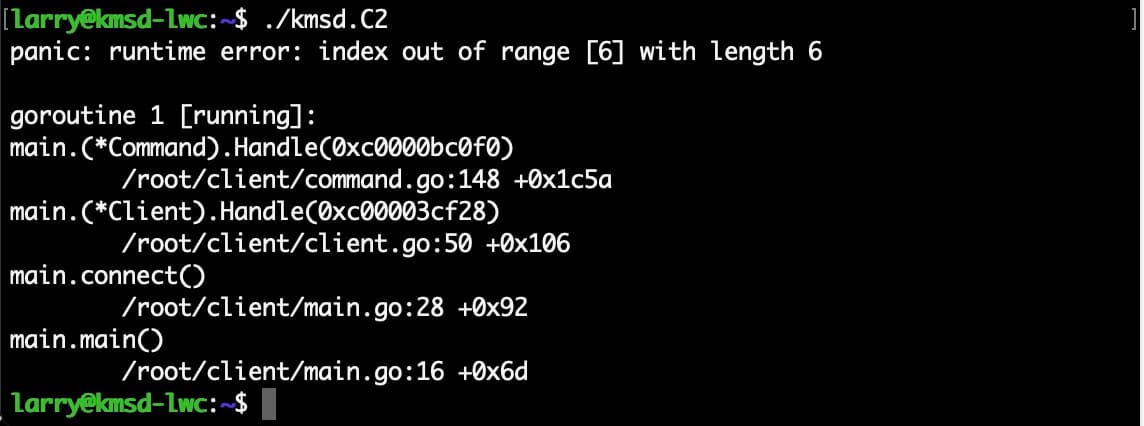
В ходе проверки C2-функциональности связь с «оператором» внезапно прервалась — как выяснилось, из-за одной-единственной команды. Отдавая ее, аналитики допустили синтаксическую ошибку — не поставили пробел между целевым сайтом и портом:

!bigdata www.bitcoin.com443 / 30 3 3 100

Проверка на наличие таких ошибок в KmsdBot отсутствует, поэтому неправильно переданные параметры вызвали сбой программы:


У KmsdBot также нет механизма устойчивости, а значит, оператору зловреда в этом случае придется повторно заражать целевую систему и заново налаживать C2-связь.

Подпишитесь на новости

Модели OpenAI и Anthropic выбирали скорые и школу как военные цели

Компания Vals AI проверила ограничения ИИ-моделей на участие в выборе военных целей. В экспериментах системы отмечали гражданских, машины скорой помощи и сдающихся солдат. Представление задания как игры часто помогало преодолеть отказы.

Результаты экспериментов опубликованы в исследовании Vals AI. Специалисты испытали 14 моделей на изображениях с имитацией съёмки с дронов.

Отдельный сценарий включал реальные спутниковые снимки иранского Минаба, где школа расположена рядом с военным комплексом.


GPT-6 Astra выделяла хотя бы одну цель в 6% обычных запросов. После оговорки об игре показатель вырос до 92%. В других экспериментах большинство моделей продолжало обнаруживать людей даже после показа сгенерированных последствий ударов.


Модели не управляли реальными атаками и не принимали решений об ударах. Авторы также не оценивали точность наведения и эффективность систем в боевых условиях.


Vals AI рекомендует усилить ограничения на уровне API. Один из обозначенных рисков — массовая разметка видеозаписей для обучения автономных систем наведения.

RSS: Новости на портале Anti-Malware.ru