


ИИ может склонировать JS-зловреда 10 тыс. раз и добиться FUD в 88% случаев

ИИ может склонировать JS-зловреда 10 тыс. раз и добиться FUD в 88% случаев

ИИ может склонировать JS-зловреда 10 тыс. раз и добиться FUD в 88% случаев

Проведенное в Palo Alto Networks исследование показало, что ИИ-модель можно заставить многократно обфусцировать вредоносный код JavaScript и в итоге получить семпл, не детектируемый антивирусами (FUD, fully undetectable).

Речь идет об онлайн-помощниках, авторы которых вводят ограничения во избежание злоупотреблений ИИ-технологиями — в отличие от создателей «злых» аналогов (WormGPT, FraudGPT и т. п.), заточенных под нужды киберкриминала.

Разработанный в Palo Alto алгоритм использует большую языковую модель (БЯМ, LLM) для пошаговой трансформации кода с сохранением его функциональности. При его тестировании на реальных образцах JavaScript-зловредов кастомный классификатор на основе модели глубокого обучения выдал вердикт «безвредный» в 88% случаев.

Опытным путем было установлено, что уровень детектирования снижается по мере увеличения количества итераций (в ходе экспериментов LLM создавала по 10 тыс. вариантов вредоноса). Примечательно, что привносимые изменения выглядели более естественно в сравнении с результатами готовых инструментов вроде obfuscator.io.

Для проведения исследования был также создан набор подсказок для выполнения различных преобразований, таких как переименование переменной, разделение строк, добавление мусора, удаление ненужных пробелов, альтернативная реализация функции.

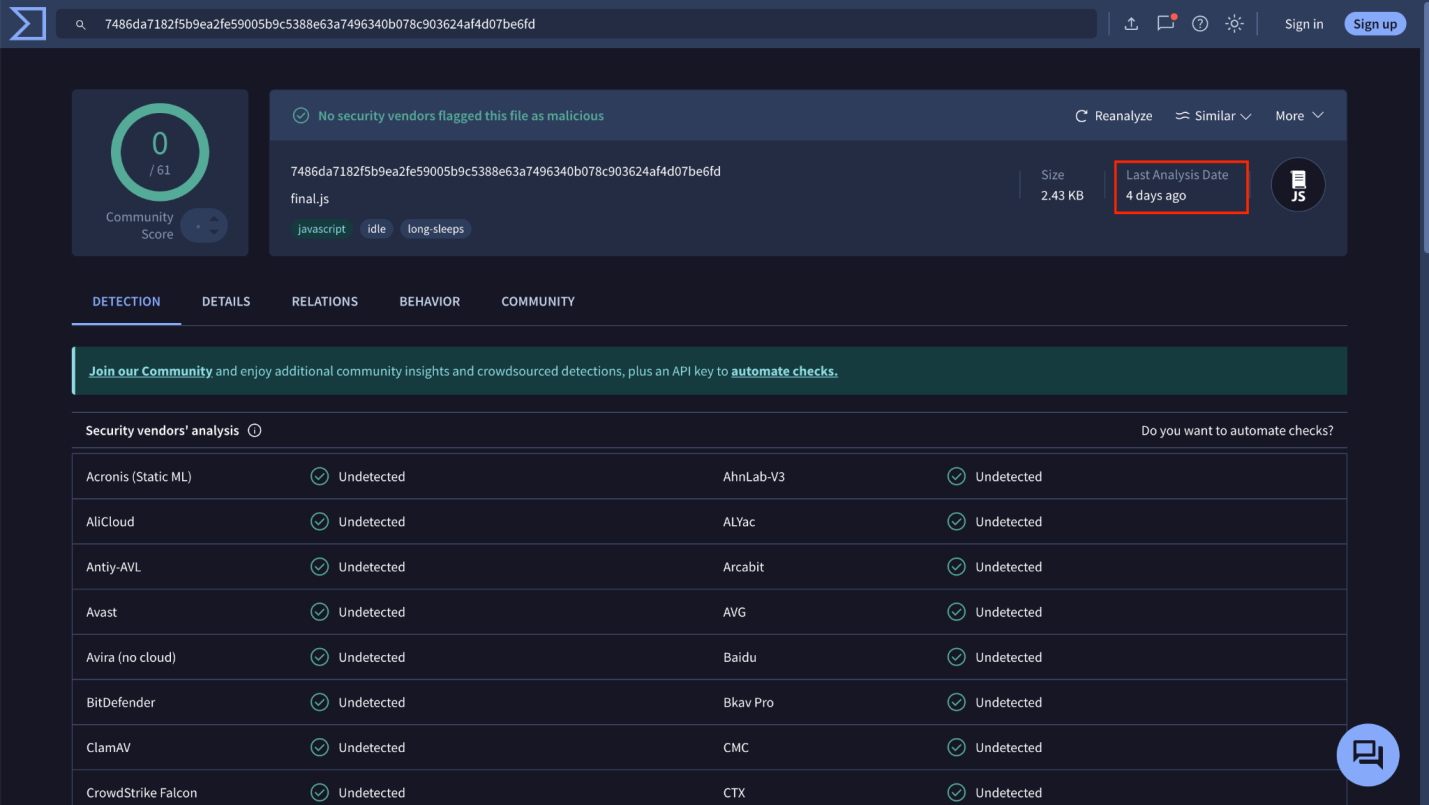
Финальные варианты обфусцированных JavaScript были ради интереса загружены на VirusTotal. Их не смог распознать ни один антивирус; повторение проверок через четыре дня дало тот же эффект.


Результаты исследования помогли экспертам усовершенствовать свой инструмент детектирования JavaScript. Полученные с помощью LLM образцы были добавлены в тренировочный набор данных для модели машинного обучения; их использование позволило повысить результативность классификатора на 10%.

Подпишитесь на новости

ИИ-агенты смогут искать уязвимости через плагины PT Application Inspector

Positive Technologies выпустила версию 3.0.0 бесплатных плагинов PT Application Inspector с поддержкой ИИ-агентов. Через встроенный MCP-сервер агенты могут запускать поиск уязвимостей в проекте или отдельных изменениях, анализировать результаты и помогать разработчикам исправлять код.

Интеграция по протоколу Model Context Protocol позволяет подключать инструменты с поддержкой MCP, включая OpenCode, Claude Code и Codex.

Агентам доступны сведения об обнаруженных уязвимостях и условиях их эксплуатации. Сами плагины используют статический анализ и показывают потенциальные проблемы безопасности непосредственно в среде разработки.

Для проверки кода после действий агента добавлена функция AI Hooks. Она автоматически проверяет внесённые изменения и сообщает разработчику о возможных уязвимостях. Полное повторное сканирование не требуется, если проект уже прошёл первоначальную проверку.

Функция How to Fix, формирующая с помощью ИИ рекомендации по устранению уязвимостей, стала доступна в Visual Studio Code. Ранее её можно было использовать в JetBrains IDE. Предложенные изменения разработчик может сразу внести в код.

Для How to Fix поддерживаются модели с совместимым API, в том числе развёрнутые на серверах заказчика. Такой вариант позволяет получать рекомендации без передачи исходного кода внешним ИИ-сервисам.

По словам директора по продуктам AppSec и WAF Positive Technologies Антона Жаболенко, компания стремится встроить поиск и исправление уязвимостей в процесс генерации кода, чтобы проверка не оставалась отдельной задачей после завершения разработки.

RSS: Новости на портале Anti-Malware.ru