


Кто-то взломал Архив Интернета и вытащил данные 31 млн пользователей

Кто-то взломал Архив Интернета и вытащил данные 31 млн пользователей

Кто-то взломал Архив Интернета и вытащил данные 31 млн пользователей

Некоммерческая организация «Архив Интернета» (Internet Archive), которой принадлежит сервис Wayback Machine, хранящий историю веб-страниц, стала жертвой взлома и утечки внутренних данных. По оценкам экспертов, инцидент затронул 31 млн пользователей.

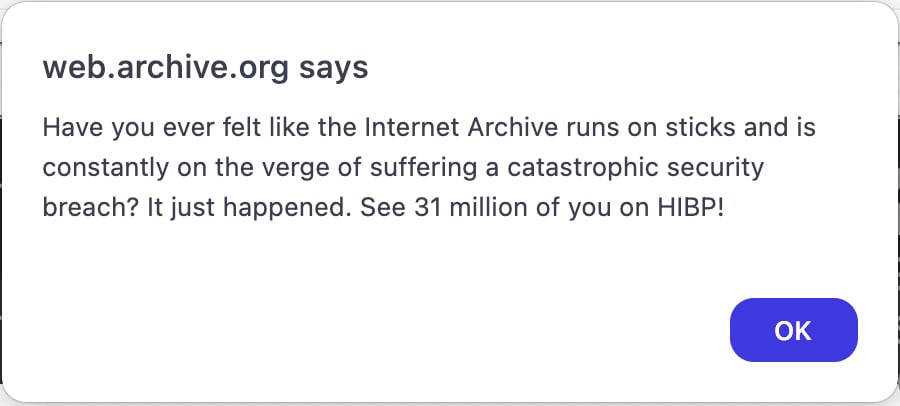
Впервые о возможном взломе заговорили в среду, когда ряд посетителей archive.org обратил внимание на нетипичный JavaScript-алерт, размещённый, судя по всему, взломавшими сайт киберпреступниками.

«У вас когда-нибудь было ощущение, что “Архив Интернета“ работает на костылях и буквально находится на грани взлома? Вот он и произошёл. Ищите информацию об утечке ваших данных на HIBP (сервис по отслеживанию утечек Have I Been Pwned — прим. Anti-Malware.ru)», — гласило уведомление.


Создатель Have I Been Pwned Трой Хант подтвердил изданию BleepingComputer, что злоумышленники девять дней назад действительно поделились аутентификационной базой. На деле это был SQL-файл с именем «ia_users.sql» и весом 6,4 ГБ.

В файле содержалась информация о зарегистрированных пользователях, включая адреса электронной почты, имена, временные метки изменения паролей, захешированные Bcrypt пароли и другие сведения.

Последняя временная метка датируется 28 сентября 2024 года, что должно указывать на примерную дату взлома «Архива Интернета». Хант также отметил, что в БД содержатся 31 млн уникальных имейл-адресов.

Создатель Have I Been Pwned на днях отправил всю необходимую информацию представителям НКО.

Подпишитесь на новости

Фото из Яндекс Диска предложили вытаскивать отдельной утилитой

Облако должно избавлять от возни с файлами. Но иногда для возвращения собственного фотоархива приходится искать отдельную программу. Пользователь Хабра verimash представил инструмент для скачивания фотографий и видео из «Яндекс Диска», включая раздел безлимитной автозагрузки, на фоне проблем с доступностью файлов.

Согласно описанию автора, если оригинал фотографии недоступен, программа пытается получить другую доступную версию изображения.

Здесь важное ограничение: уменьшенная копия может спасти сам снимок, но не вернуть исходное качество.

 

С видео сложнее. Утилита пытается загружать доступные фрагменты, однако итоговый файл может оказаться неполным или повреждённым.

 

Исходный код размещён на GitHub. При этом README описывает текущий вариант как прототип и перечисляет непроверенные элементы работы. Поэтому считать его готовым и гарантированным средством восстановления преждевременно.

Автор советует не удалять содержимое облака после выгрузки: доступ к оригиналам может восстановиться. Напомним, причиной недоступности части данных стали атаки на дата-центры Яндекса.

RSS: Новости на портале Anti-Malware.ru