



Искусственный интеллект стал частью бизнес-процессов и разработки, но вместе с ростом внедрения обостряется вопрос безопасности. Эксперты рынка в двух частях эфира AM Live обсудили, как контролировать теневой ИИ, чем опасны агенты, что меняется в DevSecOps и как начать обеспечение безопасности.
- 1. Введение
- 2. Часть I. Безопасное применение ИИ для бизнес-задач
- 2.1. Можно ли контролировать теневой ИИ
- 2.2. Справляются ли классические средства защиты с ИИ-угрозами
- 2.3. Несанкционированный доступ к ИИ-сервисам: блокировать, контролировать или маскировать
- 2.4. AI Firewall: функции, зрелость и снижение рисков
- 2.5. Агенты: главная поверхность атаки и вопрос цифровой идентичности
- 2.6. Блиц: что является следующей большой поверхностью атак в области ИИ?
- 2.7. С чего начать обеспечение безопасности ИИ
- 3. Часть II. Безопасное применение ИИ в разработке
- 3.1. Что меняется в разработке с приходом ИИ-агентов
- 3.2. Что опаснее: утечка кода или уязвимости в нём
- 3.3. Куда смотреть в первую очередь: теневой ИИ и разработчик
- 3.4. Агенты, харнесы и мутирующая среда
- 3.5. Что меняется в DevSecOps-конвейере с приходом ИИ
- 3.6. Прогнозы: что будет через два года и какие решения окажутся ошибкой
- 4. Выводы
Введение
Искусственный интеллект перестал быть экспериментом — он стал частью бизнес-процессов и разработки. Вместе с ростом внедрения обостряется вопрос, который долгое время оставался на втором плане: как сделать ИИ безопасным, как контролировать доступы и когда включать системы защиты. Если тема того, где ИИ даёт эффект, обсуждается широко, то безопасность долгое время была обделена вниманием, и на практике можно наблюдать весь спектр подходов — от полного запрета до бесконтрольного разрешения.
На практике контроль над ИИ остаётся фрагментарным: реестры сервисов неполны, теневые сервисы продолжают использоваться, а классические средства защиты не покрывают новые векторы атак. Агенты получают избыточные права, разработчики используют инструменты в обход политик, а модели способны переписывать собственную среду. Безопасность ИИ требует не запретов, а выстраивания процессов, контроля на всех этапах и понимания того, где последствия ошибки становятся критическими.
Часть I. Безопасное применение ИИ для бизнес-задач
В первой части эфира эксперты обсудили безопасное применение ИИ для бизнес-задач: можно ли контролировать теневой ИИ, справляются ли классические средства защиты с новыми угрозами, что должно быть в AI Firewall, какие угрозы несут агенты и с чего начать обеспечение безопасности.
Рисунок 1. Участники первой части эфира
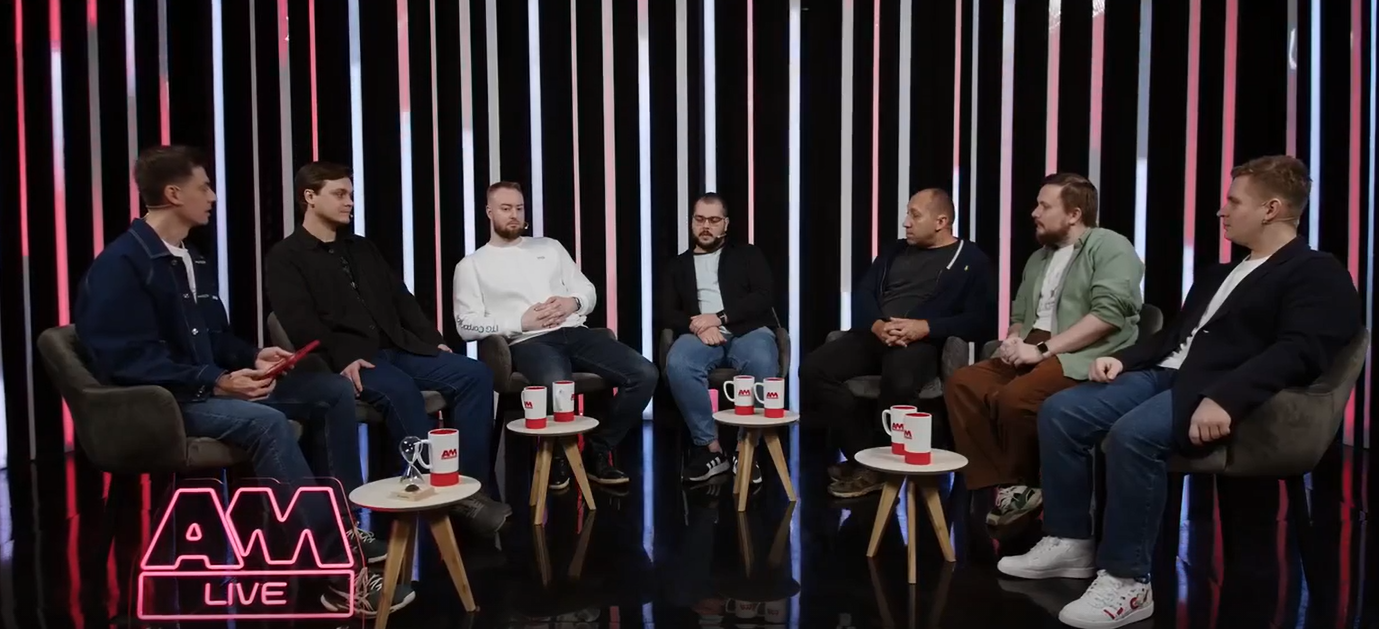
Участники первой части эфира:
- Максим Князев, старший системный инженер, «К2 Кибербезопасность».
- Николай Куликов, руководитель направления сетевой безопасности клиентского сервиса, ГК «Солар».
- Алексей Беляков, руководитель направления развития решений по предотвращению онлайн-мошенничества, «Лаборатория Касперского».
- Денис Каракай, владелец продукта «Гарда» AI Security, «Гарда».
- Вячеслав Валькович, руководитель развития облачных AI-сервисов, ITGLOBAL.COM, корпорация ITG.
- Никита Беляевский, руководитель отдела аудита безопасности ИИ-систем, HiveTrace.
Ведущий и модератор эфира — Илья Самофеев, исполнительный директор, red_mad_robot.
Можно ли контролировать теневой ИИ
Максим Князев считает, что реестр должен быть довольно полным — одного описания сервиса недостаточно. Если сотрудник изначально использовал внутренний ИИ-сервис только для написания текста, а затем разработчики добавили возможность работать с файлами, сотрудник может начать отгружать туда документы, содержащие коммерческую тайну, а эта функция не была задекларирована при внесении сервиса в реестр.
По совместному исследованию «К2 Кибербезопасность» и «Лаборатории Касперского», примерно 38% опрошенных уже используют внутренние команды для разработки собственных ИИ-сервисов. При этом внутренние разработчики не обязательно используют собственные модели — скорее всего, они задействуют чужие.
Поэтому записать в реестр название ИИ-сервиса недостаточно: нужно понимать, какие риски возникнут при его отказе и какие у него есть ограничения. Около 43% компаний предполагают, что при отказе используемых ИИ-сервисов они продолжат работать, но с потерями, а примерно 11% респондентов считают последствия критическими.
Реестр вести нужно, но главное — как это делать. Нужно определять четыре функции: описание самого ИИ-сервиса, владельца этого сервиса, стек, на котором он был собран, ограничения этого сервиса и возможные риски при отказе.
Максим Князев, старший системный инженер, «К2 Кибербезопасность»
Алексей Беляков заметил, что существенный рост запроса на решения по защите ИИ произошёл во второй половине текущего года. Если год назад на вопрос о необходимости ИИ заказчики отвечали, что не понимают, о чём речь, и не видят потребности, то сейчас этот вопрос звучит практически на каждой встрече с ИБ и разработчиками — в госструктурах, у регуляторов, в банках и промышленности. Есть возможность сократить путь и не повторять ошибок, используя уже накопленный в мире опыт и проходя стадии зрелости защиты ИИ быстрее.
Денис Каракай согласился, что составить полный список теневых ИИ крайне сложно. В идеальном случае компании создают единую точку входа — приложение, через которое сотрудники используют ИИ. Но на практике часто просто блокируют всё, не задумываясь, что сотрудники пойдут в другой сервис или с личного аккаунта, и данные всё равно будут утекать, только другими путями. Поймать все теневые ИИ-сервисы, которые используют сотрудники, невозможно.
Алексей Беляков добавил аспект, который часто уходит из внимания — концепцию BYOD (Bring Your Own Device). Есть контролируемая корпоративная среда, но инициативный сотрудник принёс свой ноутбук, попал в неконтролируемую среду и делает там что хочет: таскает данные скриншотами, с флешки, подключаясь к корпоративной сети. Этот аспект тоже нужно контролировать, но контроль должен осуществляться так, чтобы люди не уходили ещё глубже в тень.
Алексей Беляков, руководитель направления развития решений по предотвращению онлайн-мошенничества, «Лаборатория Касперского»
Справляются ли классические средства защиты с ИИ-угрозами
Николай Куликов отметил, что за последние 30–40 лет появилось огромное количество классов решений, обеспечивающих безопасность инфраструктуры. Создание реестра он сравнил с использованием небольшого фонарика в огромной чёрной комнате: реестр — это понятный трек, где мы отсматриваем угрозы только там, где светло, а что находится в темноте — неизвестно. Для подсветки угроз существуют разные классы решений, но затолкать всё в одну коробку непродуктивно. При этом в текущем виде этих решений явно недостаточно.
Аналогичная ситуация была с UTM: класс решений существовал и выполнял фильтрацию, пока не появились угрозы на уровне сетевых атак. Тогда добавили дополнительные модули и получили NGFW. Та же концепция сейчас перетекает в другие классы решений, которые адаптируются к защите от ИИ-угроз. Заказчики приходят и говорят, что у них уже что-то есть и они хотят это использовать для защиты, и приходится выдумывать сценарии применения.
Вячеслав Валькович добавил, что реестр — это не разово составленный документ, а динамический объект, который должен постоянно пополняться. Не стоит стремиться к идеальному результату: достаточно хорошо отслеживать общую ситуацию по теневому ИИ в компании. Если закрыта большая часть подписок и сервисов, работающих с ИИ, это уже хороший результат. Что касается решений, их много, но для полного закрытия вопросов с ИИ в текущем виде их недостаточно, потому что при разговоре с моделями мы общаемся на другом языке, который текущие инструменты пока понимать не могут.
Он видит развитие в сторону панели управления информационными потоками, а также точечных модулей, которые защищают от промпт-инъекций, промпт-инъекций, атак на MCP-серверы и угроз, связанных с агентами. Как самостоятельный продукт AI Firewall со временем уйдёт в небытие, потому что многофункциональность будет встроена в те продукты, которые компании уже используют.
Илья Самофеев отметил, что техническая составляющая защиты ИИ — широкая область, и рынок только проходит стадию, когда начинают вырисовываться продукты: два-три года назад ещё думали, как пользоваться большими языковыми моделями, а агентов толком не было.
Илья Самофеев, исполнительный директор, red_mad_robot
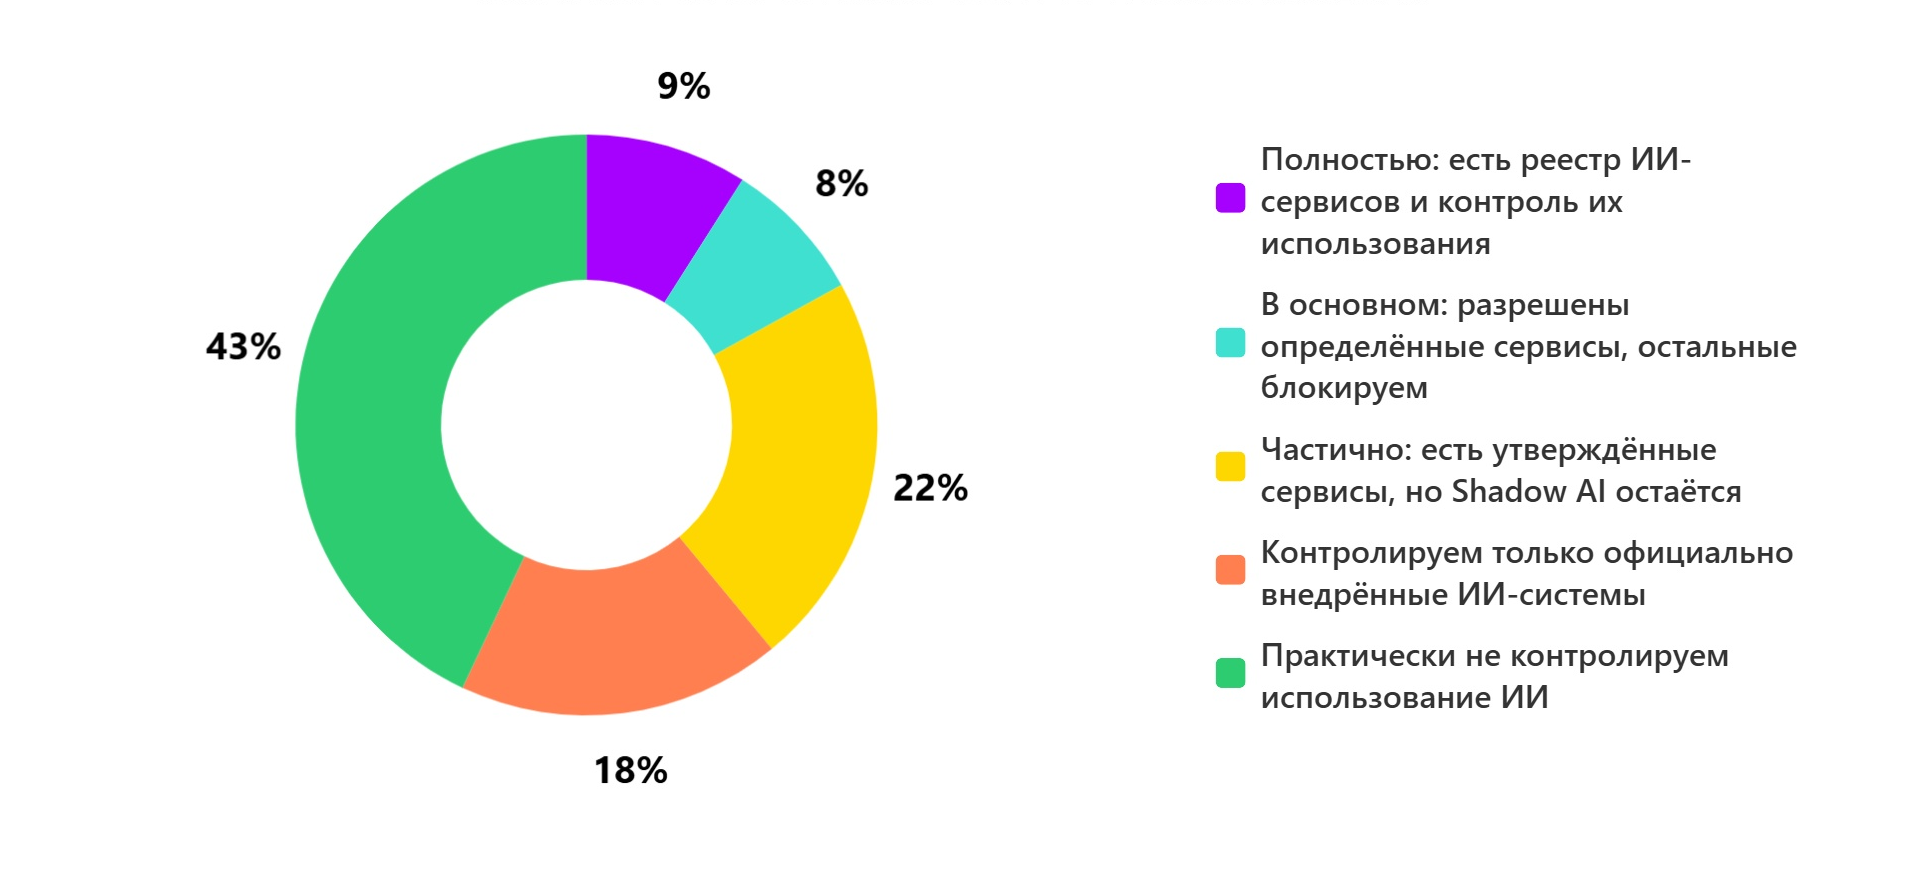
В первом опросе зрители ответили, насколько они контролируют использование ИИ в компании:
- Практически не контролируют использование ИИ — 43%.
- Частично: есть утверждённые сервисы, но Shadow AI остаётся — 22%.
- Контролируем только официально внедрённые ИИ-системы — 18%.
- Полностью: есть реестр ИИ-сервисов и контроль их использования — 9%.
- В основном: разрешены определённые сервисы, остальные блокируем — 8%.
Рисунок 2. Насколько вы контролируете использование ИИ в компании?
Несанкционированный доступ к ИИ-сервисам: блокировать, контролировать или маскировать
Денис Каракай считает, что доступ надо контролировать — это идеальный сценарий. Если компания получает трафик от пользователя к внешнему сервису, нужно перехватить его, проанализировать, что отправляется, и в идеале заблокировать и подменить ответ модели. Это можно сделать даже средствами стандартных модулей вроде DLP. AI Firewall контролировать это может лишь ограниченно, поэтому он должен стать центральной точкой, где собираются все источники. Если компания искренне боится, что сотрудники обойдут ограничения, тогда блокировать и создавать единую точку входа для всех LLM, включая локальные и внешние.
Никита Беляевский уверен, что запретить всё невозможно, нужен компромисс. Сотрудникам нужно предоставить лучшую альтернативу тому, что у них есть, и которую компания контролирует. Можно даже оставить внешний сервис, но поставить DLP-систему, которая проверяет важные для бизнеса значения, чтобы они не утекали во внешнюю среду. Если у сотрудников будет такая альтернатива, они не будут уходить в теневые сервисы.
Никита Беляевский, руководитель отдела аудита безопасности ИИ-систем, HiveTrace
Алексей Беляков предложил альтернативный подход, исходящий из опыта: прежде всего стоит задать вопрос, кто заказчик. Универсального ответа не существует: то, что приемлемо для коммерческой организации или компании-разработчика ПО, абсолютно неприемлемо для объекта критической инфраструктуры или промышленного предприятия, где в контуре крутятся станки и промышленный интернет вещей.
AI Firewall: функции, зрелость и снижение рисков
Вячеслав Валькович считает, что AI Firewall прежде всего должен быть control plane, в который стекается информация о действиях пользователя, без этого всё остальное не имеет смысла. Далее — промпт-инъекции, попытки джейлбрейка, попытки вытащить системный промпт, работа с агентами и MCP.
Эксперт напомнил про RAG, который сейчас является одним из самых часто используемых способов применения ИИ в компаниях — его защита тоже хорошо ложится на AI Firewall. Туда же могут входить антивирусные политики, защита моделей, модули сканирования моделей и LoRA. База — control plane, промпт-инъекции и защита агентов. Агентская безопасность — следующий этап развития, и упор надо делать именно туда, поскольку агенты могут сильно навредить компании.
О зрелости таких продуктов Вячеслав ответил, что это MVP: решения есть у отдельных игроков, но они бурно развиваются, векторы атак постоянно дополняются, поэтому полностью зрелыми в условиях взрывного роста ИИ они быть не могут. Продукт будет постоянно дополняться и, скорее всего, по кусочкам будет растворяться в других решениях.
Вячеслав Валькович, руководитель развития облачных AI-сервисов, ITGLOBAL.COM, корпорация ITG
Алексей Беляков отметил подход CrowdStrike, который в основу решений по защите ИИ положил набор SDK от Pangea, дающий разработчику глубокий контроль над тем, что происходит в модели. Критична возможность тонкого обучения LLM–файрвола, особенно если он содержит не просто регулярные выражения, а модуль с LLM, который тоже должен действовать прогнозируемо: основная проблема — непрогнозируемое время ответа, а для файрвола это значимый параметр.
Многие борются с большим количеством false positive, и пока неясно, что с ними делать. Поэтому любое внедрение LLM–файрвола содержит элементы консалтинга, а решение нужно донастраивать под специфику заказчика. LLM–файрвол не может полностью решить вопрос защиты агентов — это другой уровень: принципы Zero Trust, изоляция на уровне контейнеров или виртуальных машин. Ни у одного вендора, даже у топовых зарубежных, нет полностью слитного сценария: на конкретном заказчике будет комбинация множества сервисов — от зрелых до стартапов, MVP и in-house-разработки.
Максим Князев согласился, что универсальных инструментов ИБ не существует, это всегда комбинация подходов. У заказчиков есть своя позиция — понимание того, что они хотели бы защищать. Когда приходишь с LLM–файрволом и показываешь маскирование ФИО или банковской тайны, заказчик может ответить, что это ему не надо, а надо определять собственные документы, которые он считает коммерческой тайной, и маскировать данные в них. В таких случаях решение приходится дорабатывать под требования заказчика.
Алексей Беляков высказал мысль, что через два года продуктов может не быть вообще — решения будут собираться динамически, пересобираясь каждый вечер с учётом нового опыта со всего мира. Понятие зрелого продукта может исчезнуть как класс.
Николай Куликов добавил, что считать LLM–файрвол стандартом сложно и неправильно: он пытается работать с инструментами, технологиями и протоколами, которые ещё не все описаны. Сложно считать стандартом то, что ещё не работает со стандартом как таковым.
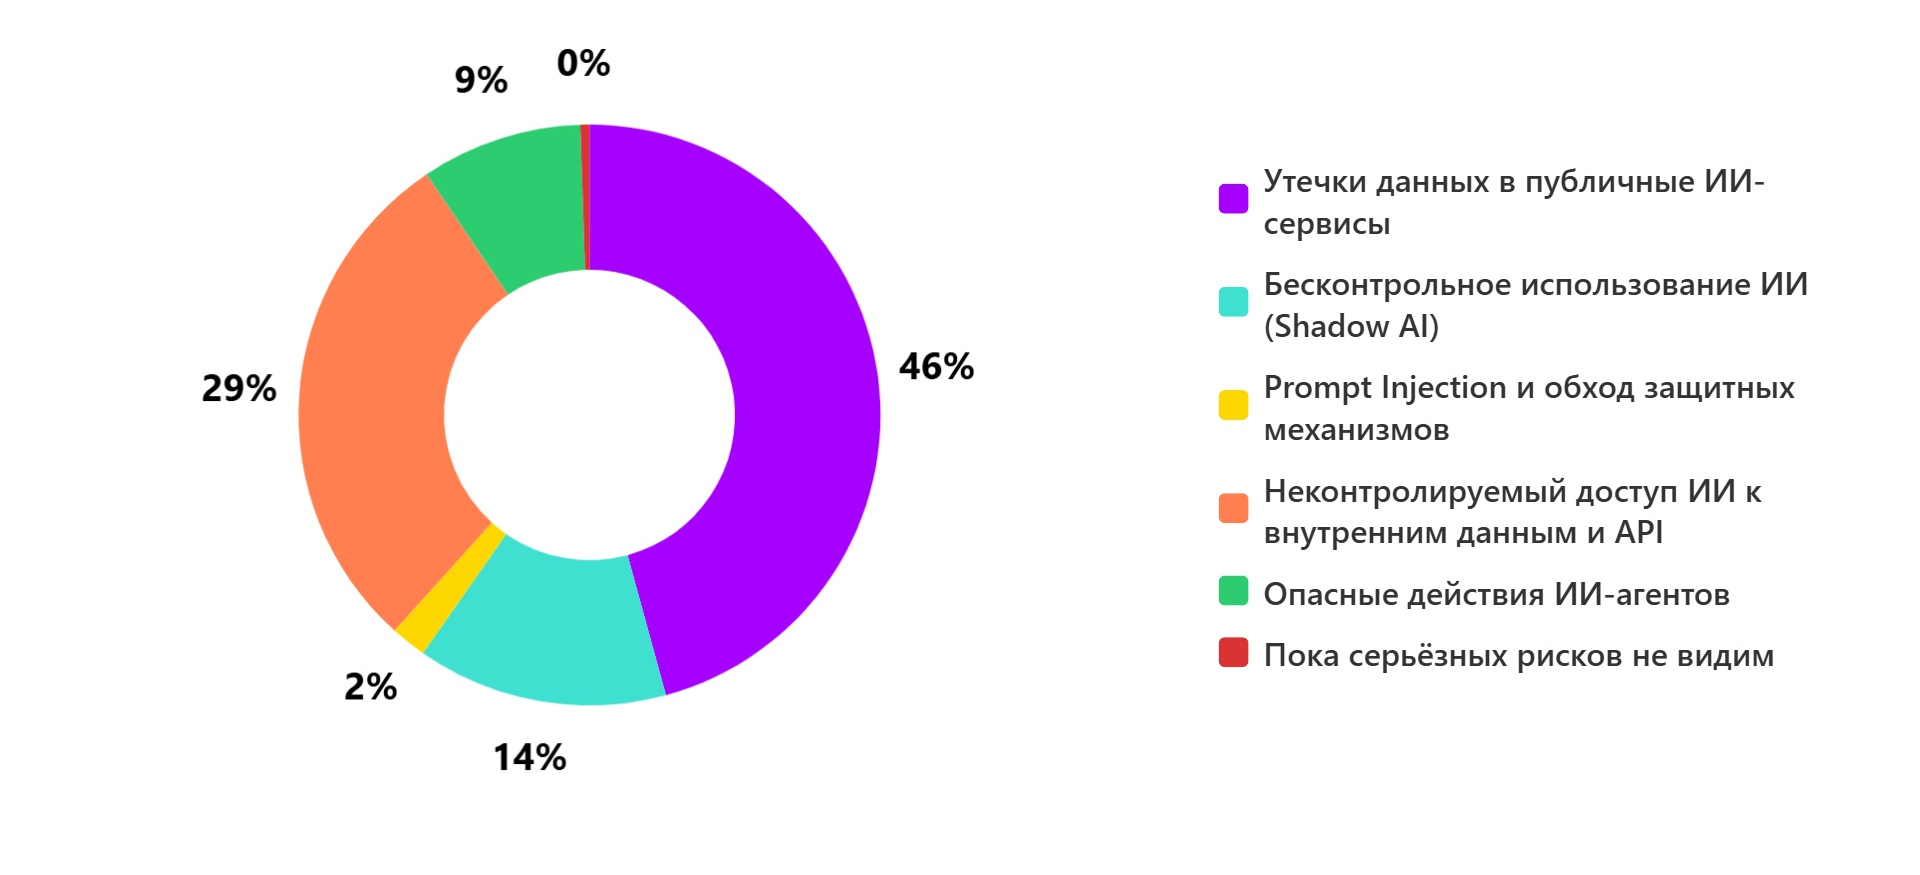
Во втором опросе зрители поделились мнением о том, что представляет наибольшую угрозу кибербезопасности при использовании ИИ в их организации:
- Утечки данных в публичные ИИ-сервисы — 46%.
- Неконтролируемый доступ ИИ к внутренним данным и API — 29%.
- Бесконтрольное использование ИИ (Shadow AI) — 14%.
- Опасные действия ИИ-агентов — 9%.
- Prompt Injection и обход защитных механизмов — 2%.
- Пока серьёзных рисков не видят — 0%.
Рисунок 3. Какова наибольшая угроза кибербезопасности при работе с ИИ в вашей организации?
Агенты: главная поверхность атаки и вопрос цифровой идентичности
Максим Князев привёл исследование, проведённое в Цюрихе, в котором реализовали среду с агентами, у которых есть доступ к инструментам. Проблема — внедрение вредоносных действий в легитимные сценарии: у агента есть долгосрочная память с уже помещёнными инструкциями, которые в целом легитимны. Если злоумышленник атакует эти инструкции и внедряет вредоносное действие, агент его выполнит. Адекватной защиты от этого пока нет. То же самое происходит на уровне триажа уязвимостей с помощью ИИ: внутренний злоумышленник может убедить модель, что уязвимость не является уязвимостью, внедрив инструкцию в сам код, и модель пропустит эксплуатируемую уязвимость.
Алексей Беляков добавил класс проблем, связанных со скоростью работы. Агентов может быть много — рой, и они могут работать с запредельной скоростью, с которой человек не может анализировать их действия и что-то предотвращать. Даже классические детерминистические защитные системы могут не справляться и получать перегрузку. Поэтому в некоторых сценариях придётся прийти к необходимости искусственного замедления работы агентов, чтобы сопутствующие системы успевали реагировать.
Агент — это полуразумная сущность, которая может иметь подобие собственной воли, и вопросы идентификации его намерений — краткосрочных и долгосрочных, синхронизации с волей конкретных людей — становятся важными. Мы начинаем жить с принципиально другой скоростью, на которую ни мы, ни инфраструктура не рассчитаны.
Вячеслав Валькович сравнил агента с сотрудником компании: тот, кто управляет агентами, — как тимлид, который ставит задачи сотрудникам. За действия сотрудника компания отвечает, поэтому несёт риски широкого набора прав у агентов. Проблема агента в том, что он может действовать крайне быстро — с той скоростью, на которую человек реагировать не может. Нужно относиться к агенту так же, как к сотруднику: если есть подозрения, что сотруднику не стоит доверять, нужно ограничивать его.
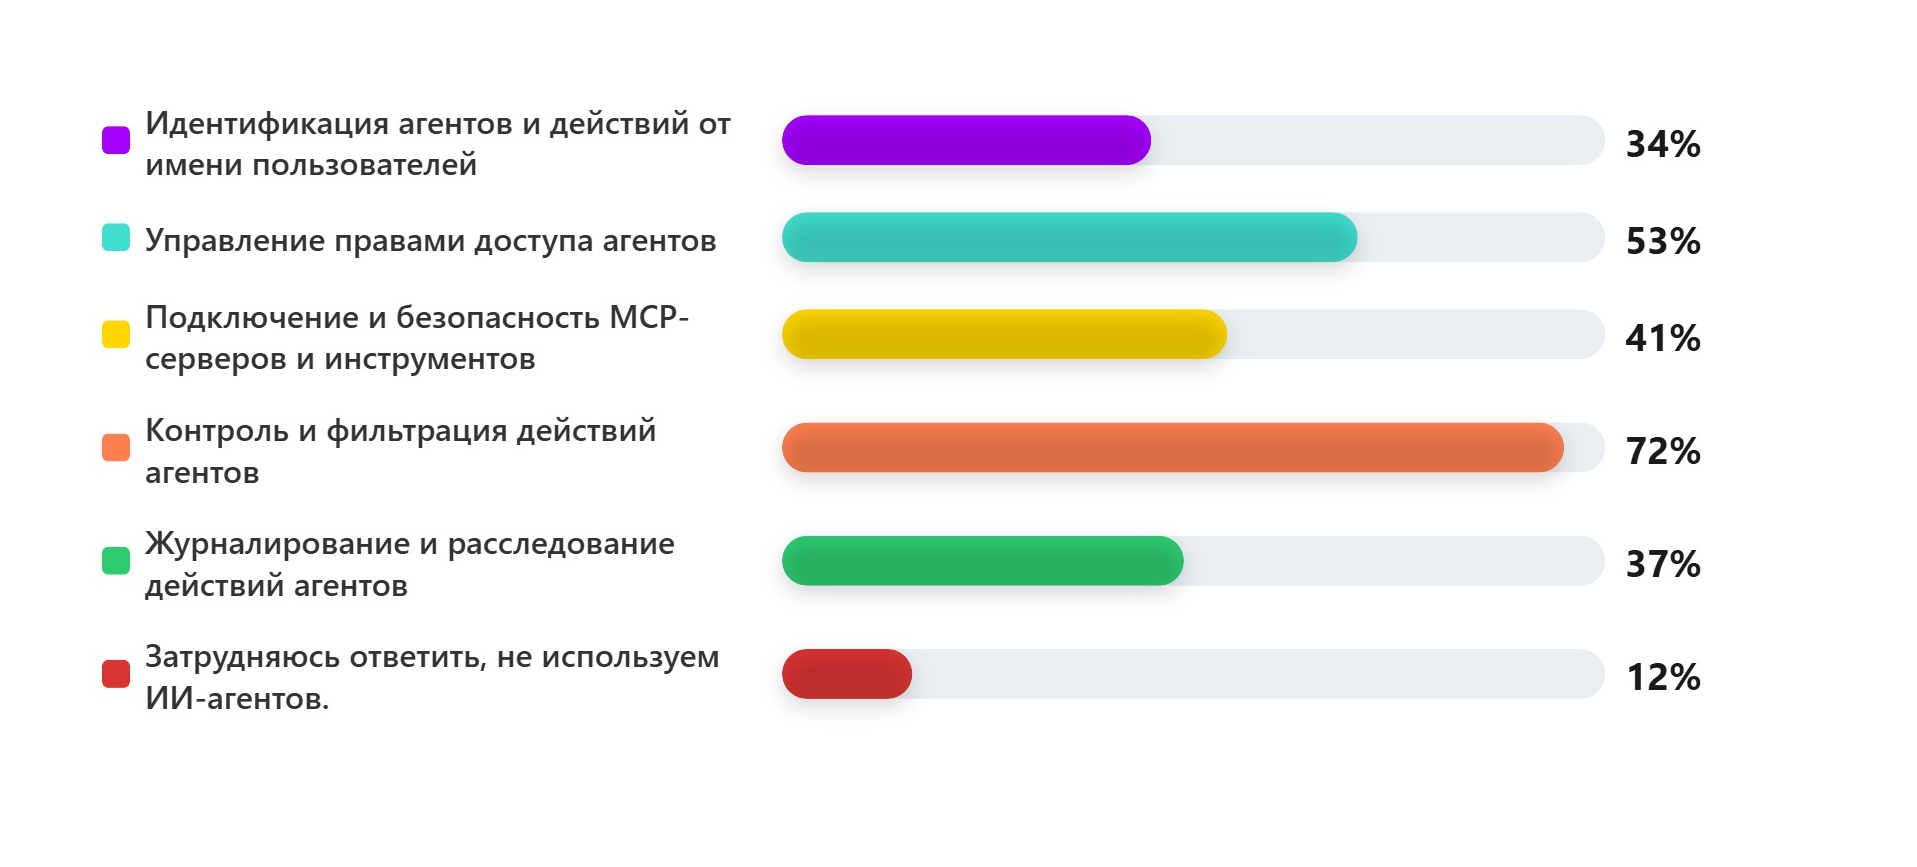
В третьем опросе выяснилось, что вызывает у зрителей наибольшие сложности для кибербезопасности при внедрении ИИ-агентов (мультивыбор):
- Контроль и фильтрация действий агентов — 72%.
- Управление правами доступа агентов — 53%.
- Подключение и безопасность MCP-серверов и инструментов — 41%.
- Журналирование и расследование действий агентов — 37%.
- Идентификация агентов и действий от имени пользователей — 34%.
- Затруднились ответить, не используют ИИ-агентов — 12%.
Рисунок 4. Что сложнее для кибербезопасности при внедрении ИИ-агентов?
Блиц: что является следующей большой поверхностью атак в области ИИ?
Никита Беляевский:
«Кодинговые агенты. Они допускают функциональные ошибки не потому, что их подтолкнули злоумышленники, а сами по себе, и такие ошибки сложно проверять. Смысл агента в том, что он должен работать автономно и его не нужно проверять, но генерируется код с ошибками, и проверять его приходится самим».
Вячеслав Валькович:
«Пусть это будет MCP».
Алексей Беляков:
«Социальная инженерия с учётом профиля личности атакуемого. Комбинация социальной инженерии с действиями агентов, которые будут погружать человека в сконструированную реальность, где он будет получать подтверждения негативного развития ситуации. Через год это уже может быть реальностью».
Денис Каракай:
«Кодинговые агенты станут огромным риском — мы слишком им доверяем, и непонятно, как контролировать результат. Но более глобально — это инфраструктура агентов: они вызывают субагентов, которые вызывают набор инструментов, и пока непонятно, как сохранять целостность всего этого пути. Агенты быстро растут, и придётся научиться отслеживать весь путь бесконечных вызовов».
Николай Куликов:
«Хранилище. Агент, работая с сущностью, обращается в контекст, и любые данные, которые пользователи отправляют в промптах, где-то хранятся. Любой агент при поиске нужных данных придёт в абстрактное хранилище — как открытые чаты можно проиндексировать в поисковике, так и агент может забрать персональные данные и переписки. Контролировать это сложно, потому что всё децентрализовано и нет единой целостной картины».
Николай Куликов, руководитель направления сетевой безопасности клиентского сервиса, ГК «Солар»
Никита Беляевский:
«Ещё окружение агента — файлы, инструкции, исполняемые файлы — напрямую влияют на его действия. Если рядом с бинарником лежит его источник, агент сравнивает библиотеки и функции и решает, что бинарник можно запустить, хотя в нём может быть вредоносная строка. Есть примеры, когда агенты это выполняют».
Максим Князев:
«Согласен по кодинговым агентам, долговременной памяти и вредоносным инструкциям, вплетённым в легитимный сценарий. Отдельно отмечу интернет вещей: IoT сам по себе небезопасен, а с добавлением моделей машинного обучения на устройствах возникает комбинированная атака — и на модель, и на устройство. Точек входа может быть много, и в таком мире нам предстоит жить».
С чего начать обеспечение безопасности ИИ
Максим Князев:
«Начать с обучения пользователей и сотрудников: половина всех проблем в информационной безопасности находится по ту сторону экрана монитора. Если человеку не объяснить, какие риски влечёт передача конфиденциальных данных на серверы внешних моделей, его нельзя винить — это не входит в его обязанности. Сначала обучение, а уже дальше — LLM–файрволы и локальные модели».
Николай Куликов:
«Начать с аудита. Это нулевая точка, где определяется поверхность взаимодействия. Далее формируется контролируемая среда: отрезать на файрволе или SIEM нелегитимные ресурсы, а для разрешённых организовать безопасный контур — DLP, фильтрацию по ключевым словам и регулярным выражениям. Когда среда сформирована, можно проанализировать, в какую сторону двигаются пользователи, и тогда проводить обучение».
Алексей Беляков:
«Вопросы использования и безопасности ИИ хорошо усваиваются, когда рядом есть доверенный человек или консалтинговая компания, которая уже знает, как это делать. Найти экспертов, которые подсветят, как лучше для конкретной задачи и индустрии. Важно фундаментальное образование. Внедрение и защита ИИ должны идти через общение с людьми и организациями, которые продвинулись чуть дальше».
Денис Каракай:
«Первое — найти того, кто поможет. Нельзя начать аудит, пока нет экспертизы о том, что мы знаем об ИИ и как сотрудники им пользуются. Дальше — обучение, аудит и матрица рисков».
Денис Каракай, владелец продукта «Гарда» AI Security, «Гарда»
Вячеслав Валькович:
«Сначала понять, зачем вообще нужен ИИ. Если компания — субъект КИИ, одни требования, если стартап — другие. Внутри своей организации мы начали активно проводить AI Awareness и Security Awareness — обучение является одним из первых шагов, чтобы сотрудники могли эффективно работать с ИИ, а дальше можно заносить его в реестры и ограничивать».
Никита Беляевский:
«Взять и недельку поработать с агентом без остановки — посмотреть разницу, что было и что стало. Потом предложить коллеге попробовать и сравнить. Ходить, обсуждать, смотреть. Показательно, что филологи хорошо работают с моделями: у них есть фундамент понимания языка».
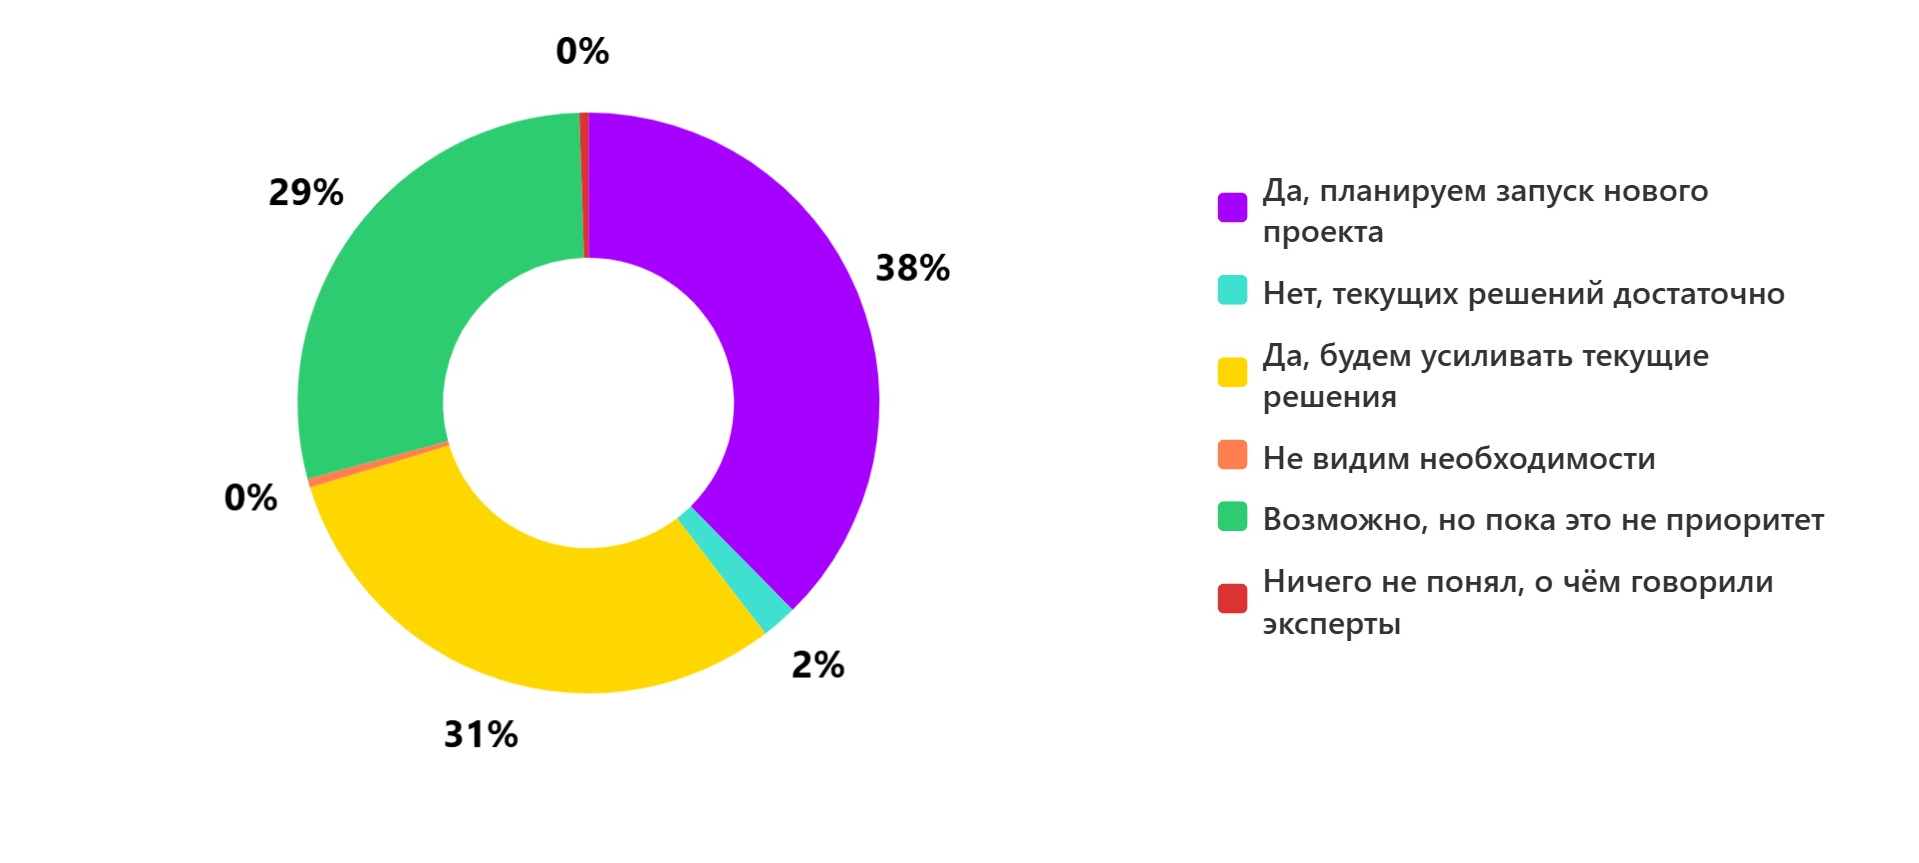
Четвёртый опрос показал, планируют ли зрители после эфира запускать или развивать проекты по безопасности ИИ:
- Планируют запуск нового проекта — 38%.
- Будут усиливать текущие решения — 31%.
- Возможно, но пока это не приоритет — 29%.
- Текущих решений достаточно — 2%.
- Не видят необходимости — 0%.
- Ничего не поняли, о чём говорили эксперты — 0%.
Рисунок 5. Планируете ли вы после эфира запускать или развивать проекты по безопасности ИИ?
Часть II. Безопасное применение ИИ в разработке
Во второй части эфира эксперты обсудили безопасное применение ИИ в разработке: что меняется в процессе с приходом кодинговых агентов, что опаснее — утечка кода или уязвимости в нём, как контролировать мутирующие харнесы, что меняется в DevSecOps-конвейере и какие решения в безопасности окажутся ошибкой.
Рисунок 6. Участники второй части эфира
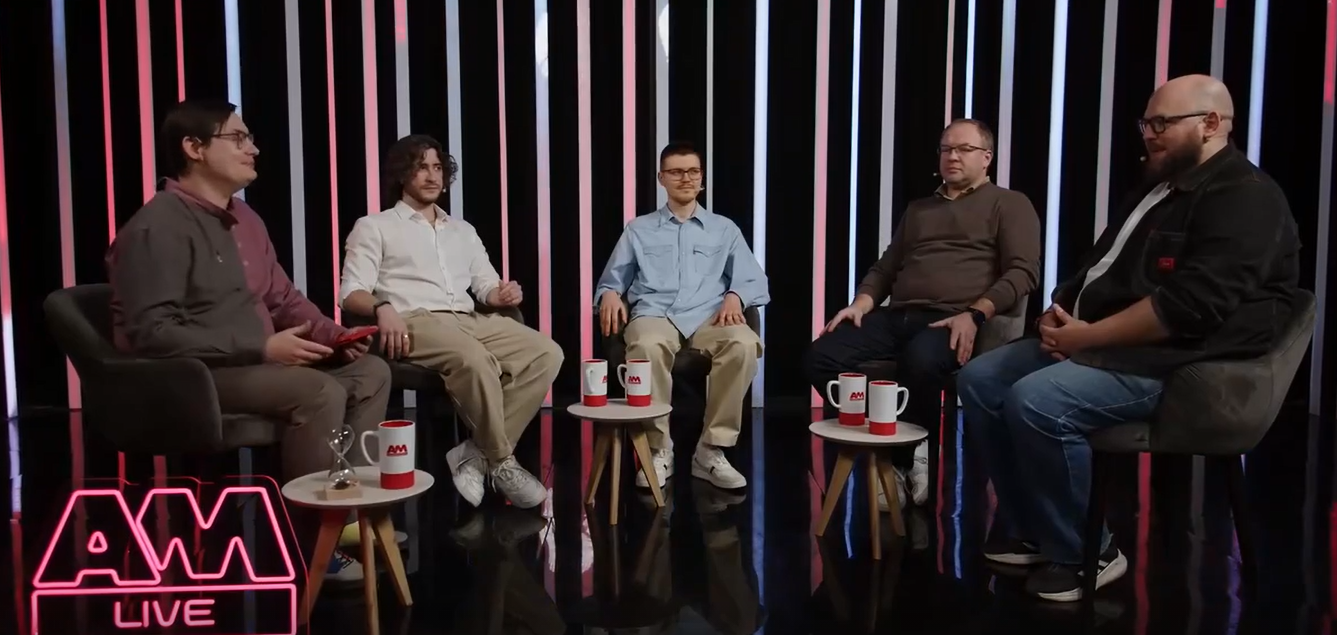
Участники второй части эфира:
- Михаил Кобик, основатель и технический директор платформы «Боцман», директор по продукту Astra Dev Platform, Группа Астра.
- Дмитрий Шмойлов, руководитель отдела безопасности программного обеспечения, «Лаборатория Касперского».
- Артур Хашаев, директор по разработке, Группа компаний SolidLab.
- Михаил Черешнев, ведущий инженер по искусственному интеллекту и безопасности, AppSec Solutions.
Модератор эфира — Андрей Жуков, ведущий консультант, Faust.
Что меняется в разработке с приходом ИИ-агентов
Дмитрий Шмойлов считает, что схема не изменилась: пока код разрабатывается, ответственность за него лежит на компании — это основной принцип разработки вне зависимости от того, кто или что стоит за созданием кода. Если придёт возмущённый клиент с уязвимостью, указать на LLM не получится.
Кода становится больше: один грамотный разработчик, работающий с ИИ, может заменить команду, но процессы проверки качества должны оставаться прежними. Другой вопрос, что их можно автоматизировать теми же агентами.
Михаил Кобик поддержал аналогией: ИИ — это катализатор, который что-то ускоряет. Но если на входе не цветочек, а удобрение, то ты получишь в 20 раз больше удобрения. Поэтому критически важно, как выстроен процесс разработки и насколько автоматизировано тестирование — не только юниты, но и security-тесты. По его опыту, люди, занимавшиеся ручным тестированием, в том числе security-практиками, становились самыми жёсткими узкими местами в процессе разработки, когда компания активно перешла на агентскую разработку.
Михаил Кобик, основатель и технический директор платформы «Боцман», директор по продукту Astra Dev Platform, Группа Астра
Михаил Черешнев добавил, что процессы не изменились: по-прежнему требуется аудирование всего исходного кода и пакетов, которые разработчик публикует во внутренней архитектуре. Но добавляется специфика — инструменты, которые используют агенты, и теневой ИИ, несущий большую проблему для безопасности как со стороны разработчика, так и со стороны организации. Если раньше можно было согласовать определённую IDE для разработчиков крупной организации, то сейчас приходится разрешать конкретных агентов, инструменты и подходы.
Артур Хашаев напомнил принцип Фредерика Брукса: нет серебряной пули в разработке — техники, которая кратно улучшила бы эффективность, не требуя ничего взамен. Модульные тесты полезны как подушка безопасности, но требуют времени на написание, дополнительного кода и обучения. Точно так же с ИИ: агенты полезны и нужны, ускоряют продуктивных разработчиков, но требуют обучения, контроля и грамотного взаимодействия.
Андрей Жуков добавил, что ИИ мультиплицирует все несовершенства процесса и оргструктуры, а также проблемы, связанные с забытыми звеньями в цепочке — получаем троекратно ухудшенное качество там, где оно и так было плохим, и троекратно потерянные связи. От того, куда и как пускается ИИ, сильно зависит результат.
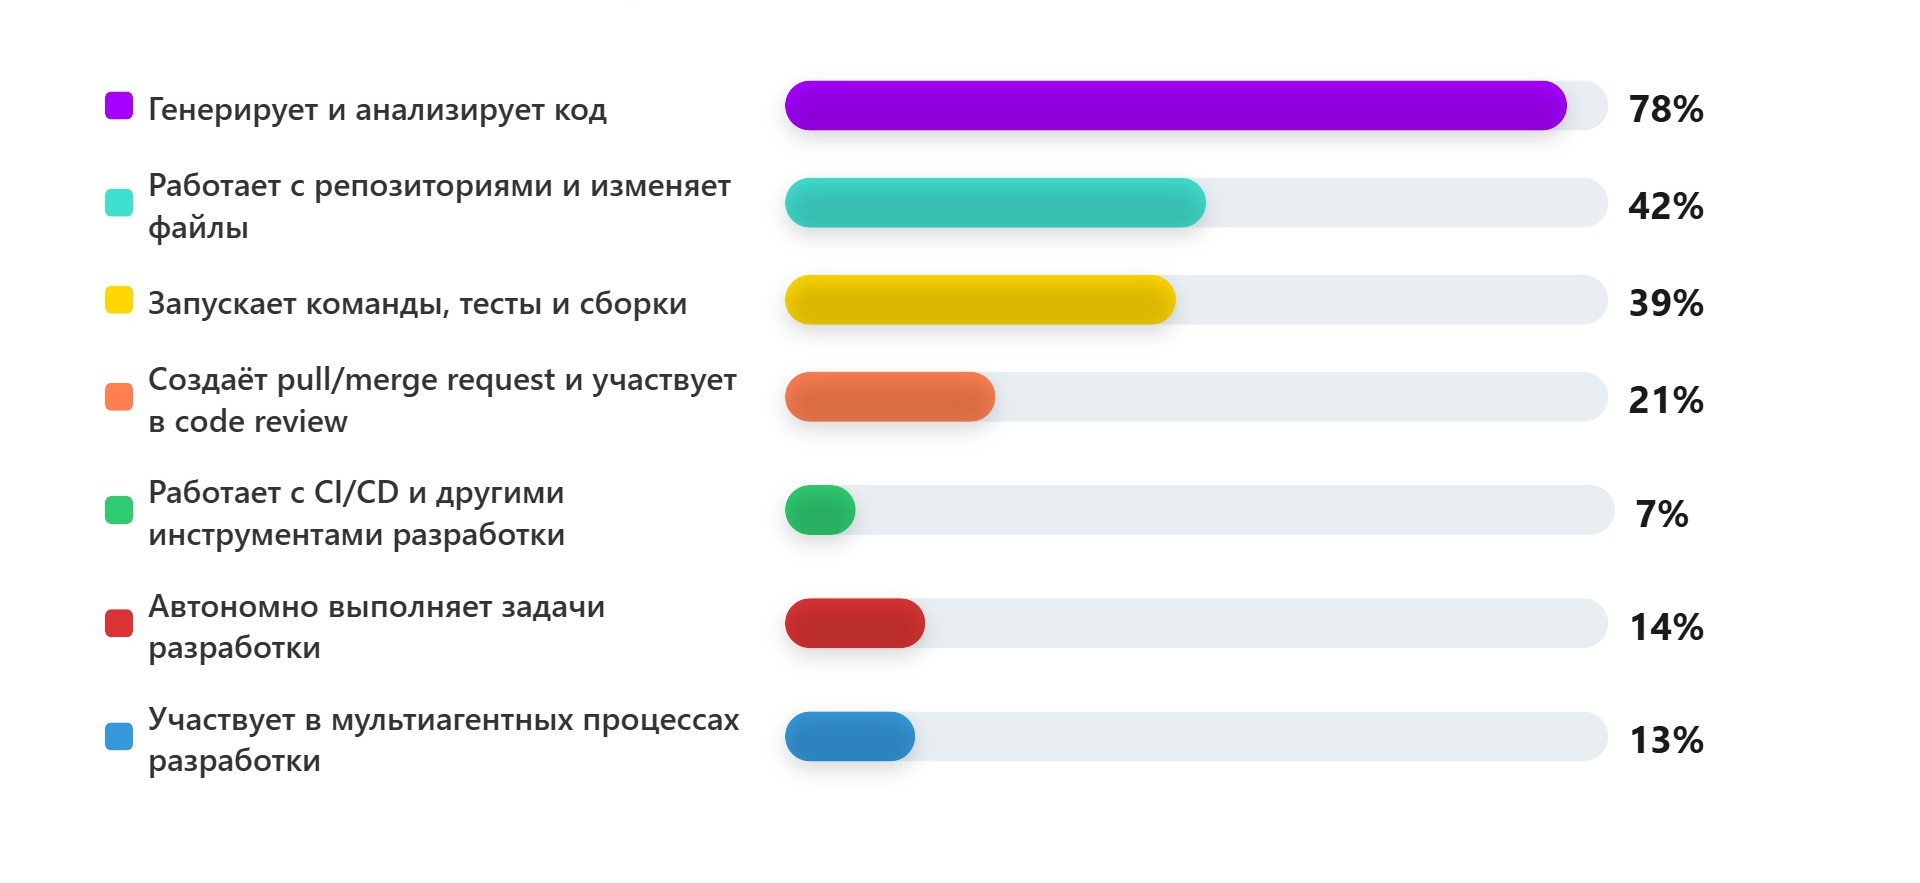
В первом опросе зрители поделились, до какого уровня ИИ уже допущен в их процесс разработки (мультивыбор):
- Генерирует и анализирует код — 78%.
- Работает с репозиториями и изменяет файлы — 42%.
- Запускает команды, тесты и сборки — 39%.
- Создаёт pull/merge request и участвует в code review — 21%.
- Автономно выполняет задачи разработки — 14%.
- Участвует в мультиагентных процессах разработки — 13%.
- Работает с CI/CD и другими инструментами разработки — 7%.
Рисунок 7. До какого уровня ИИ уже допущен в ваш процесс разработки?
Что опаснее: утечка кода или уязвимости в нём
Михаил Кобик считает, что массовое внедрение ИИ обесценило код: модель видела весь существующий в мире сгенерированный код, поэтому перестановка двух строк в типовом JSON концептуально ничего не меняет. Это стало заметно на моделях предпоследнего поколения, когда вокруг Fable поднялась шумиха о том, что ИТ умрёт. Следует разделять хайп и реальность: появление недетерминированной системы в продукте делает невозможной гарантию её поведения, что порождает новую модель угроз и новый вектор атак. Концептуально ничего не поменялось — как это был ИТ-продукт, так и остался, просто нужно больше контролировать.
Дмитрий Шмойлов уточнил тезис о том, что код ничего не стоит. Не весь код допустимо отдавать модели. Необходимо чётко классифицировать, выполняет ли код критически важные для продукта операции или представляет собой типовую перестановку JSON. Отдельную категорию составляет интеллектуальная собственность, например код в продуктах безопасности. Часть кода можно передавать модели, часть — нельзя. Также важно осознанно выбирать модели и инструменты. Правильнее говорить не только о коде, но и о данных: есть критичные, а есть те, передача которых не несёт риска.
Артур Хашаев добавил, что утечка необратима, а уязвимости всё-таки можно поймать на этапах жизненного цикла и исправить. Утекать может не только код: данные, переменные окружения, секреты, сетевая топология. Всё становится достоянием LLM-провайдера.
Нужны понятные правила игры для всех, кто занимается разработкой. У разных компаний разный риск-профиль: стартапу из 3–5 человек без разницы, что куда утечёт, а компании с интеллектуальной собственностью — нет. Банку может быть неважно, что код мобильного приложения утечёт, но важно, чтобы не утекла скоринговая модель. Каждая организация сама должна определить свой риск-профиль.
Артур Хашаев, директор по разработке, Группа компаний SolidLab
Михаил Черешнев поделился наблюдением: модель может собирать данные о поведении самого разработчика — по тому, как он пишет обращение к агенту, можно идентифицировать, кто над каким компонентом работал. Это один из векторов, который, например, у израильских коллег считается одним из самых серьёзных.
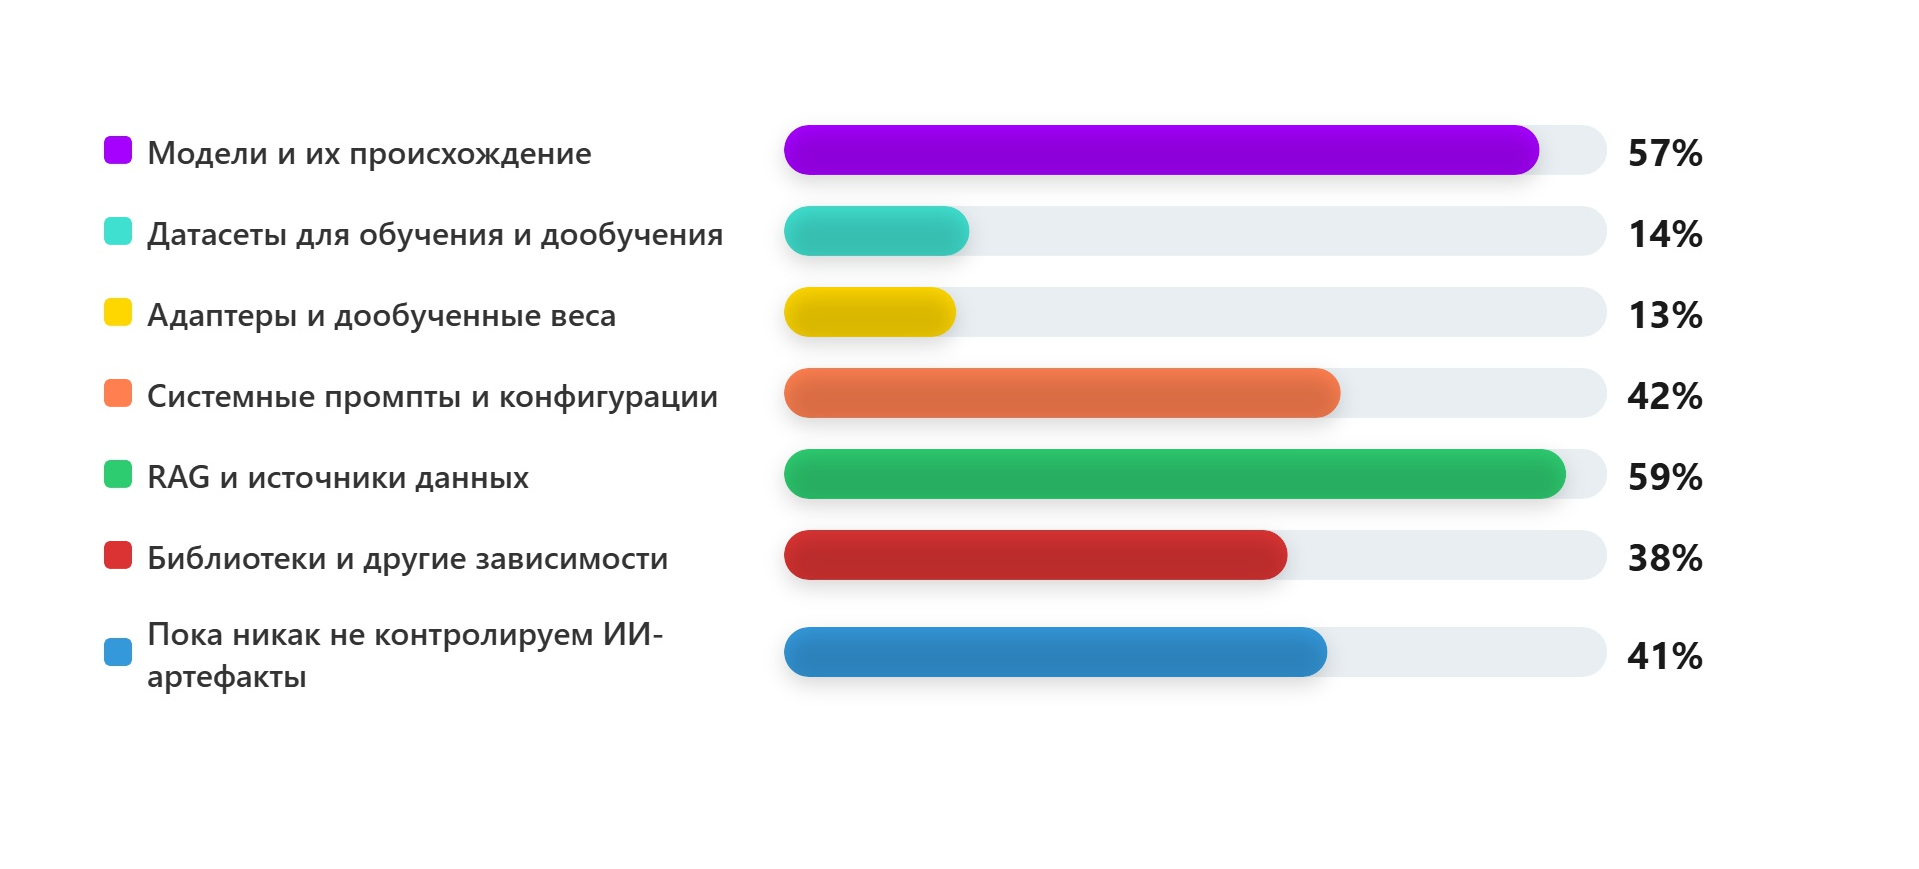
Во втором опросе зрители назвали компоненты ИИ-систем, которые они уже контролируют для защиты от атак на цепочки поставок (мультивыбор):
- RAG и источники данных — 59%.
- Модели и их происхождение — 57%.
- Системные промпты и конфигурации — 42%.
- Пока никак не контролируют ИИ-артефакты — 41%.
- Библиотеки и другие зависимости — 38%.
- Датасеты для обучения и дообучения — 14%.
- Адаптеры и дообученные веса — 13%.
Рисунок 8. Компоненты ИИ-систем, контролируемые для защиты от атак на цепочки поставок
Куда смотреть в первую очередь: теневой ИИ и разработчик
Михаил Черешнев предложил смотреть по этапам жизненного цикла: если раньше всё начиналось с кода, то сейчас первая точка проблем — сама идея и выбор инструментов. Если компания заявляет, что использует локальные модели и ничего не боится, но берёт модели уровня Qwen 3.8, стоит учитывать: такие модели хорошо помогают писать эксплойты — главное не затрагивать политику КНР. Это один из наиболее интересных векторов, который мало где учитывается.
Если разрабатываются системы с применением моделей, в процесс безопасной разработки добавляются специфичные артефакты: датасеты, источники данных, модели, веса. Рынок пока не сформировал инструменты, покрывающие все этапы жизненного цикла, поскольку система недетерминированная и часть процессов должна проверяться недетерминированно.
Где сейчас самое опасное место? Михаил считает, что смотреть нужно на то, что использует разработчик — это самый серьёзный вектор. Пример: существуют среды, на которые нельзя ставить Claude Code, Codex и подобные инструменты. Умельцы взяли домашний ноутбук, не обладая навыками программирования, собрали на Arduino устройство, которое печатает с клавиатуры и фотографирует экран, и запустили к себе агента, хотя он был запрещён повсюду.
Михаил Черешнев, ведущий инженер по искусственному интеллекту и безопасности, AppSec Solutions
Артур Хашаев добавил: нужны понятные правила игры — что можно, чего нельзя, какие инструменты использовать. Первый эшелон — AI Gateway, шлюз, через который разработчик подключается к доступным моделям: журналирование, аутентификация, авторизация, корпоративные SSO, трассировка.
CI/CD с дополнительными security-шагами и код-ревью — второй эшелон защиты. Разработчик начинает не с пуш-кода, а с работы с агентом и MCP-сетом. Одного AI Gateway недостаточно: ключевые события происходят на рабочей станции разработчика, где необходим сэндбоксинг, чтобы модели и агенты выполняли только разрешённые действия.
Дмитрий Шмойлов заявил, что политика, предполагающая отказ от использования ИИ по причине его запрета, уже не соответствует реальности. Серый ИИ, как и серый ИТ, присутствует здесь и сейчас, и нет ни одного разработчика, который не попробовал бы его на практике. Угрозы, которые несёт агентская разработка или подключение плагина в IDE, могут не осознаваться, и понимание этих проблем пока не распространено.
Поэтому первое, что необходимо сделать, — возглавить это направление, причём не через запрет, а через разговор с разработчиками: выяснить, как они работают, не с целью запретить, а чтобы понять, как снизить риски для компании. Выгода для разработчика значительна, а осознание рисков пока находится на начальном уровне.
Михаил Кобик напомнил, что безопасный ИИ — это свойство всей системы вокруг, а не только модели с запущенным Qwen. Важно контролировать, какой харнес используется и почему гейтвей должен знать, какой именно харнес прислал данные. Именно поэтому у них в продукте появился собственный гейтвей, одно из основных свойств которого — гардрейлы, а не доступ к моделям: возможность контролировать, что модель получает и что выдаёт в ответ. Безопасники должны участвовать и возглавлять это направление, поскольку речь идёт о новой сложной технологии, требующей осмысления.
Агенты, харнесы и мутирующая среда
Михаил Черешнев пояснил: раньше можно было представить простенький харнес с тремя-четырьмя инструментами. Классический инструмент защиты конечных рабочих станций отслеживал конфигурации харнеса, переменные окружения и следил, чтобы это не менялось. Сейчас, когда меняется всё, инструменты контроля целостности конфигурации не работают: если это блокировать, мы просто сломаем философию использования такого харнеса, как DeepSeek. Нужны новые подходы и инструменты.
Михаил Кобик:
«На домашнем компьютере у меня установлен DeepSeek именно с точки зрения эксперимента — насколько сильно всё это меняется. Харнес в процессе своего исполнения может решить, что ему что-то не понравилось, и он переписал сам себя. Это буквально мой случай: я заметил, что харнес не смог воспользоваться тулом Web Search, потому что не было API-ключа DeepSeek. Он взял и написал для себя плагин для использования opensource Web Search. У него была задача найти в интернете, и он её пытался достичь любыми возможными способами».
Андрей Жуков связал это с тем, что модель мутирующего харнеса перенимают все остальные: OpenCode сказал, что теперь у них версия номер два, такие же, как DeepSeek-харнес; Claude сказал, что теперь у них плагины, которые подключаются на лету. Если раньше агенты страдали от безысходности, то теперь они могут сами переписать среду, в которой запустились, потому что мы им сами дали такую возможность. Если поставить перед агентами невыполнимую задачу, они всё равно могут её выполнить.
Андрей Жуков, ведущий консультант, Faust
Артур Хашаев добавил: агенты приходят к единому знаменателю, у них появляются возможности самомодификации, поэтому рассматривать каждого агента отдельно и решать, что запрещать, а что нет, не имеет смысла.
Существует вендор-лок: на некоторые агенты, например Claude Code, нет информации о внутреннем устройстве — доступны только сливы исходников. Поэтому вместо запрета предпочтительнее сэндбоксинг агентов, чтобы, чтобы, например, файл .env с приватными ключами не утёк. При грамотной настройке и разъяснении разработчикам это снимет значительную часть рисков.
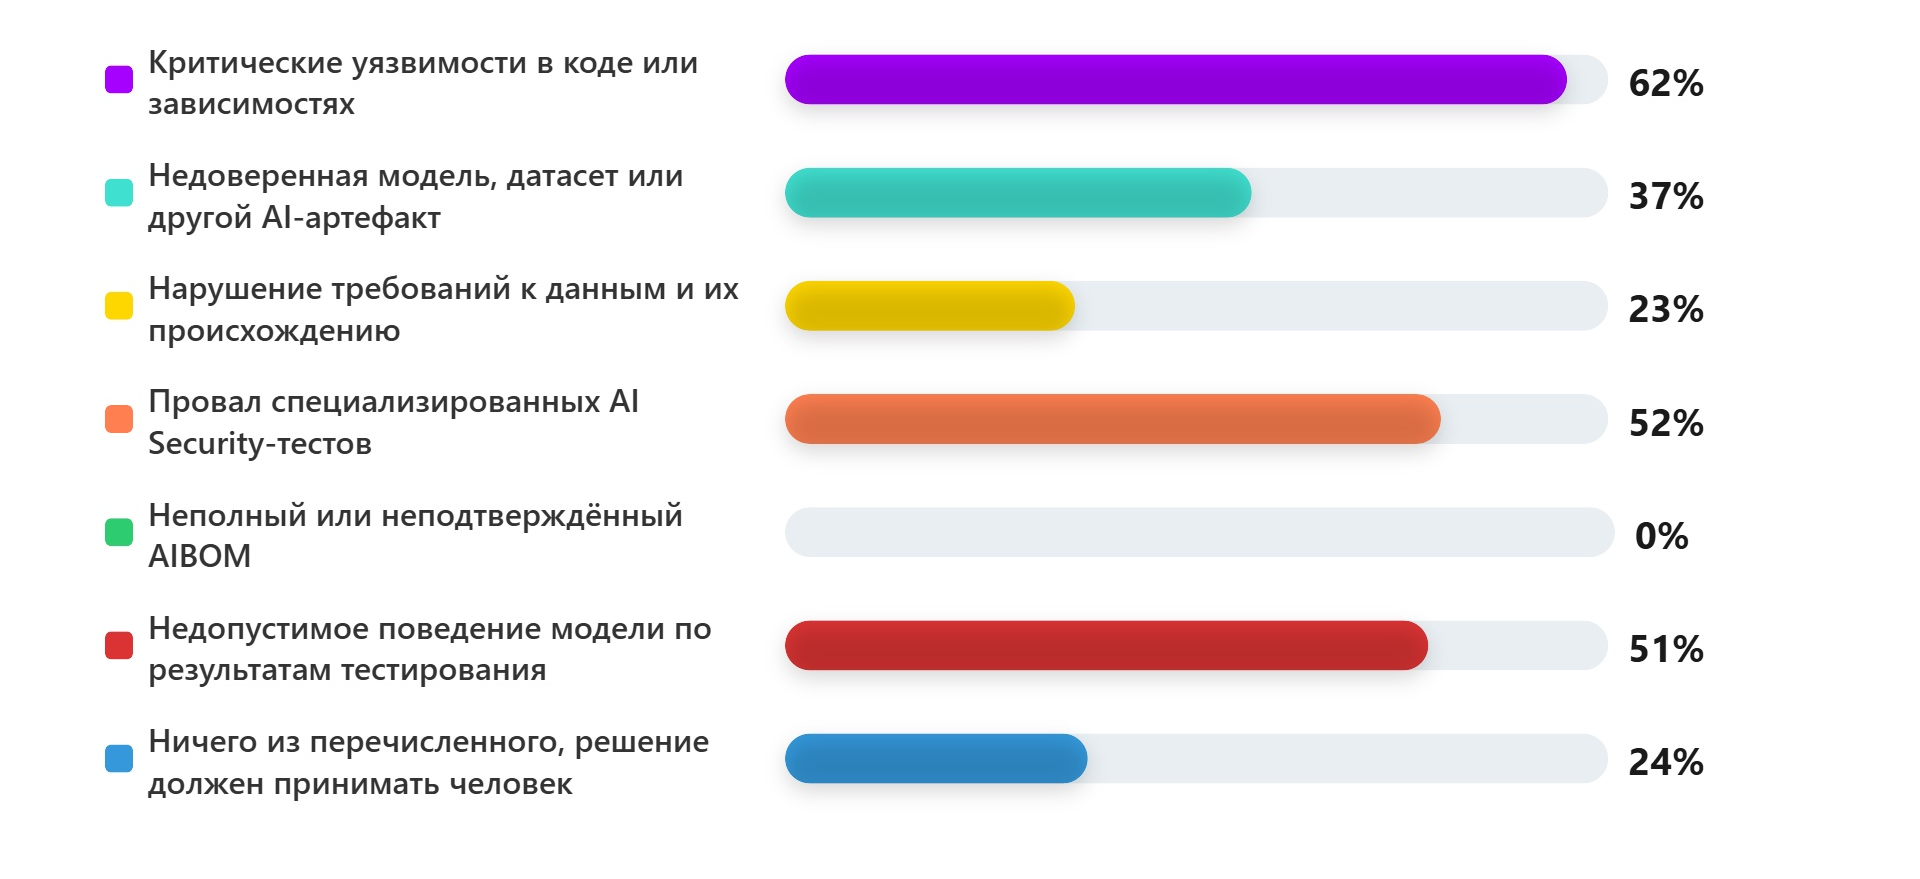
В третьем опросе зрители поделились мнением, что должно автоматически останавливать релиз, если в разработке применяется ИИ (мультивыбор):
- Критические уязвимости в коде или зависимостях — 62%.
- Провал специализированных AI Security-тестов — 52%.
- Недопустимое поведение модели по результатам тестирования — 51%.
- Недоверенная модель, датасет или другой AI-артефакт — 37%.
- Ничего из перечисленного, решение должен принимать человек — 24%.
- Нарушение требований к данным и их происхождению — 23%.
- Неполный или неподтверждённый AIBOM — 0%.
Рисунок 9. Что должно автоматически останавливать релиз, если в разработке применяется ИИ?
Что меняется в DevSecOps-конвейере с приходом ИИ
Михаил Кобик расскаал, что государство выпустило по РБПО законодательную базу, описывающую, как безопасно разрабатывать ПО. Сертификатом РБПО обладают пять-восемь компаний, в первой пятёрке — две компании, присутствующие на эфире. Ключевой момент: РБПО является рекомендацией. Раньше выпуск релиза занимал три-четыре круга согласований с безопасниками, сейчас — один-два. Агенты, встроенные в пайплайн и анализирующие BOM, тарифы и результаты SAST, кратно снижают когнитивную нагрузку на исполнителей.
Дмитрий Шмойлов добавил: РБПО — это не только регуляторика, но и принципы безопасной разработки. При высоких требованиях к качеству безопасности продукта следует идти именно туда. Сначала SDLC (Secure Software Development Life Cycle), затем РБПО — подмножество, которое сейчас отождествляется с регуляторикой. Пайплайны могут ускориться за счёт автотриажа, предобработки и преданализа, но модели тоже ошибаются, поэтому контроль безопасников необходим.
Дмитрий Шмойлов, руководитель отдела безопасности программного обеспечения, «Лаборатория Касперского»
Артур Хашаев уверен, что любая регуляторика вырастает из рекомендаций и практик энтузиастов. Secure SDLC и CycloneDX начинали как инициативы энтузиастов, а сейчас стали обязательными. После инцидентов практики переходят в рекомендации, затем у вендоров перестают покупать несоответствующие решения.
Кода становится больше, потому что он дешёвый, людей — столько же или меньше. Пайплайны с гейтами не исчезают, появляются новые шаги с использованием ИИ-инструментов и агентов: автоматическое security review, автоматическое код-ревью. Разработчики и безопасники часто видят, что с пул-реквестом что-то не так, хотя формально всё хорошо. Здесь можно опереться на интуицию человека и подключить ИИ для поиска корневой причины: человек указывает проблемную область, ИИ обобщает и находит архитектурный изъян. Это не автоматизация вместо человека, а обогащение его возможностей.
Михаил Черешнев привёл пример из консалтинга: руководство стремится внедрять ИИ повсеместно, включая информационную безопасность, и штат, занимавшийся DevSecOps и РБПО, начал сокращаться — часть ответственности переложили на ревьюеров, часть на агента, который выкатывает хотфиксы. Ключевая проблема: классический DevSecOps-процесс (SAST, DAST, IAST) разрознен — интерфейсы непохожи, непонятно, как работать с инструментами.
Процесс в большинстве организаций не адаптирован к тому, что кода стало значительно больше, а безопасников меньше: в одном пайплайне стоит набор инструментов, и AppSec-специалисты перегружены. Процесс необходимо адаптировать с точки зрения производительности — при проверке продуктовой гипотезы нет готовности ждать ревью, нужен агент, который выполнит проверку сам. Если сохранить текущий объём проверок, компания проиграет конкурентам по скорости выпуска.
Прогнозы: что будет через два года и какие решения окажутся ошибкой
Дмитрий Шмойлов:
«В перспективе двух лет ответить невозможно. Мы живём в новой реальности, наше поколение пережило много ИТ–революций. Что будет через два года именно в этой области — непонятно. Возможно, мы останемся без работы, возможно, будем вкалывать на кого-то, возможно, как в “Матрице”, лежим в коконах и это всё иллюзия. Через полгода — наиболее широкое внедрение ИИ при условии, что внешние модели будут ещё доступны».
Михаил Черешнев:
«Будет общедоступный интернет данных, где персональные и секретные данные будут в открытом доступе и доступны всем моделям и людям. Появятся новые цифровые наркотики в виде токенов, подключённые сразу к тебе».
Михаил Кобик:
«За последние девять месяцев ИИ сильно поменялся несколько раз. Изменение, которое произошло, — это релиз сильных открытых моделей, в первую очередь Gemma, который показал, что фронтир-модели могут стоять у вас. Либо в компании будет усердно внедряться ИИ-нейрослоп во все процессы, везде, где только можно, либо компании будут закрываться, потому что будут неконкурентоспособны по количеству фичей, по скорости, с которой они это выдают.
В мире ИИ качество имеет фактор достаточности. Компании, которые смирятся с тем, что качество достаточное, и внедрят разработку с помощью ИИ, будут занимать всё больше ниш на рынке. Это горизонт ближайшего полугода».
Артур Хашаев:
«Можно надеяться, что в целом будет плюс-минус так же, но иначе. Все существующие практики, инструменты и подходы получат продолжение в виде способности агентов. Изменится SAST — будет SAST+AI. Изменится DAST — будет DAST+AI. Изменится SCA — станет SCA+AIBOM. Локальные модели меняют наш взгляд на то, как это будет развиваться».
Какое решение в безопасности будет ошибкой в ближайший год?
Артур Хашаев:
«Выдача слишком широких прав агенту. Если он будет работать под сервисной учётной записью с большим количеством привилегий, то может сделать всё, что угодно. Нужно использовать классический принцип минимизации поверхности атаки: агент работает под делегированным токеном с правами не больше, чем права пользователя, который его позвал. Скорее всего, мы увидим большое количество атак и уязвимостей, связанных с избыточными правами агентов».
Михаил Кобик:
«Мне не нравится концепция встроенных сэндбоксов в харнесе. Это ошибочная история, потому что агент переписывает харнес на лету. Сэндбокс должен быть отвязан от процесса работы и мыследеятельности самого агента — у него не должно быть возможности влиять на эту среду».
Дмитрий Шмойлов:
«Нужно не сосредотачиваться на конкретных инструментах — через два месяца всё будет по-другому. Надо понимать, почему это происходит и какие последствия могут быть. С этого нужно начать.
При построении модели угроз необходимо учитывать бэкапы: инцидент всё равно может произойти, и доступ агентов к резервным копиям должен быть исключён. Работу над моделью угроз следует вынести на первый этап — остановиться, проанализировать риски и взвесить все за и против, и только после этого переходить к внедрению агентов, LLM–файрволов и других инструментов».
Михаил Черешнев:
«Если говорить про сэндбокс, можно пока ограничиться отдельной виртуальной машиной с отдельными доступами. Исходите из того, что там находятся данные, которые вы готовы потерять. Это всё развивается очень быстро. То, что сейчас точно делать нельзя, — запрещать эти технологии к использованию».
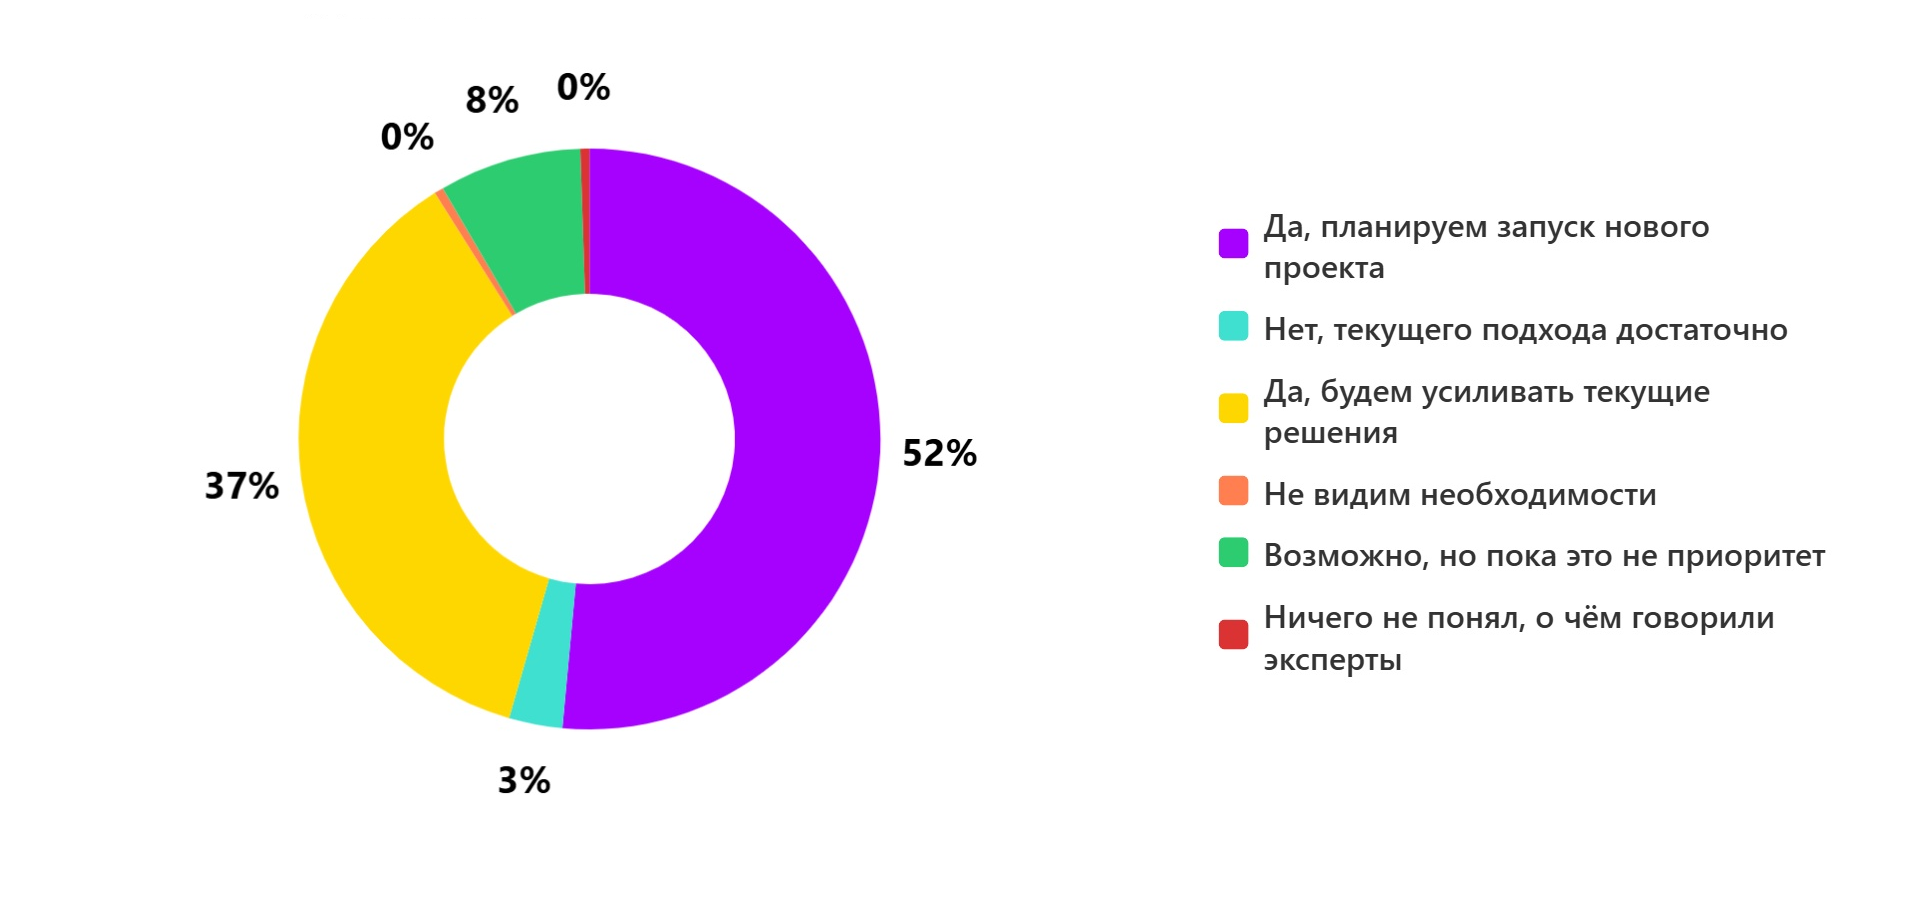
Финальный опрос показал, планируют ли зрители после эфира усиливать безопасность применения ИИ в разработке:
- Планируют запуск нового проекта — 52%.
- Будут усиливать текущие решения — 37%.
- Возможно, но пока это не приоритет — 8%.
- Нет, текущего подхода достаточно — 3%.
Рисунок 10. Планируете после эфира усиливать безопасность применения ИИ в разработке?
Выводы
Безопасность ИИ в 2026 году находится на переходном этапе, когда рынок только осознаёт масштаб проблемы. Опросы зрителей показали, что 43% компаний практически не контролируют использование ИИ, а те 9%, которые считают, что контролируют полностью, скорее всего, заблуждаются.
Контроль над теневым ИИ возможен лишь частично: составлять полный список используемых сервисов нереально, а реестр должен быть динамическим объектом, а не разово составленным документом. Классические средства защиты справляются с новыми угрозами лишь частично: создание реестра — это фонарик в огромной тёмной комнате, а LLM–файрволы сегодня — это MVP, временное решение, которое со временем будет поглощено более комплексными продуктами. Понятие зрелого продукта может вообще исчезнуть как класс — решения будут собираться динамически с учётом нового опыта.
Главный вектор угроз смещается в сторону агентов и разработчика. Контроль и фильтрация действий агентов — самая большая сложность по опросам, за ней следуют управление правами доступа и безопасность MCP-серверов. Агенты опаснее людей, потому что у них нет страха и эмоций: человек, отвечающий за релиз, десять раз подумает, а агент — нет. Но ответственность за действия агентов всё равно должен нести человек.
Агенты и харнесы — новая поверхность атаки. Харнес может переписать сам себя, и это уже реальность: агент, не имея нужного инструмента, пишет себе плагин. Мутирующая среда ломает классические инструменты контроля целостности конфигурации. Сэндбоксинг и изоляция — ключевые меры, но встроенные в харнес сэндбоксы — ошибочная концепция, потому что агент может их обойти. Права агента должны быть минимизированы.
Компании, которые смирятся с достаточным качеством и внедрят разработку с помощью ИИ, будут занимать всё больше ниш. Главные ограничители автономности — доверие, ответственность и специалисты, умеющие работать с моделями. Начинать стоит с обучения сотрудников, аудита и поиска экспертов, которые помогут пройти первые шаги. Только комплексный подход, выстроенный в непрерывный процесс, позволяет защитить компанию до того, как настоящая атака случится.
Телепроект AM Live еженедельно приглашает экспертов отрасли в студию, чтобы обсудить актуальные темы российского рынка ИБ и ИТ. Будьте в курсе трендов и важных событий. Для этого подпишитесь на наш YouTube-канал. До новых встреч!


