



Почему «пик» — это не количество запросов, а грань возможностей системы? Как маркетинг обманывает ИТ и почему запас 30–50% обязателен? Реально ли не переплачивать за запас прочности? Вместе с экспертами разбираем, что опаснее — «перезаложить» или «недозаложить» мощности, и как облака помогают бизнесу справляться с сезонными нагрузками.
- 1. Введение
- 2. Переосмысление метрик и целей
- 3. Опыт РИВ ГОШ: пики продаж и узкие места в архитектуре ретейла
- 4. Стратегии подготовки: от хаоса к управляемости
- 5. Облако как инструмент масштабирования
- 6. Аспекты планирования нагрузки — что нужно сделать и какие мощности заложить
- 7. Ретроспективный анализ: кто виноват и что делать
- 8. Выводы
Введение
Когда-то сезонность в ретейле была предсказуемой: «красный океан» с сентября по декабрь, мёртвый сезон в январе и постепенный рост к лету. Сегодня эта парадигма изменилась.
Понятия сезонности в её классическом виде больше не существует — бизнес стремится к тому, чтобы наплыв клиентов был всегда, что требует принципиально нового подхода к архитектуре и планированию ресурсов. Пиковые нагрузки стали непрерывными: расширение цифровой инфраструктуры и специальные маркетинговые инструменты искусственно сглаживают естественные спады.
О том, что такое пик на самом деле, как к нему готовиться и почему лояльность клиента дороже денег в моменте, поговорили с экспертами в рамках подкаста AM Live.
Рисунок 1. Участники подкаста
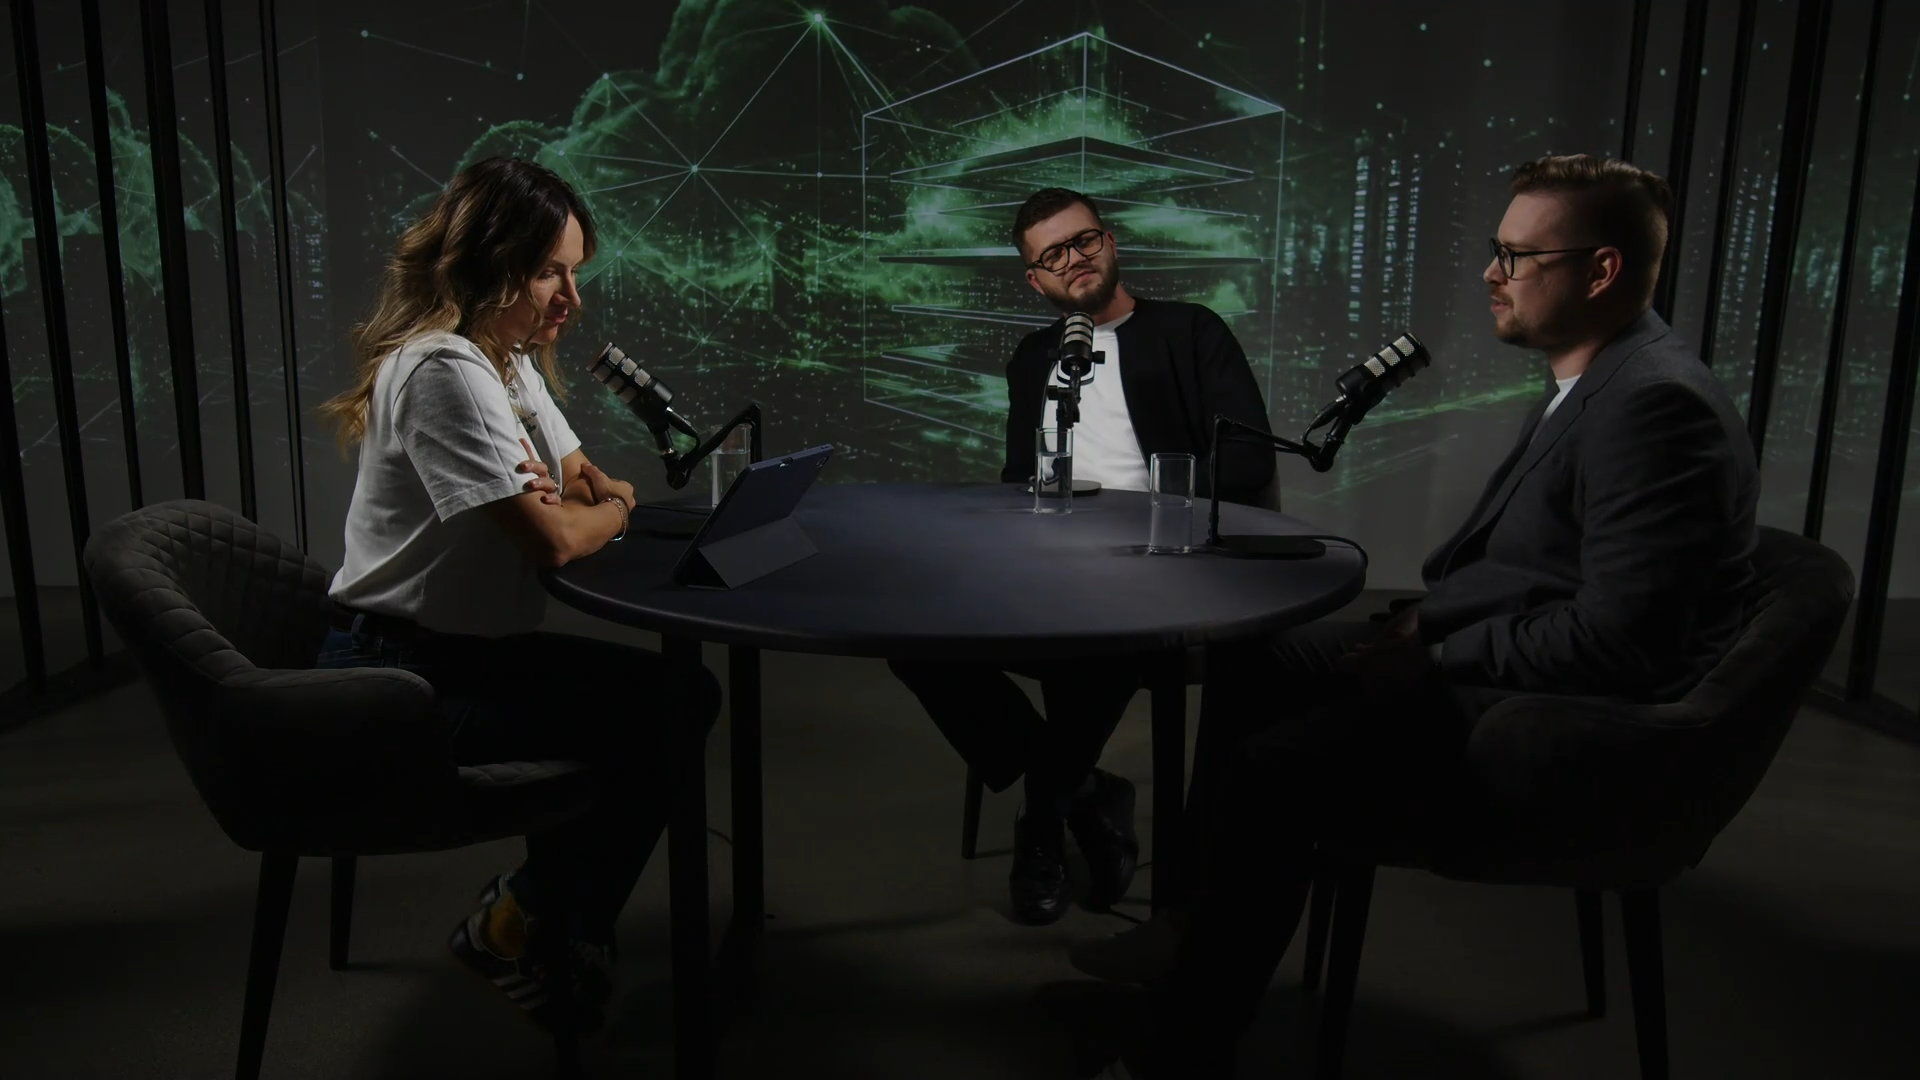
Участники подкаста:
Станислав Попов, директор по развитию облачных и инфраструктурных продуктов «МегаФон ПроБизнес».
Николай Минаков, директор департамента информационных технологий РИВ ГОШ.
Ведущая и модератор эфира — Олеся Афанасьева, генеральный продюсер, специальный корреспондент «АМ Медиа».
Переосмысление метрик и целей
Главная методологическая ошибка при подготовке к высоким нагрузкам — измерение пика исключительно в технических единицах, таких как RPS (запросы в секунду), нагрузка на CPU или объём сетевого трафика. Эксперты предлагают оперировать иным, бизнес-ориентированным определением.
Когда наступает пик нагрузки?
По мнению Николая Минакова, пик нагрузки — это когда система находится на грани своих возможностей, чтобы зарабатывать деньги. Количество запросов или клиентов, зашедших на сайт, — это ещё не нагрузка. В ретейле цепочка продаж состоит из множества узлов — например, интернет-магазин, маркетплейсы, логистические хабы и склады, бонусные системы, интеграции с 1С. Все эти узлы должны работать, чтобы приносить деньги.
Станислав Попов добавил, что понятия сезонности как такового больше нет. Динамика расширения инфраструктуры настолько высока, что пики идут друг за другом, они сглаживаются и провайдер их фактически не видит. Кроме того, у облачного провайдера есть клиенты из разных отраслей (ретейл, финтех, логистика), и у каждого из них свои пики. В результате для провайдера нагрузка остаётся постоянной и ровной.
Эксперт также отметил, что для провайдера нагрузкой может быть даже то, что заказчик не считает пиком. Если пользователь зашёл на сайт, посмотрел товар, но не оформил заказ, для бизнеса это не пик, а для провайдера — реальная нагрузка, которую нужно отработать.
Формула сезонности — существует ли она?
Ведущая попросила вывести формулу сезонности. Николай Минаков считает, что такой формулы нет, поскольку никогда нельзя точно высчитать количество клиентов или заказов, которое ты получишь. Но есть маркетинговый календарь, и маркетологи должны заранее предупреждать ИТ-службу о том, когда будут проходить акции.
Хотя формулы сезонности нет, есть три цифры, которые нужно держать в голове для перевода бизнес-целей в техническую модель:
- Твой уровень.
- Ожидаемый прирост.
- Стресс.
Николай Минаков:
«Маркетингу верить нельзя: всегда нужно закладывать +30–50% на эластичность. Реклама может выстрелить в два раза больше или, наоборот, в два раза меньше. Здесь и помогают облака — они позволяют горизонтально масштабировать имеющиеся узлы и сервисы в моменте».
Николай Минаков, директор департамента информационных технологий РИВ ГОШ
Опыт РИВ ГОШ: пики продаж и узкие места в архитектуре ретейла
РИВ ГОШ — редкий случай, когда продажи есть и онлайн, и офлайн, при этом ИТ-контур у них единый — розничные продажи в сетевых магазинах создают такую же нагрузку на систему заказов, как и заказы через интернет. Пик годовой нагрузки в парфюмерно-косметической сети приходится на 7–8 марта, но есть и ежемесячные пики нагрузки, а также традиционный рост продаж в офлайн-магазинах в выходные дни.
Недочёты в архитектуре ретейла становятся «узким горлышком» (bottleneck) в критический момент. Так, РИВ ГОШ нашёл суперузкое горлышко среди внешних систем — устаревшую бонусную систему (legacy). Раньше она не выдерживала пиковые нагрузки, и её приходилось выключать в сезон — хотя бонусы в beauty-индустрии являются одним из двигателей продаж. Систему заменили на другую, способную выдерживать нагрузки, — отдельный сервис от известного на рынке провайдера.
Николай Минаков отметил, что ИТ-архитектуру поздно проектировать в момент пика или «при падении». В этот момент надо принимать решения, чтобы найти выход из ситуации (как упомянутое отключение бонусной системы).
Стратегии подготовки: от хаоса к управляемости
Эксперты сошлись во мнении, что готовность к пику и прохождению сезона должна быть общей целью для бизнеса и ИТ, поскольку они неразделимы.
Что должен знать облачный провайдер?
Станислав Попов называет два ключевых условия для бизнеса:
- Предупреждать заранее. Хороший тон — проинформировать облачного провайдера минимум за месяц. Чем сложнее ИТ-ландшафт, тем раньше это стоит сделать. Годовой план обсуждать можно, но современный рынок настолько переменчив, что чаще всего это не имеет смысла. Облака как раз и умеют быстро реагировать — это одно из основных преимуществ сервиса.
- Прогнозировать количество пользователей. Здесь есть нюанс: значения текущего года почти всегда превышают предыдущие. Бизнес хочет расти, а цифровизация проникает всё глубже, и это касается уже не только крупных городов: глобальные маркетплейсы сильно сократили дистанцию. Однако провайдеру без разницы, каким путём пришёл заказ — через собственное приложение или маркетплейс. В любом случае это заказ, который надо обрабатывать и задействовать все внутренние системы.
Отдельная боль — гибридный ландшафт. Если он включает не только виртуализацию, но и физические серверы, подготовка к пикам усложняется. Классический пример — решения 1С, которые раньше было проблематично виртуализировать и которые размещались на выделенных физических серверах. При подготовке к сезонным пикам это создавало проблемы, поскольку количество транзакций возрастало.
Что важно сделать бизнесу до пика?
Николай Минаков считает, что управление ИТ должно быть не реактивным, а проактивным. По его мнению, работа 24/7 говорит лишь о том, что подготовка была недостаточной.
Шаги подготовки к прогнозируемому пику нагрузки:
- Выстроить правильную архитектуру приложений.
- Подготовиться с точки зрения мониторинга и нагрузочного тестирования.
- Понять ожидания бизнеса.
- Проверить техническую модель.
Эксперт считает: при тщательной подготовке пик нагрузки — это не бой, в котором надо выстоять, а скорее парад, который принимается с трепетом и достоинством. С каждым пиком команда приобретает новый опыт и делает работу над ошибками, чтобы подготовиться к следующему пику. И этот процесс должен быть непрерывным и бесконечным.
Лучше перезаложиться или недозаложиться?
На вопрос, что страшнее — «перебдеть» или «недобдеть», Николай Минаков ответил: недозаложиться. В этом случае бизнес рискует столкнуться с простоем и потерей клиентов. Если же перезаложиться, придётся потратить больше денег, но клиентский опыт не ухудшится. После негативного опыта клиенты либо больше не придут, либо вернутся уже с сомнениями. Учитывая стоимость каждой секунды простоя бизнеса, из двух зол меньшим можно считать именно перезаложиться.
Станислав Попов уточняет: провайдеру финансово выгоднее перезаложиться, но его основная задача — помочь заказчику соблюсти баланс. Простой мощностей даёт не только финансовый эффект, но и потерю лояльности, которая зачастую дороже, чем потери или затраты в моменте. Опытные команды умеют правильно считать баланс.
Как на самом деле проверяют нагрузку
Николай Минаков описывает, как это происходит в РИВ ГОШ:
- При расчётах нужно смотреть на механики рекламных акций и поведение пользователя в целом. Крупный игрок всегда перекладывает любое действие пользователя в аналитику (воронки): как пользователь ведёт себя на сайте, до какого момента скроллит страницу, как переходит в карточку товара.
- Затем бизнес-процессы перекладывают в технический профиль. Это не просто «тысяча HTTP-запросов», а создание нагрузочного профиля пользователя в соответствии с тем, как маркетинг будет вести трафик. Этот профиль эмулируют на стенде, увеличивая нагрузку до момента, когда система не упадёт или не начнёт деградировать.
- В момент деградации собираются логи и оценивается поведение системы: как ведут себя база данных и внешние системы, что происходит с CPU. После этого анализируют узкие места и решают, что можно с ними сделать.
Если узкое место поддаётся горизонтальному масштабированию, проблему решает увеличение количества подов. Если нет — например, приложение обращается к одной базе данных, и дополнительные поды лишь ускорят её отказ — рассматривают способы нивелирования ситуации в моменте.
Узкие места архитектуры
Пример, описанный выше: устаревшие системы лояльности и бонусные программы в beauty-сфере часто не рассчитаны на современный трафик. Они требуют постоянного пересчёта стоимости корзины и применения скидок, создавая колоссальную нагрузку на систему заказов.
Самые частые узкие места, по мнению экспертов:
- Legacy-системы и монолиты создают ошибки, при которых множество микросервисов обращаются к единой точке отказа. Например, непроиндексированные запросы к таблице могут существенно увеличить нагрузку на систему заказов. Ещё один пример от РИВ ГОШ: за 2 часа после выкладки релиза количество запросов к БД выросло с 5 до 15 млн запросов, фактически парализовав работу интернет-магазина.
- Недооценка пропускной способности каналов связи и балансировщиков нагрузки. Особенно это актуально в условиях смещения пользовательского трафика: сегодня заказы из мобильных приложений создают большую нагрузку, чем заказы через классические веб-сайты, что требует иных подходов к балансировке и защите от DDoS-атак.
В настоящее время специалисты в целом научились работать с этими узкими местами и достаточно корректно их прогнозировать. Тем не менее, по мнению приглашённых экспертов, указанные узкие места по-прежнему есть.
Облако как инструмент масштабирования
Далее ведущая подкаста затронула тему масштабирования. Позиция Николая Минакова такая: облака — не благо и не зло, а инструмент, который нужно правильно использовать.
Что можно масштабировать, а что нет?
По мнению эксперта, критическая инфраструктура должна находиться «на полу» (т. е. on‑premise), а всё остальное можно разместить в облаках. Нельзя масштабировать legacy-системы и монолиты, которые обращаются к одной БД: архитектура приложения в этом случае должна быть иной.
Часть сервисов РИВ ГОШ масштабируется через облака, когда нагрузка превышает обычный уровень. Держать дополнительные мощности круглый год нет необходимости. Условно 100 человек в обычные дни, 150 в пики, плюс 30–40% запаса на стресс-тестах.
Станислав Попов согласен: горизонтально масштабировать можно не всё. Первый класс систем, которые переехали в облако, — это системы лояльности. А вот legacy и монолиты перевести в облако проблематично.
Личный кабинет: удобство и ловушки
Облачный личный кабинет — базовый сценарий, который провайдеры используют уже давно. Зрелый заказчик сам знает, что ему надо делать, а провайдер снимает с себя сервисную нагрузку.
Но есть и встроенные механизмы ограничения: нельзя «на горячую» выключить все машины или случайно удалить все сети с внешними IP-адресами. Особенно осторожным следует быть неопытным администраторам или владельцам малого бизнеса.
Ряд операций — создание крупных виртуальных машин, больших дисков, управление сетями — требует участия провайдера: случайно изменённые подсети способны нарушить весь доступ, а имитация трафика создаст излишнюю нагрузку для подразделения, отвечающего за анти-DDoS и WAF.
Проектирование приложений — это ключевой фактор
Подготовка к пиковой нагрузке должна начинаться с проектирования приложений. Уже на этапе формирования бизнеса и встраивания ИТ нужно решить, как будет выглядеть приложение, определить принципы работы и расчётное количество пользователей на горизонте пяти–десяти лет.
Заказчик должен уметь считать сам: что такое для него один заказ, один пользователь, один клик на сайте. Провайдер может помочь с инфраструктурой, канальной частью и аналитикой мониторинга, но уровень прикладных систем, которые не в его администрировании, — зона ответственности заказчика. С этой целью провайдер вправе использовать историческую аналитику и задавать уточняющие вопросы. В частности, при неизменности технологического стека и распределения нагрузки между ЦОДами провайдер может запросить обоснование столь существенной оптимизации ресурсов.
Обмен информацией должен быть двусторонним: обычно провайдер доводит до клиента roadmap (дорожную карту), график профилактических и аварийных работ. Корректное информирование — задача сервис-менеджера. При этом Станислав Попов считает, что работа облака должна быть выстроена так, чтобы заказчику это не было заметно.
Когда целесообразна гибридная архитектура
РИВ ГОШ держит в облаках некритичные системы (например, бонусную), а «золотой путь клиента» — on-premise. Чтобы не тратить деньги каждый месяц на перезаложенный ресурс, мощности добавляются в моменте — по кнопке в личном кабинете или через автоскейл, когда система начинает деградировать или приближается к отказу. Это позволяет компании не тратить деньги на то, что ей не нужно.
Станислав Попов предупреждает, что дублирование не работает: расчёт на размещение копии в облаке как на средство отказоустойчивости не оправдывается. Гибридная архитектура результативна только при постоянном использовании, иначе в пиковый период она не обеспечит защиты.
Аспекты планирования нагрузки — что нужно сделать и какие мощности заложить
Станислав Попов формулирует три шага для тех, у кого через месяц запланирована рекламная акция по повышению продаж или другие маркетинговые активности:
- Определить профиль нагрузки. Это отправная точка: без понимания действий пользователя в приложении нагрузку на ИТ-ландшафт правильно не рассчитать. Провайдер здесь помочь не может, но с этого нужно начинать.
- Провести нагрузочное тестирование. ИТ-ландшафт может быть сколько угодно «понятен» и описан, но в экстремальных ситуациях он ведёт себя непредсказуемо, потому что вы никогда не сталкивались с этими ситуациями.
- Подготовить мониторинг с упором на бизнес-метрики. Это поможет просчитать все возможные сценарии, чтобы заметить надвигающуюся катастрофу как можно раньше и быстрее на неё реагировать.
А если продажи уже пошли, а до планируемого пика ещё две недели? Николай Минаков советует: в этом случае нужно понять, где узкое место, можно ли его масштабировать или обойти, не ломая путь клиента или заказа. Если это невозможно, следует усилить узкое место в моменте без облачного масштабирования или снизить количество обрабатываемых операций, перенеся их обработку на уровень выше.
Говоря о запасе прочности, Николай Минаков считает золотым люфтом 5% — небольшой объём инфраструктуры, позволяющий маркетингу реализовать дополнительные активности при необходимости. Однако второй эксперт придерживается другого мнения.
Станислав Попов:
«Облачный сервис-провайдер должен иметь запас прочности не менее 30%. Это такой золотой стандарт отрасли. Причин для такого запаса множество: увеличение мощностей одним клиентом, подключение нового клиента, выход из строя одного из собственных ЦОД провайдера. С учётом многообразия сценариев запас прочности должен быть не менее 30%».
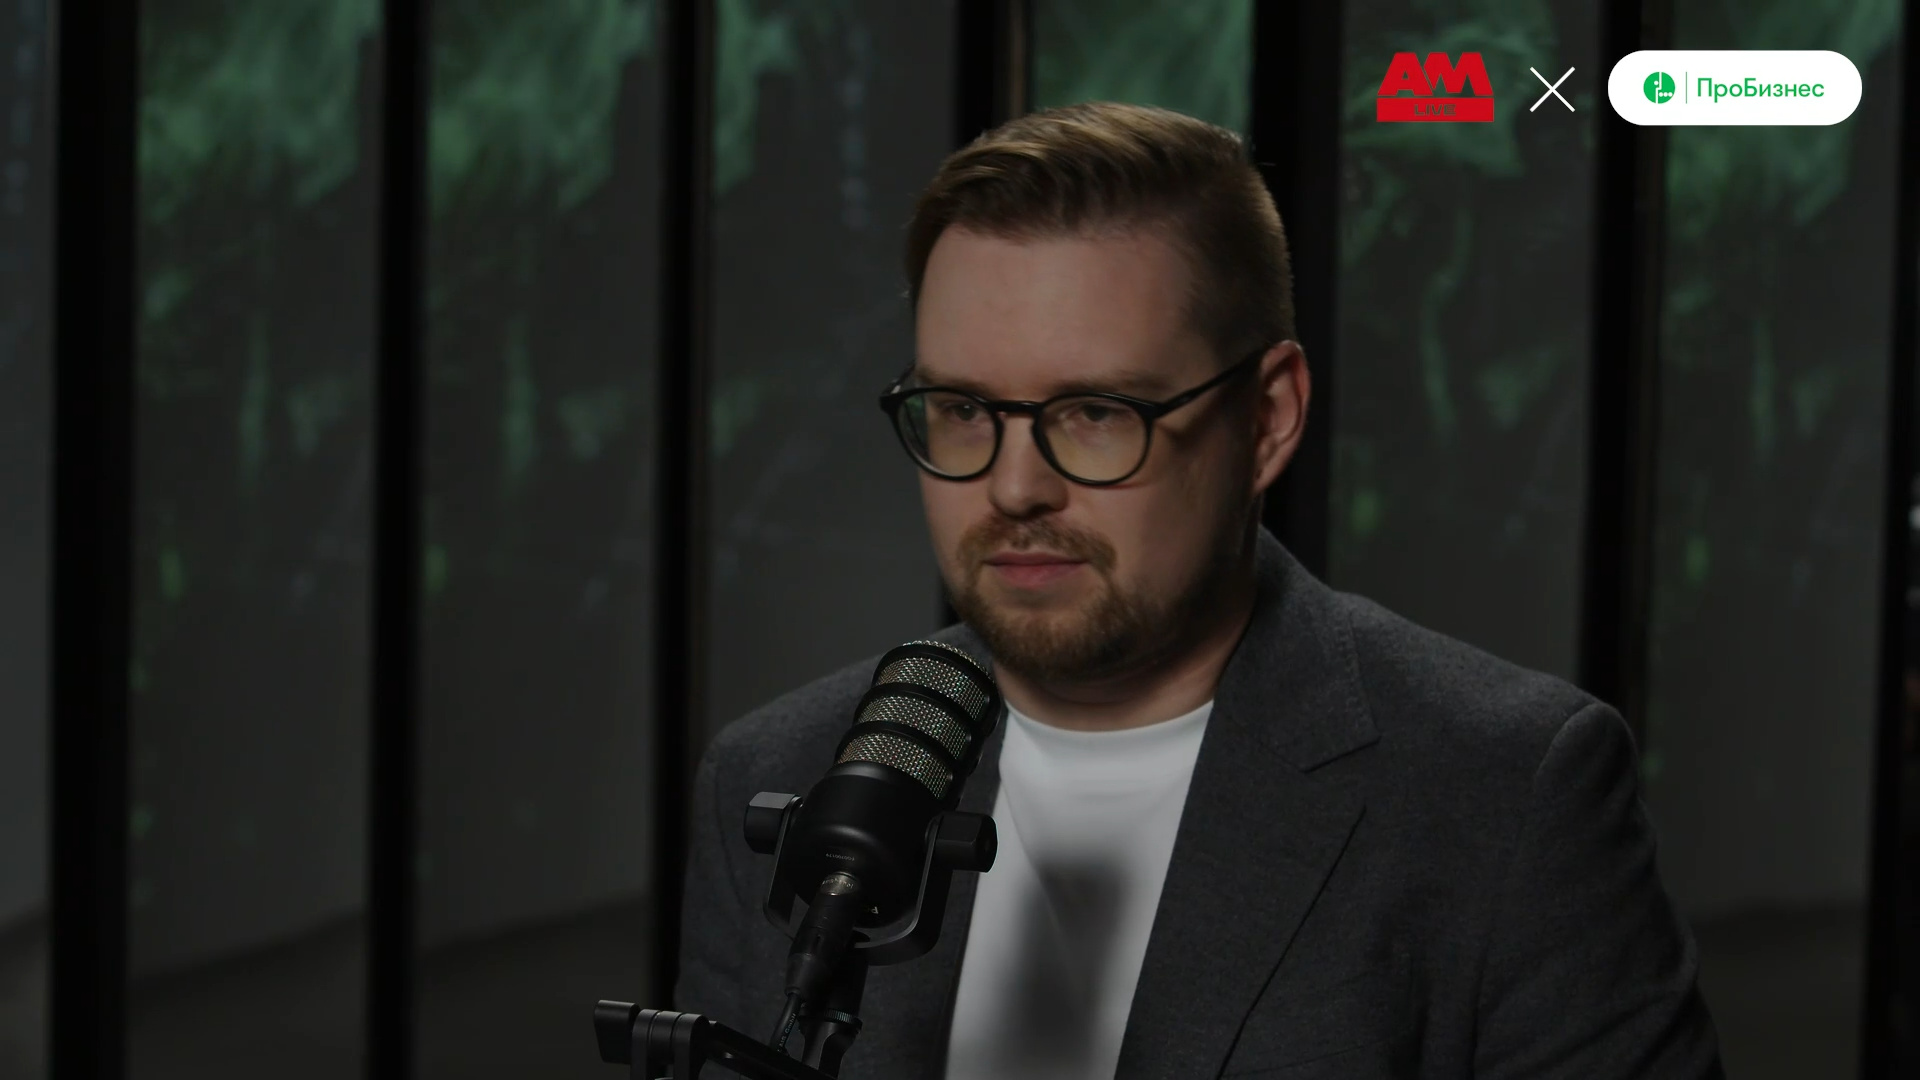
Станислав Попов, директор по развитию облачных и инфраструктурных продуктов «МегаФон ПроБизнес»
Ретроспективный анализ: кто виноват и что делать
Говоря об архитектуре, не стоит забывать про человеческий фактор — ни один провайдер не даёт SLA 100%. На вопрос, кто несёт ответственность, Николай Минаков отвечает: верхний уровень всегда остаётся за руководителем бизнеса. Однако фактическое прохождение пика и «разбор полётов» должны быть совместной работой бизнеса и ИТ, где облачный провайдер тоже является участником.
При согласовании действий со всеми участниками масштабного процесса ситуация, когда виноват кто-то один, исключена: если система дала сбой, кто-то не согласовал действия или не выполнил необходимые мероприятия заблаговременно.
Эксперты выделяют четыре ключевых аспекта такого разбора:
- Устойчивость инфраструктуры. Справилась ли система с нагрузкой? Были ли деградации ответа?
- Пользовательский опыт (UX). Увеличилось ли время загрузки? Видел ли пользователь «скелетоны» загрузки? Упала ли конверсия?
- Финансовая эффективность. Не произошло ли критического «перезаложения» ресурсов?
- Процессная зрелость. Насколько слаженно сработала команда? Сработали ли чек-листы и процедуры аварийного переключения?
Обмен итоговыми данными при необходимости осуществляется с облачным провайдером. Так провайдер имеет возможность ретроспективно оценить, была ли проведена работа над ошибками.
Главное — не паниковать в моменте и иметь чёткую команду, принимающую верные решения. И даже если система под нагрузкой деградировала, надо это вовремя увидеть и понять, как с этим работать. На ошибках можно много чему научиться. Важно понимать, что подготовка к пику нагрузки — это не разовая акция, а непрерывный цикл оптимизации архитектуры, который делает бизнес устойчивым к любым вызовам рынка.
Выводы
Попытка сэкономить на инфраструктуре в пик часто обходится бизнесу многократно дороже, чем стоимость облачных ресурсов, из-за потери лояльности клиентов, которая в современном ретейле ценится выше, чем сиюминутная финансовая выгода.
Как отмечают эксперты, облака — это не волшебная таблетка, а инструмент. Они не спасут плохо спроектированное монолитное приложение. Подготовка к пику — это непрерывный процесс совместной работы бизнеса, ИТ и облачных провайдеров, направленный на поиск баланса между финансовой эффективностью и положительным клиентским опытом. И ещё — всегда нужно иметь план действий на случай, если что-то пойдёт не так.


