



Внедрение ИИ помогает снижать нагрузку на антифрод-аналитиков и ускоряет их работу. Сокращается время на рутинные операции: автоматически приоритизируются алерты, проводится поиск аномалий, выявляются нетипичные связи между событиями. В статье рассмотрим, как ИИ помогает в расследовании инцидентов.
- 1. Введение
- 2. Узкое место: цена человеческой памяти и фокуса
- 3. Снижение стоимости извлечения знаний
- 4. Снижение стоимости перевода гипотезы в проверяемую модель
- 5. Безопасность, MCP и границы применимости
- 6. Интеграция ИИ в антифрод-аналитику
- 7. Выводы
Введение
При упоминании искусственного интеллекта в антифроде на ум сразу приходит использование нейросетевых моделей для детекции аномалий. Это поведенческая биометрия, графовый анализ транзакций в реальном времени, сложные скоринги. Но реальная боль индустрии кроется не в том, что модели плохо детектируют мошенников или не поспевают за меняющимся ландшафтом угроз. Проблема в том, что каждое срабатывание нужно проанализировать и оценить специалисту.
Статистика экспертов BI.ZONE AntiFraud:
- Антифрод-аналитики тратят до 70% рабочего времени на расследование алертов, которые в итоге оказываются легитимными транзакциями.
- Коэффициент ложноположительных срабатываний у лидеров банковского рынка может достигать 14 к 1.
- Ущерб от ложных срабатываний антифрод-систем может почти втрое превышать потери от мошенничества (с учётом потери доходов, оттока клиентов и обработки жалоб).
Непрозрачность работы искусственного интеллекта («чёрный ящик») мешает аналитикам доверять его выводам, проверять их и уточнять решения о мошенничестве. Это также может затруднять соблюдение законодательных требований и снижать эффективность анализа. Поэтому при внедрении ИИ в антифрод важно не просто компенсировать ограничения технологии дополнительными трудозатратами, а изначально выстраивать архитектуру процесса так, чтобы результаты работы моделей можно было проверять и использовать в принятии решений.
В этой статье мы отойдём от темы первичной детекции и сосредоточимся на самом процессе расследования инцидента. Рассмотрим, как ИИ меняет путь от сигнала до решения, автоматически приоритизирует алерты, ищет аномалии и выявляет нетипичные связи, чтобы освободить аналитика от рутины.
Узкое место: цена человеческой памяти и фокуса
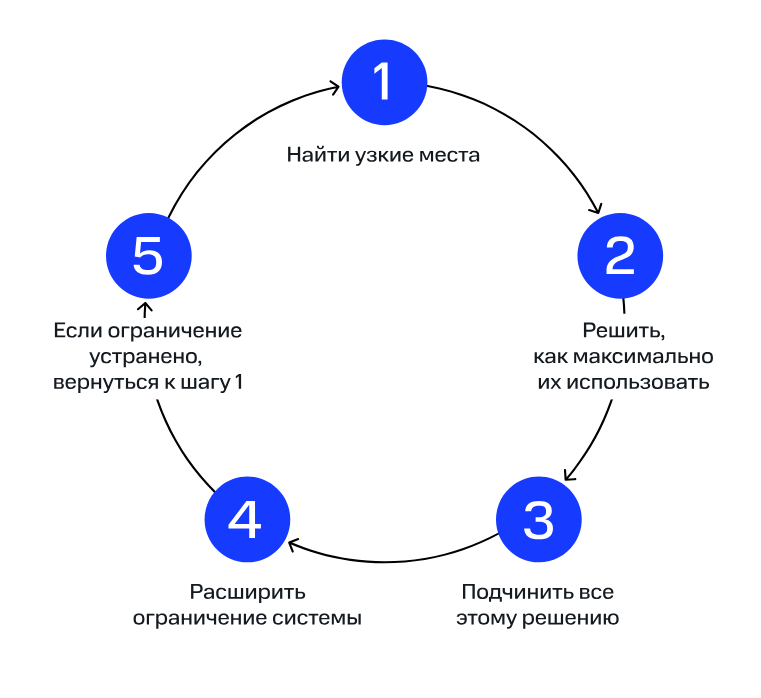
Согласно теории ограничений Голдратта (theory of constraints, TOC), любая система не может работать сильнее своего самого слабого звена. Какая разница, насколько точна ваша модель детекции, если на разбор одного инцидента уходит слишком много человеческого времени? Это и есть узкое место, то есть то самое «бутылочное горлышко» (bottleneck).
Рисунок 1. Пять фокусирующих шагов теории ограничений
В основе работы антифрод-аналитика лежит непрерывное наблюдение за финансовыми операциями и поведением клиентов в режиме реального времени. На практике это предполагает обработку больших массивов данных через настройку триггеров и оповещений в антифрод-системах, а также ручной разбор сработавших кейсов — оценку того, является ли инцидент реальным мошенничеством или ложноположительным срабатыванием правила.
Антифрод-платформы или внутренние разработки организаций функционируют на основе правил, заданных аналитиком, и ML-моделей. Однако при подтверждении подозрительной транзакции специалист по антифроду инициирует разбор инцидента. Он восстанавливает последовательность действий, оценивает размер причинённого ущерба и выявляет использованные мошеннические схемы.
То, за что платят антифрод-аналитику, — это его рабочая память и фокус. Сколько связанных сущностей человек может удержать в голове одновременно? Эта когнитивная нагрузка складывается из двух базовых «стоимостей»:
- Стоимость извлечения знания. Как долго нужно искать информацию, регламент, прецедент или похожий кейс?
- Стоимость перевода гипотезы в проверяемую модель. Сколько времени уходит, чтобы превратить мысль в SQL-запрос или Python-скрипт?
Именно эти две составляющие современный ИИ помогает минимизировать, трансформируя роль аналитика из «ручного сборщика данных» в «принимающего решения эксперта».
Снижение стоимости извлечения знаний
Аналитику постоянно нужен доступ к информации: внешней (OSINT, научные статьи, новости индустрии) и внутренней (корпоративные базы знаний, метаданные кейсов, транзакционная информация). Это может быть поиск по открытым источникам, корпоративному порталу с базой знаний или извлечение данных из конкретного фрод-кейса для поиска аномалий и разведочного анализа.
Как быстро вы разберётесь, почему сработало правило? А как быстро найдёте в открытых источниках ответы на свои вопросы? Сколько страниц на корпоративном портале надо просмотреть, чтобы точно в чём-то убедиться? В ваших данных есть аномалия?
Вопросы из разных плоскостей, но про одно и то же — про скорость получения нужной информации. И здесь нужны разные классы ИИ-инструментов, каждый из которых решает свою часть задачи.
Внутренний контур: RAG-пайплайны
Для работы с корпоративными регламентами и базой знаний идеально подходят RAG-системы (Retrieval-Augmented Generation). Вместо того чтобы «сочинять» ответ, LLM обращается к векторной базе данных (например, Qdrant или pgvector), находит нужный абзац во внутренних документах и выполняет задачу с привязкой к контексту. Такой подход обеспечивает grounding — привязку ответов модели к реальным фактам.
RAG-пайплайн состоит из двух моделей, и это важно понимать при проектировании архитектуры:
- Модель эмбеддингов — трансформирует данные в векторы.
- Языковая модель (LLM) — позволяет общаться с пользователем.
Иногда в RAG поверх всего остального добавляют маршрутизатор (router) в виде отдельной LLM. Он анализирует смысл вопроса и решает, в какой модуль его отправить:
- Классический RAG. Если нужен поиск по документам, запрос уходит в пайплайн с векторной базой.
- Text2SQL. Если нужны цифры из таблиц, запрос уходит в модуль генерации SQL.
- Прямой ответ LLM. Если пользователь просто хочет поболтать, запрос идёт напрямую в языковую модель без поиска по базам данных.
На данный момент внедрение в процессы постепенно облегчается, появляются всё новые и новые «обёртки» над известными инструментами и моделями. Например, OpenAI Agents SDK упрощает интеграции LLM в процессы, снижая порог входа для команд без глубокой экспертизы в области генеративного ИИ (GenAI).
Специализированные модели для кейсов
Когда речь заходит о самих фрод-кейсах (метаданных, данных внутри кейсов и их специфичной обработке), универсальных LLM часто не хватает. На помощь приходят специализированные модели и алгоритмы классического ML:
- Автоматическая приоритизация и кластеризация. ML-модели группируют алерты от антифрод-системы, выявляя нетипичные связи между событиями и отбрасывая дубликаты, чтобы аналитик видел не 100 разрозненных сигналов, а пять сгруппированных инцидентов.
- Поиск аномалий во временных рядах. Такие модели, как TimeGPT, позволяют мгновенно отслеживать аномалии в потоке платежей пользователя, выявляя отклонения от его базового паттерна.
- Графовый анализ. Некоторые ИИ-агенты (например, GDS Agent для Neo4j) помогают анализировать транзакции как часть графа, мгновенно находя скрытые связи между, казалось бы, не связанными контрагентами.
Если же для ваших специфичных задач моделей нет — попробуйте сделать свою, начав рассмотрение с открытых моделей, например, на Hugging Face.
Снижение стоимости перевода гипотезы в проверяемую модель
Чем быстрее аналитик превратит свою гипотезу в код или запрос к базе данных, тем выше шанс предотвратить ущерб. Любое исследование должно сопровождаться выгрузками и написанием скриптов.
Специализированные ИИ-агенты для разработки (такие как Cursor или Claude Code) ускоряют отдельные этапы SDLC: помогают преобразовывать требования и гипотезы в SQL-запросы, Python-скрипты и другие артефакты, необходимые для анализа данных. Это позволяет быстрее переходить от постановки задачи к проверке гипотезы на реальных транзакциях. При этом аналитику важно проверять сгенерированный код и результаты его выполнения, особенно если они используются для принятия решений о блокировке операций или клиентов.
Безопасность, MCP и границы применимости
Не стоит забывать, что интеграция ИИ-агентов в аналитические процессы несёт не только возможности, но и новые риски. Открытый протокол MCP (Model Context Protocol), предложенный в конце 2024 года, стал стандартом подключения LLM к внешним системам. Но как только ИИ-агент через MCP получает возможность обращаться к CRM или базе транзакций, фокус смещается с удобства на безопасность.
Подключение агента к системам компаний увеличивает поверхность атаки. Вопрос «Какие права у агента?» должен решаться раньше вопроса «Какую задачу он ускорит?».
Кроме того, существует жёсткий ограничитель — объяснимость. Если ИИ участвовал в подготовке решения по клиенту, банк должен уметь воспроизвести цепочку рассуждений для регулятора. Поэтому граница участия ИИ проходит строго по этапам процесса: на стадии подготовки гипотез, сбора контекста и первичного разбора ИИ имеет максимум свободы. Но ближе к финальному решению по блокировке или отказу клиенту ИИ может использоваться только там, где его рассуждение абсолютно прозрачно и аудируемо. Это закреплено Методическими рекомендациями Банка России от 16.06.2026 № 3-МР.
Интеграция ИИ в антифрод-аналитику
Эффективное внедрение ИИ-надстроек невозможно без надёжного фундамента. ИИ-агентам нужно дать качественные, структурированные данные и обеспечить безопасный контур для работы. Антифрод-платформа может стать такой основой. Например, BI.ZONE AntiFraud использует ИИ-модели для профилирования пользователей, выявления аномального поведения и обнаружения новых схем мошенничества.
Рисунок 2. Пример интеграции в инфраструктуру компании (источник: BI.ZONE)
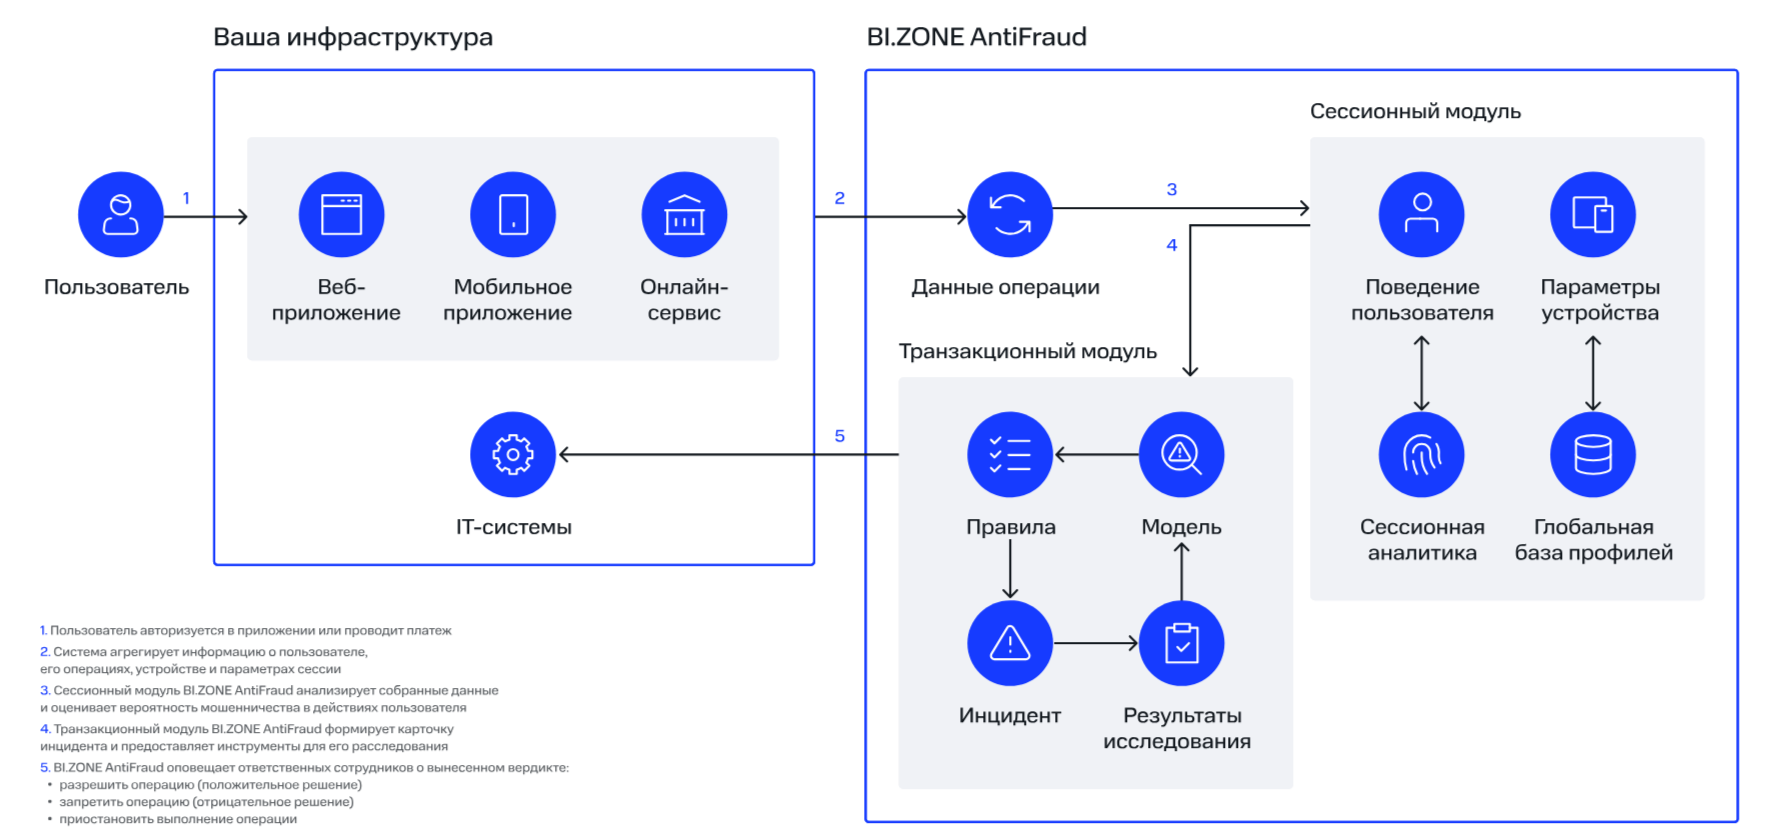
Именно здесь критически важна архитектура самой антифрод-платформы. Такие продукты, как BI.ZONE AntiFraud (BAF) и другие решения из обзора рынка систем противодействия мошенничеству, не просто генерируют алерты, а предоставляют аналитику глубокий контекст и структурированные метаданные для сессионного и транзакционного антифрода. Также BI.ZONE AntiFraud помогает подключиться к ГИС «Антифрод», чтобы выполнять требования Федерального закона от 01.04.2025 № 41‑ФЗ.
Наличие защищённых API-шлюзов и выстроенных процессов в подобных платформах позволяет ИИ-моделям легально и безопасно получать данные для кластеризации, графового анализа и приоритизации, не нарушая периметр информационной безопасности финансовой организации.
Но прежде чем внедрять ту или иную ИИ-модель в процесс расследования, честно ответьте себе на три вопроса:
- Если разложить процесс на этапы (сбор контекста, анализ, расследование, документирование), где реально находится самое узкое место? Часто оно не там, где кажется на первый взгляд.
- Кто в команде валидирует код и выводы, сгенерированные агентом, прежде чем они лягут в основу решения по клиенту? Зоны ответственности должны быть чётко определены.
- Измеряете ли вы эффект через среднее время обработки инцидента — или через разброс этого времени между разными аналитиками и сменами? Второе честнее показывает, где на самом деле кроется проблема.
Узкие места в антифроде чаще всего возникают не из-за нехватки данных, а из-за разрыва между автоматикой и ручной проверкой: аналитику не хватает графов связей (устройство — карта — получатель), ретроспективных срезов и быстрых фильтров по атрибутам, а формализованная валидация гипотез отсутствует.
Выводы
ИИ не способен заменить антифрод-аналитиков, но может взять на себя огромную долю рутины, за счёт чего время обработки инцидентов сокращается, а нагрузка заметно падает. Благодаря этому специалисты могут сфокусировать внимание на действительно сложных, нетипичных сценариях, где будут полезны их практический опыт и критическое мышление.
Не стоит забывать, что у злоумышленников тот же набор инструментов, а ИИ к тому же существенно снизил порог входа во фрод. Киберпреступники активно используют все доступные им цифровые технологии (дипфейки, LLM, автоматизированный фишинг), постоянно внедряя новые схемы. Обе стороны получают одни и те же технологии примерно одновременно, поэтому не останавливайте свои внутренние разработки агентов и моделей, собирайте разметку фрод-кейсов и статистику. Ускорение работы аналитика с помощью ИИ — это не просто выигрыш в моменте, а необходимое условие для эффективного противостояния мошенничеству в интернете.


