



ИИ ускоряет создание презентаций, но не гарантирует достоверность цифр и выводов. Рассказываем, как превратить слайды в проверяемый результат: хранить метрики в едином источнике, контролировать их изменения и автоматически проверять готовый PDF.
- 1. Введение
- 2. Что ломается в data-heavy презентациях
- 3. Слайд — это рендер, а не источник истины
- 4. Токены вместо чисел в тексте
- 5. Assert-резолв: дрейф значения должен ронять сборку
- 6. Гейты по готовому PDF
- 7. Как ревью стало управляемым
- 8. Где это не нужно и что не ловит
- 9. Выводы
Введение
Ещё пару лет назад собирать презентации «как код» — когда числа тянутся из данных, а слайды строятся скриптом — выглядело как оверкилл для энтузиастов: правильно, но дорого по времени. Сейчас порог сильно снизился. С ИИ-агентами можно быстро накидать пайплайн, написать код сборки, подготовить шаблоны и превратить данные в готовый артефакт, сразу оформленный в корпоративной дизайн-системе. По крайней мере, для моих data-heavy отчётов это стало нормальным рабочим способом.
Но у этой лёгкости есть и обратная сторона. Раньше, при ручной сборке, я проверяла каждое число и каждый график. Неидеальный медленный процесс, но он давал шанс заметить ошибку по дороге. Теперь отчёт собирается быстро и выглядит гладко: аккуратные слайды, графики на месте, оговорки не забыты. Вот только почти ни одна сборка не выходит правильной с первого раза — и проблемы каждый раз разные: тут правка не подхватилась, там ссылка ведёт не туда, число округлилось не так, а формулировка уже обещает больше, чем показывает график. Красиво не значит верно — и чем сложнее артефакт, тем меньше ему можно доверять «на глаз».
Внимательностью это не исправить: она не масштабируется на сотни чисел и десяток пересборок. Поэтому я встроила в сборку презентаций проверки — как тесты в код. Если значение разошлось с источником, ссылка ведёт в пустоту или старый тезис всплыл после правки, сборка падает.
Ценность не в самой автосборке — собрать презентацию из данных с ИИ сегодня стало заметно проще. Ценность в том, чтобы результату можно было доверять: чтобы ошибка не доезжала до аудитории, а останавливала сборку на этапе проверки.
Что ломается в data-heavy презентациях
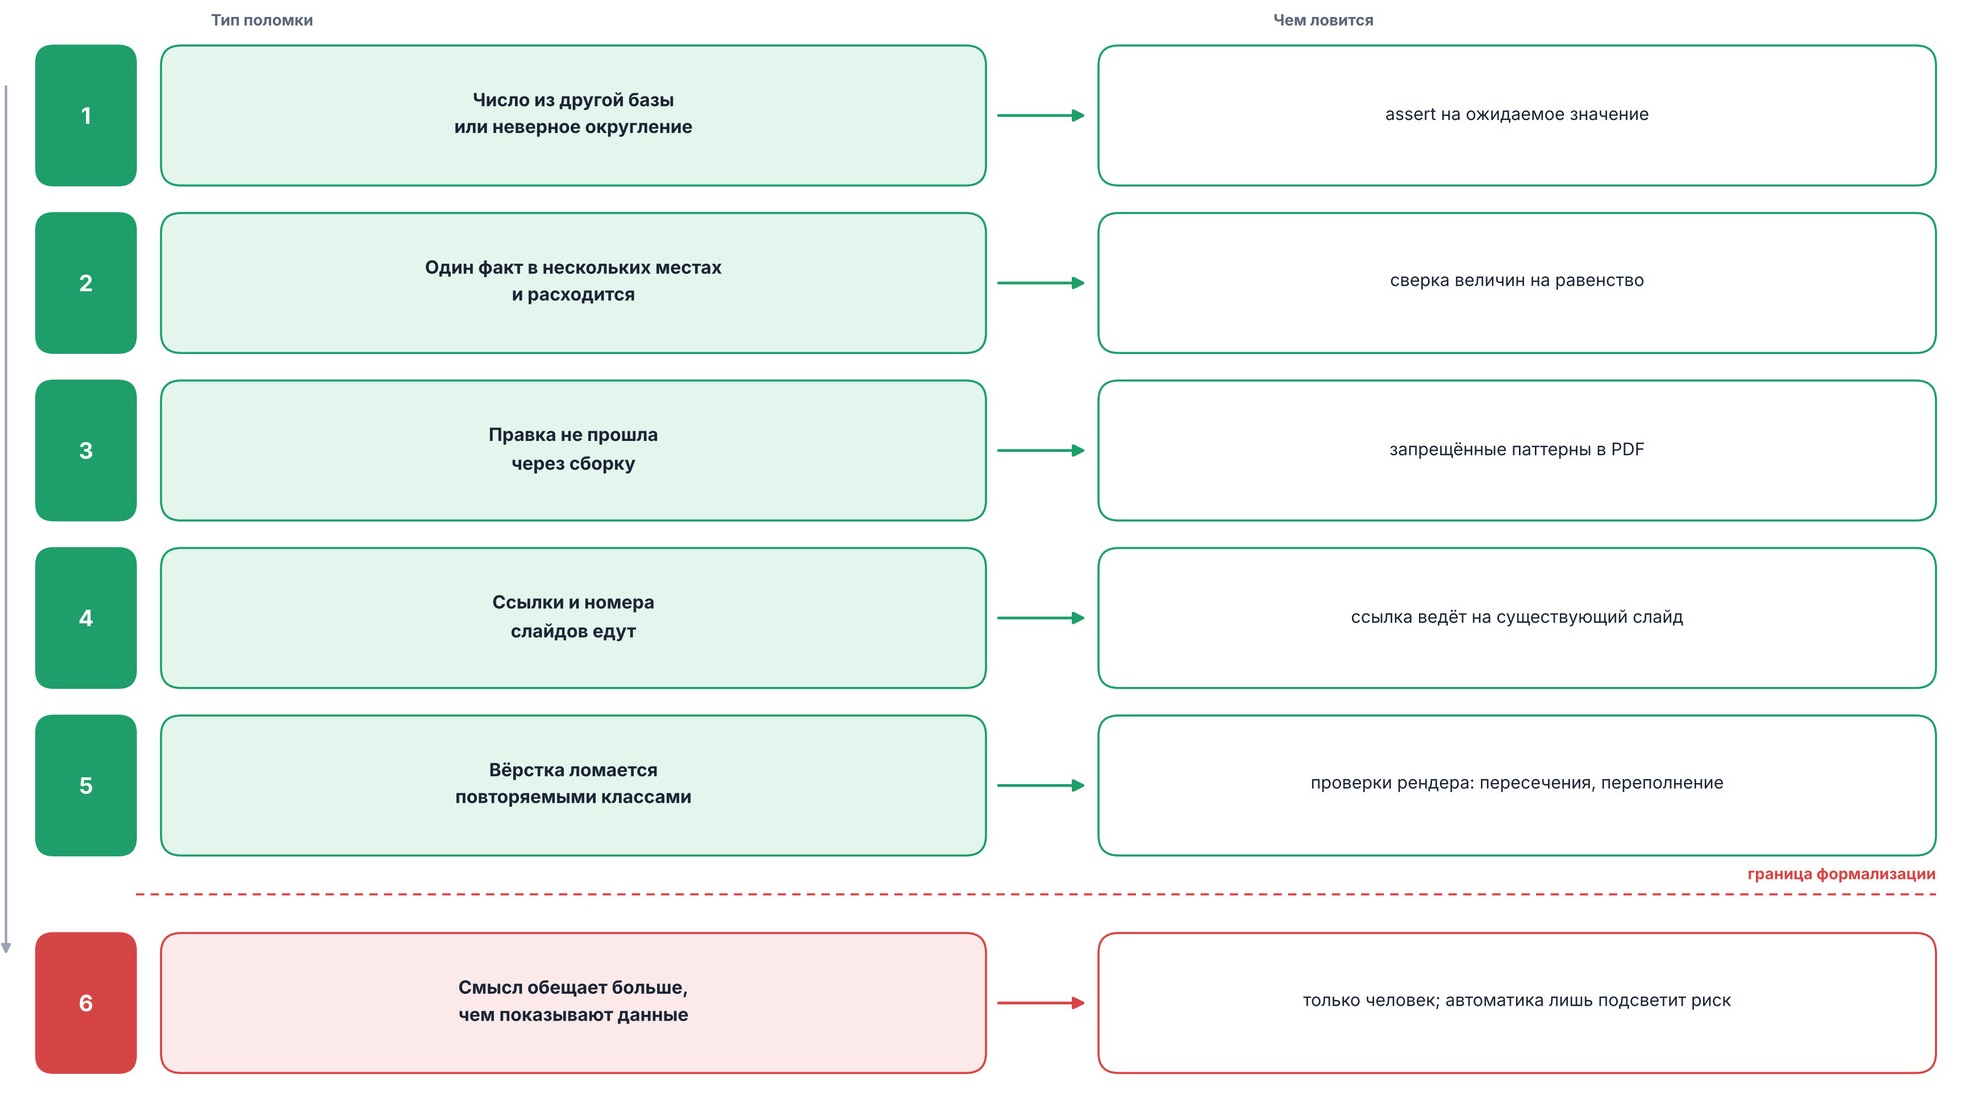
Когда чисел много и отчёт пересобирается не раз, ломается не только арифметика. Ломается связность: числа, текст, ссылки и выводы начинают жить своей жизнью. После нескольких раундов правок у меня сложилась типология таких проблем — от самых очевидных к самым коварным.
Число из другой базы или неверное округление. На слайде написано «42%», а после пересчёта источник отдаёт 43%. Или значение выглядит похожим на правильное, но посчитано по другой выборке. Внешне всё может быть аккуратно: число на месте, график построен, подпись не вызывает подозрений — но значение уже другое. Такой класс ошибок хорошо формализуется: можно зафиксировать ожидаемое значение и ронять сборку, если оно изменилось.
Один факт живёт в нескольких местах — и расходится. Одно и то же число нужно и на основном слайде, и в summary, и в финальном выводе. Если оно приходит из одного токена — проблемы нет: пересчитался источник, значение поехало сразу везде. Проблема возникает, когда один факт разложен на несколько независимых мест: на слайде число посчитано заново, в summary вписано руками, в выводе осталось число из прошлой версии. Это уже не ошибка расчёта, а ошибка связности. Лечится сверкой: величины, которые обязаны совпадать, проверяются на равенство, и расхождение роняет сборку.
Правка не прошла через сборку. Слайд переписан, тезис снят, метрика убрана — а старая формулировка всплывает ниже, на другом слайде или в summary. Иногда потому, что шаблон не обновился. Иногда потому, что сборка подтянула старую версию текста. Это можно ловить через запрещённые паттерны: если формулировка снята, она не должна возвращаться в готовый PDF.
Ссылки и номера слайдов едут. В тексте осталось «см. слайд 20», потом структуру переставили — и нужный слайд стал 23-м. Или ссылка ведёт на раздел, которого уже нет. Чем больше перекрёстных ссылок, тем чаще это происходит. Здесь правило тоже механическое: ссылка должна указывать на существующий слайд или раздел.
Вёрстка ломается по повторяющимся сценариям. Подпись налезает на ось, блок переполняется, заголовок графика перекрывает легенду. Обычно это не десятки уникальных багов, а несколько повторяющихся механизмов движка сборки, которые дают одни и те же ошибки. Их можно проверять автоматически: переполнение, пересечения, слишком длинные подписи, технические хвосты. Но это, конечно, только про повторяемые классы проблем, а не «красоту вообще».
Смысл обещает больше, чем показывают данные. Самый опасный тип — и единственный, где автоматика не заменит человека. График показывает наблюдение или корреляцию, а текст рядом уже заявляет причинность и эффект. Формально всё сходится: число верное, ссылка на месте, но вывод сильнее данных. Автоматическая проверка может подсветить риск, но решение всё равно остаётся за человеком.
Первые пять типов хотя бы частично формализуются: для них можно задать конкретные признаки поломки и проверить их на сборке. А последний — про интерпретацию, и здесь правила не спасут, разве что смогут подсветить проблемное место. Значит, и ревью имеет смысл разделить по этой границе: человеку оставить то, что требует критического мышления, а автоматике — то, что формализуется. Как именно — дальше.
Рисунок 1. Шесть типов ошибок в презентациях с большим объёмом данных и способы их выявления
Слайд — это рендер, а не источник истины
После нескольких раундов правок стало ясно: общий корень этих ошибок не в невнимательности, а в устройстве сборки. Проблемы появляются там, где число попадает в слайд напрямую, в обход единого источника: захардкожено в шаблоне, склеено в коде сборки, дописано руками при быстрой правке. Даже когда всё собирает скрипт, часть чисел нередко оказывается «прибита гвоздями» прямо в слайде. И возникают проблемы: обновились данные или поехала структура — слайды начинают противоречить сами себе, а сборка честно повторяет это противоречие на каждом прогоне.
Отсюда принцип, вокруг которого я перестроила сборку презентаций:
Слайд не должен быть местом, где живёт число. Слайд — это только рендер.
Конкретно у меня это пайплайн на Python, и разделение в нём простое:
- истина живёт в источнике — едином зафиксированном наборе рассчитанных метрик в JSON/YAML, из которого сборка берёт все числа;
- текст слайдов живёт в утверждённом Markdown-файле, где на месте чисел стоят токены;
- на сборке билдер поверх python-PPTX резолвит токены из источника и строит слайды — с нативными графиками (PPTX-объектами из тех же чисел);
- PPTX/PDF — это результат, последняя стадия конвейера, а не место, где что-то дописывается или правится руками.
Рисунок 2. Конвейер автоматической сборки презентации с проверками данных и готового отчёта
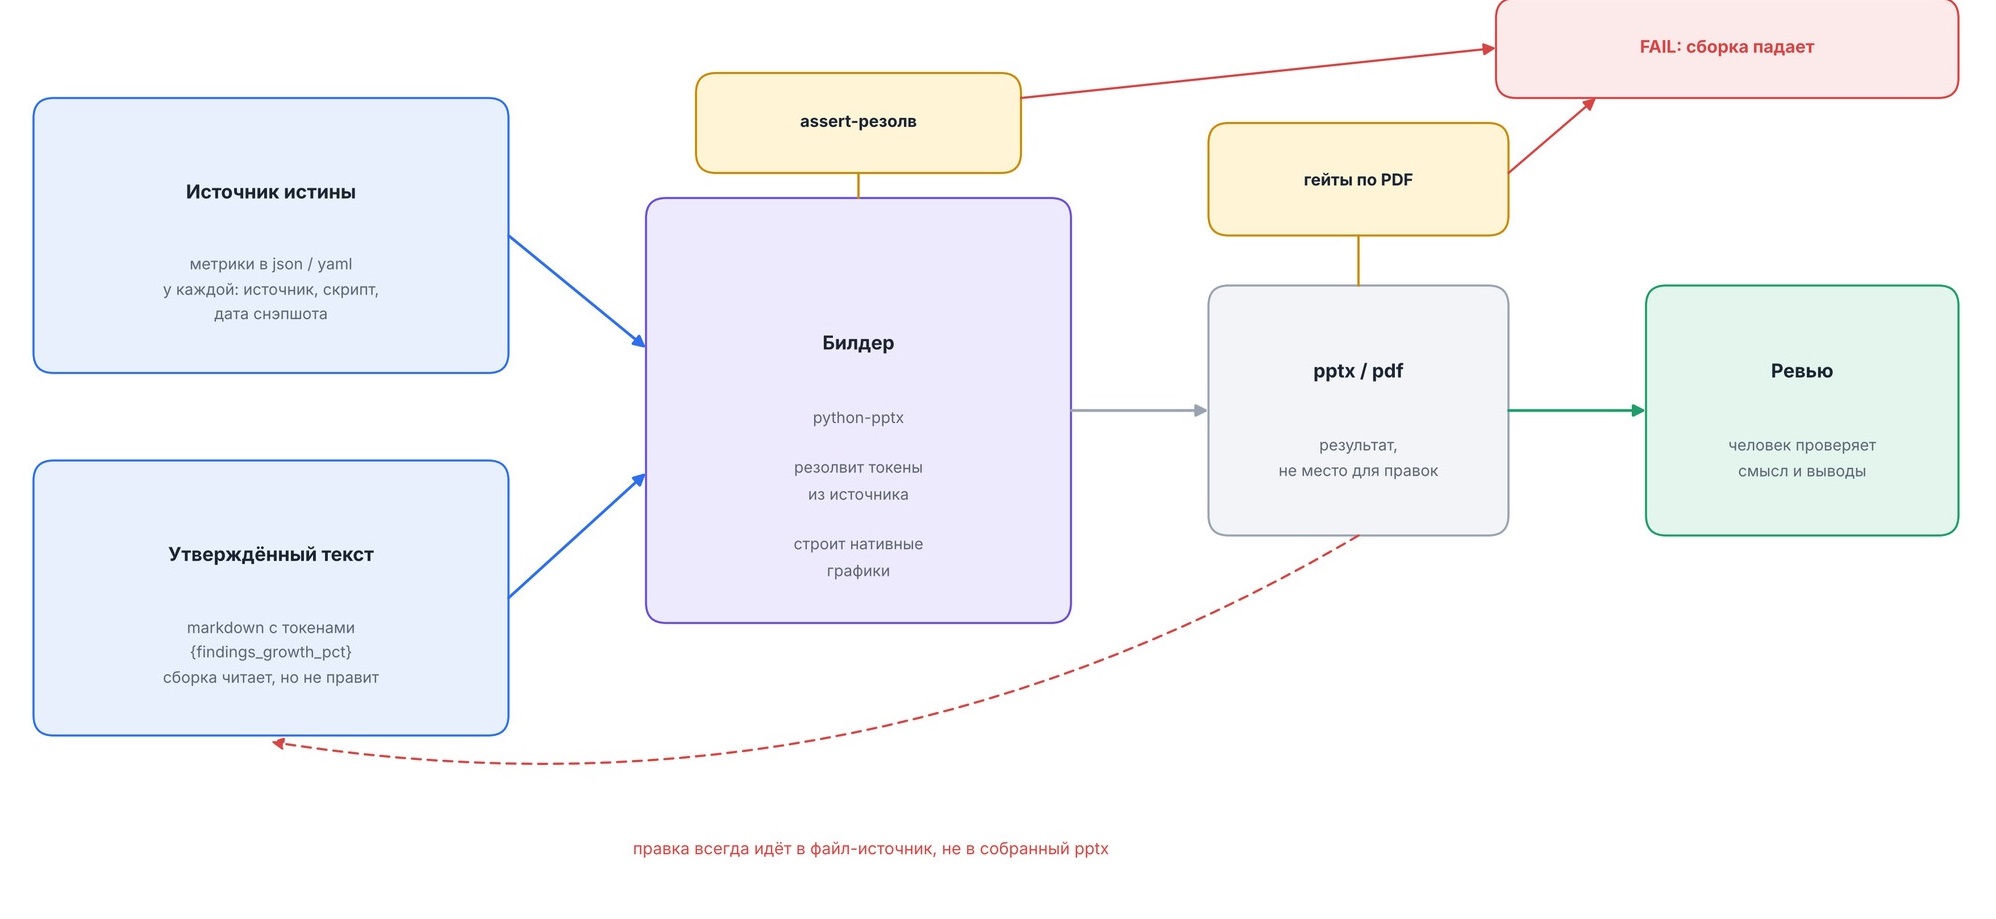
Ключевое здесь — то, что для каждой версии отчёта зафиксированы и набор данных, и текст. Утверждённые вычитанные формулировки живут в отдельном файле, который сборка читает, но не редактирует: только подставляет числа в токены и рендерит. На этапе сборки ИИ не меняет утверждённые формулировки, а я не правлю текст в собранном PPTX — правка всегда идёт в файл-источник, и уже оттуда попадает в сборку. Может, и выглядит как лишняя дисциплина, но именно это потом позволяет автоматически проверить: если тезис переписали или формулировку сняли, они не должны всплыть в готовом отчёте.
У каждого токена в источнике при этом есть запись о том, как метрика посчитана и на каких данных (источник, скрипт расчёта, дата снэпшота). Очень полезно: когда через неделю смотришь на цифру и не помнишь, откуда она, именно это позволяет её пересчитать и за неё отвечать.
Между этими стадиями встают проверки. Число подставилось — сверяем его с ожидаемым. Собрался PDF — прогоняем его через гейты. Если что-то разошлось, сборка не выдаёт «почти правильную» версию, а падает.
Дальше по конвейеру и пойдём: сначала токены в тексте, потом assert-проверки на сборке, потом гейты по готовому PDF.
Токены вместо чисел в тексте
Первый шаг — убрать числа из текста. В файле с текстом слайдов стоит не «42%», а токен: имя, под которым эта метрика лежит в источнике. Выглядит примерно так:
За период поток находок вырос на {findings_growth_pct},
а очередь на разбор — только на {queue_growth_pct}.
Пока это не слайд с конкретными цифрами, а шаблон смысла. Текст фиксирует, что именно мы хотим сказать, а сами значения приходят из источника на сборке. Формулировка пишется один раз и фиксируется; к самим цифрам она больше не привязана — их подставляет конвейер.
Даже без дополнительных проверок это уже многое даёт.
- Число сложнее вписать мимо источника. Если в тексте стоит токен, единственный способ получить значение — взять его из данных. Захардкодить (и потом забыть) «42%» в основном тексте становится сложнее.
- Одно имя — одно значение. Тот же {findings_growth_pct} на основном слайде, в summary и в выводе — это буквально одна и та же величина, подставленная в три места. Ей сложнее разъехаться между версиями текста.
- Опечатка в имени становится видимой. Если в тексте окажется {finding_growth_pct} вместо {findings_growth_pct}, токен просто не срезолвится — и это всплывёт на сборке, а не превратится в неверную цифру.
Рисунок 3. Использование единого токена для подстановки значения в разные части презентации
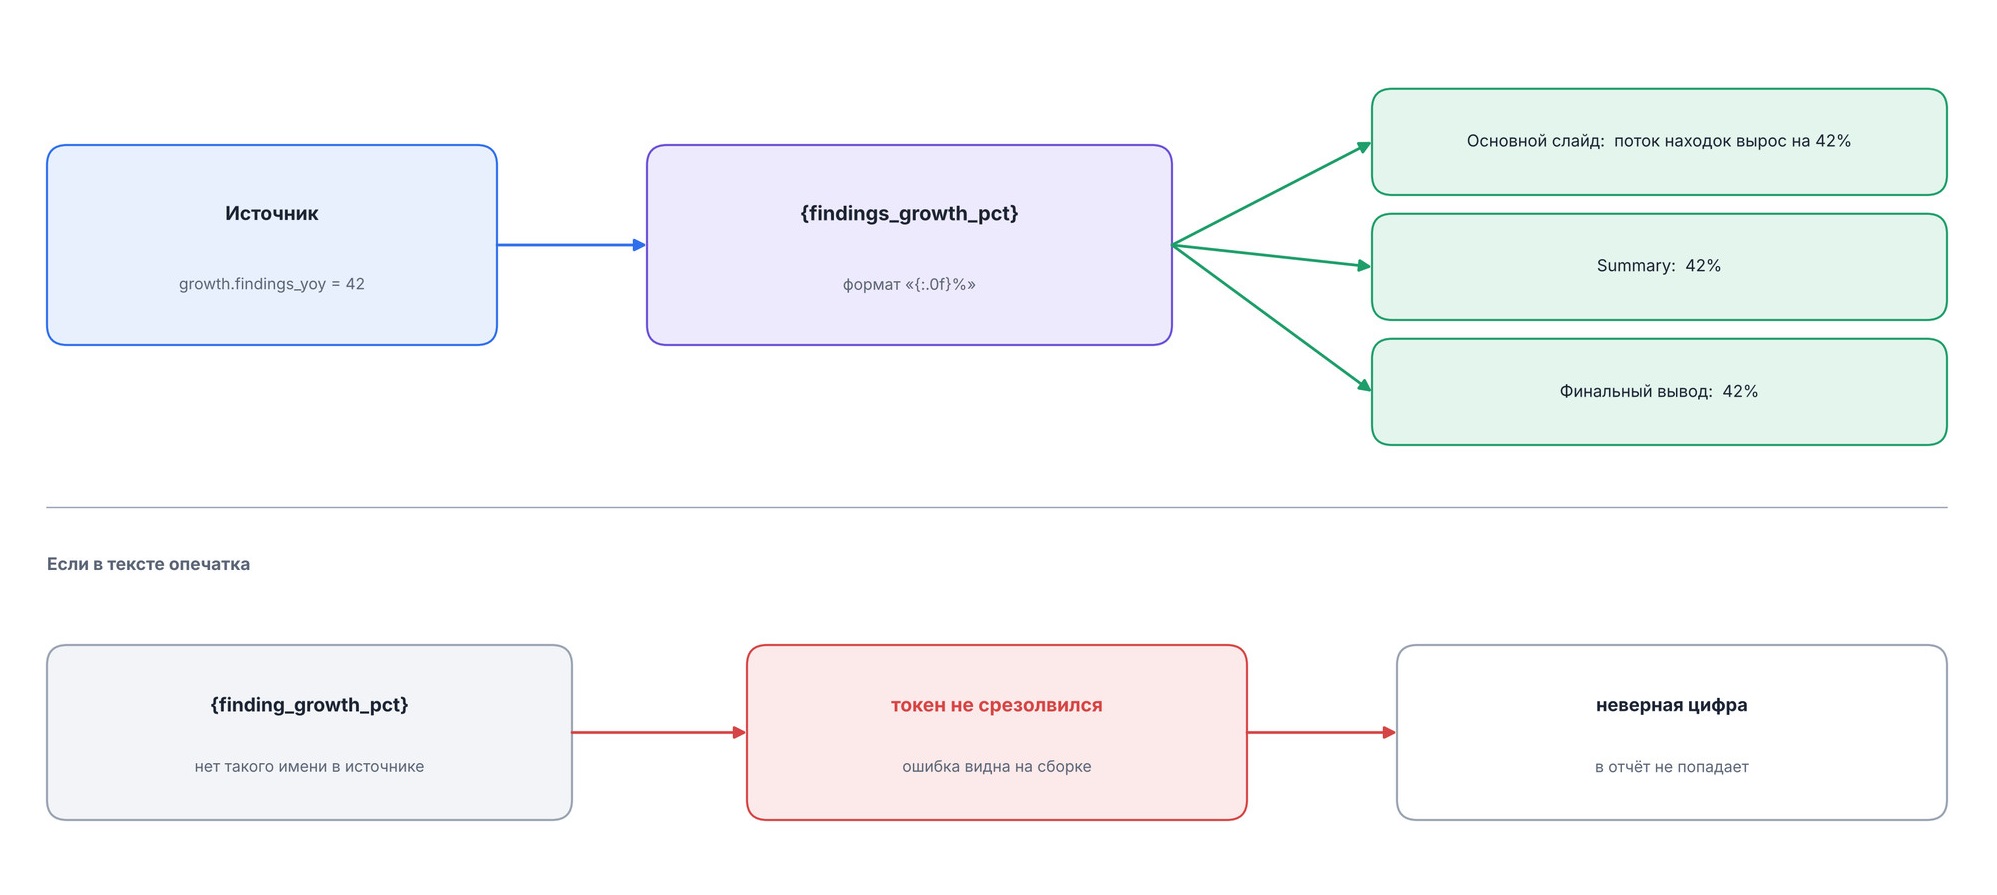
Но токены сами по себе не гарантируют, что значение правильное. Они честно подставят то, что лежит в источнике, даже если источник обновился, выборка поменялась или метрику пересчитали по новой логике. В результате в старую формулировку может встать новое число. Чтобы такие изменения не проходили мимо человека, на подстановку нужен assert. О нём — дальше.
Assert-резолв: дрейф значения должен ронять сборку
Вот здесь и живёт главная проверка. Когда токен резолвится, сборка не просто подставляет число из источника — она сверяет его с тем, которое я ожидала увидеть в этой версии отчёта.
Схематично привязка токена выглядит так:
findings_growth_pct:
  source: growth.findings_yoy  # откуда берём значение
  expected:  42                    # что я подтвердила для этой сборки
  tolerance: 0.5                       # допуск на округление
  format:    "{:.0f}%"                 # как показать в тексте
Source говорит, откуда взять число. expected фиксирует значение, которое я уже видела, проверила и утвердила. tolerance разрешает мелкое расхождение из-за округления. format определяет, как оно ляжет в текст.
Резонный вопрос: зачем фиксировать ожидаемое значение, если метрика и так берётся из источника истины? Но expected — не второй источник истины. Это контрольный снимок значения для конкретной версии отчёта. Он не говорит, какое число истинное, но заставляет человека явно принять изменение, если source начал отдавать другое значение.
Пока источник отдаёт 42 с учётом допуска, сборка идёт дальше. Если после обновления данных источник начинает отдавать 43, сборка останавливается:
FAIL  findings_growth_pct
expected 42, got 43  (tolerance 0.5)
Ничего не сломалось — наоборот, сработало как надо. Значение могло измениться законно: пришёл новый срез данных, поменялась выборка, уточнилась формула. Но сборка не должна молча подставить новое число в текст, который был написан и утверждён под старое.
Теперь у меня есть развилка:
- значение верное и новое — обновляю expected до 43 и проверяю/правлю формулировку/смысл вокруг;
- значение подозрительное — иду разбираться с данными, фильтрами или расчётом, а не чиню текст на слайде.
Рисунок 4. Проверка изменений метрик с помощью assert: остановка сборки при расхождении значений
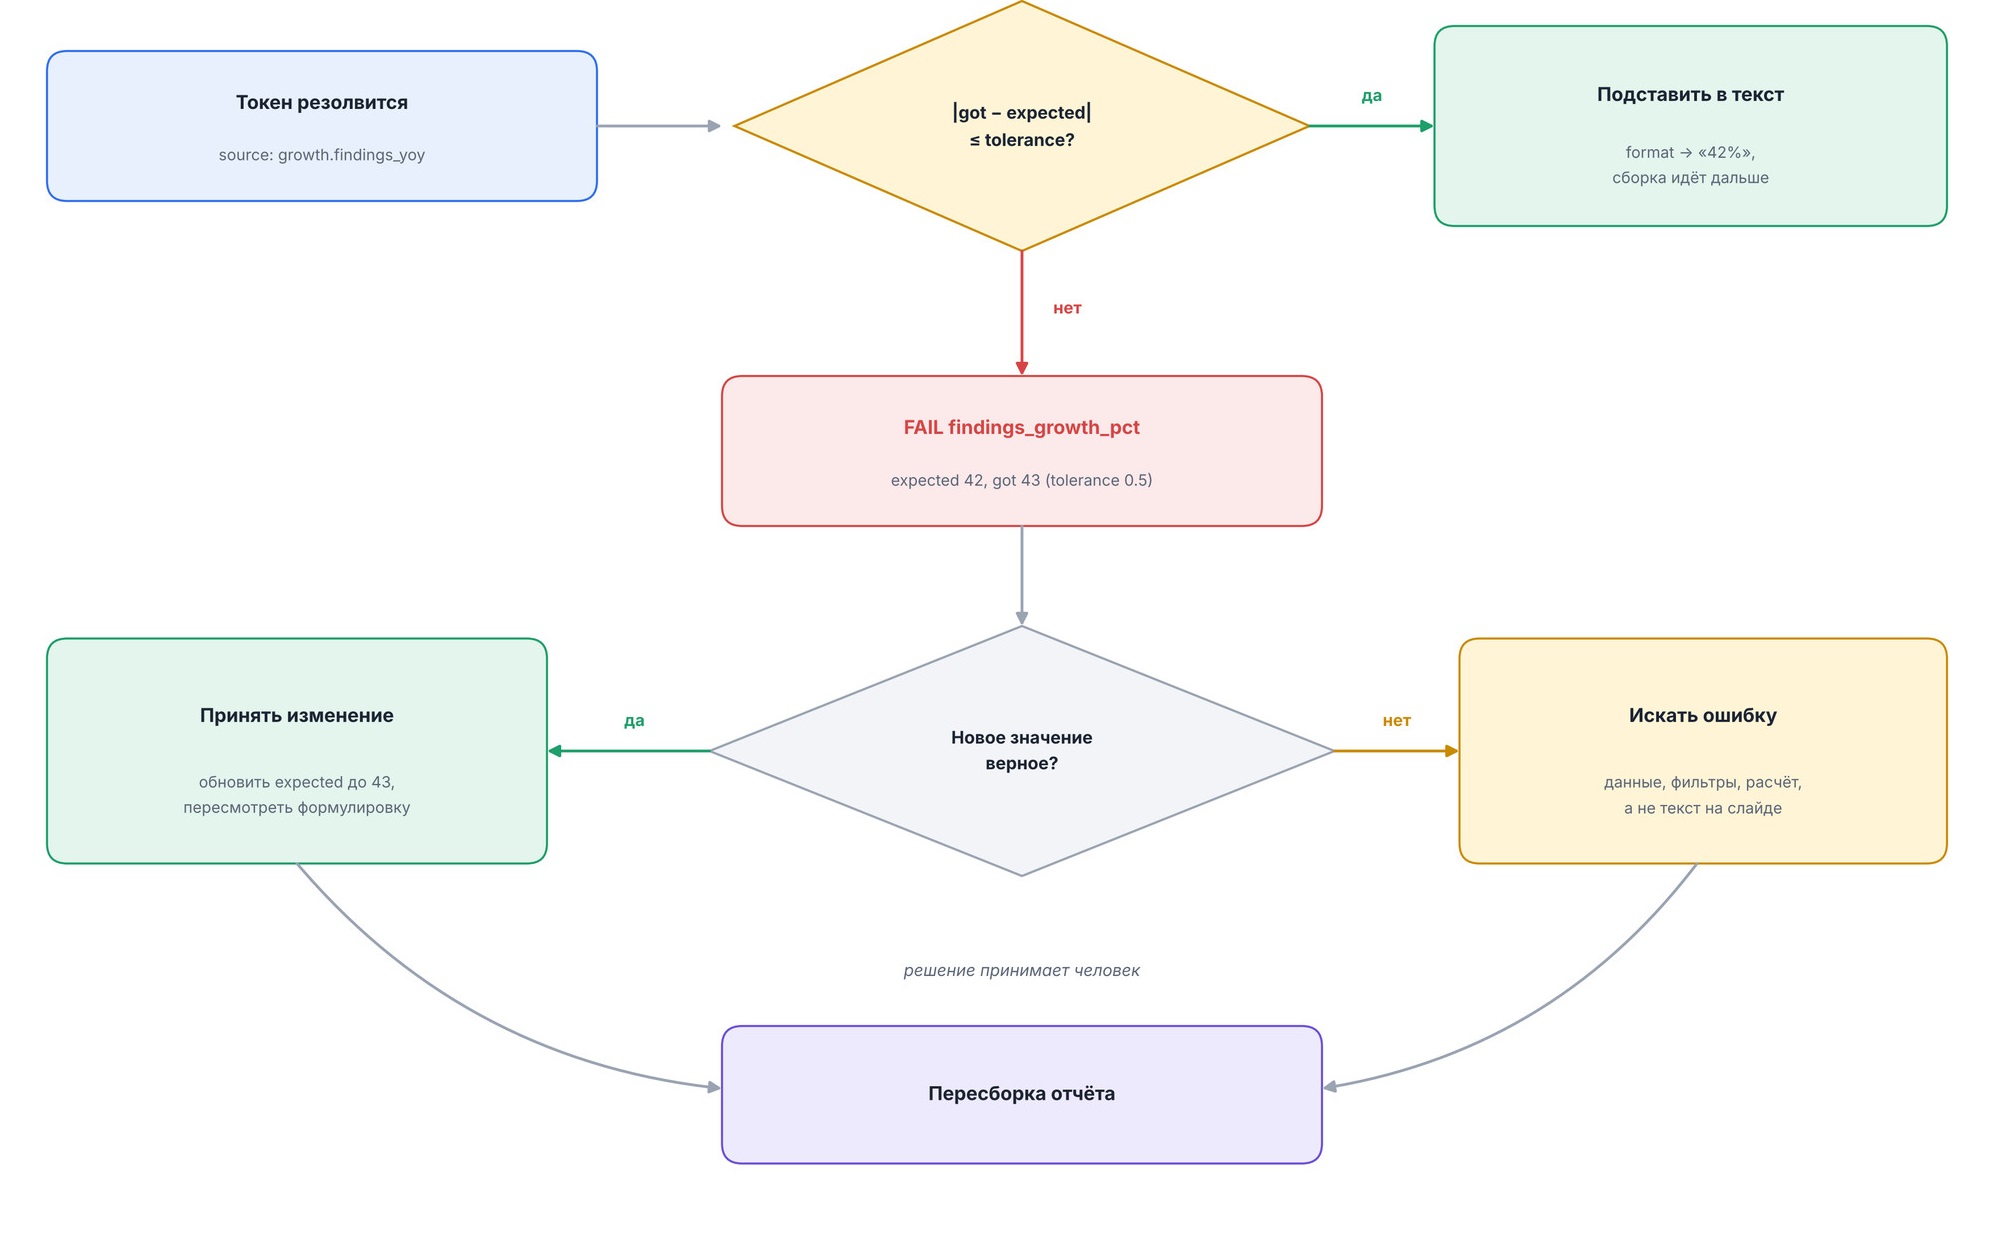
Суть простая: дрейф значения = падение сборки.
Раньше такое изменение легко могло пройти незамеченным: данные обновились, отчёт пересобрался, число поменялось, презентация выглядит готовой. Assert превращает тихую подстановку в явное решение: принять новое значение, пересмотреть текст или искать ошибку в расчёте.
Когда новую версию отчёта можно собрать за несколько минут, такие изменения начинают происходить гораздо чаще. Именно поэтому expected становится точкой ручного контроля. Он не позволяет новому значению незаметно попасть в уже написанный и вычитанный текст. Если число изменилось, его нужно осознанно принять, обновить выводы или разобраться, почему оно изменилось. ИИ может быстро пересобрать отчёт, но решение о том, что новому значению можно доверять, остаётся за человеком.
Стоит отметить, что assert окупается, когда дрейф — исключение; если меняется буквально всё и всегда, проверки надо укрупнять (assert на агрегаты/инварианты, а не на каждую метрику).
Гейты по готовому PDF
Assert следит за числами на входе. Но между «число подставилось» и «отчёт готов» ещё многое может пойти не так: текст собрался в PDF, слайды оказались в другом порядке, шаблоны отработали не так, графики отрисовались с ошибками. Поэтому вторая линия контроля стоит на выходе — на уже собранном файле. Это гейты, по аналогии с CI: отчёт не считается готовым, пока не прошёл через них.
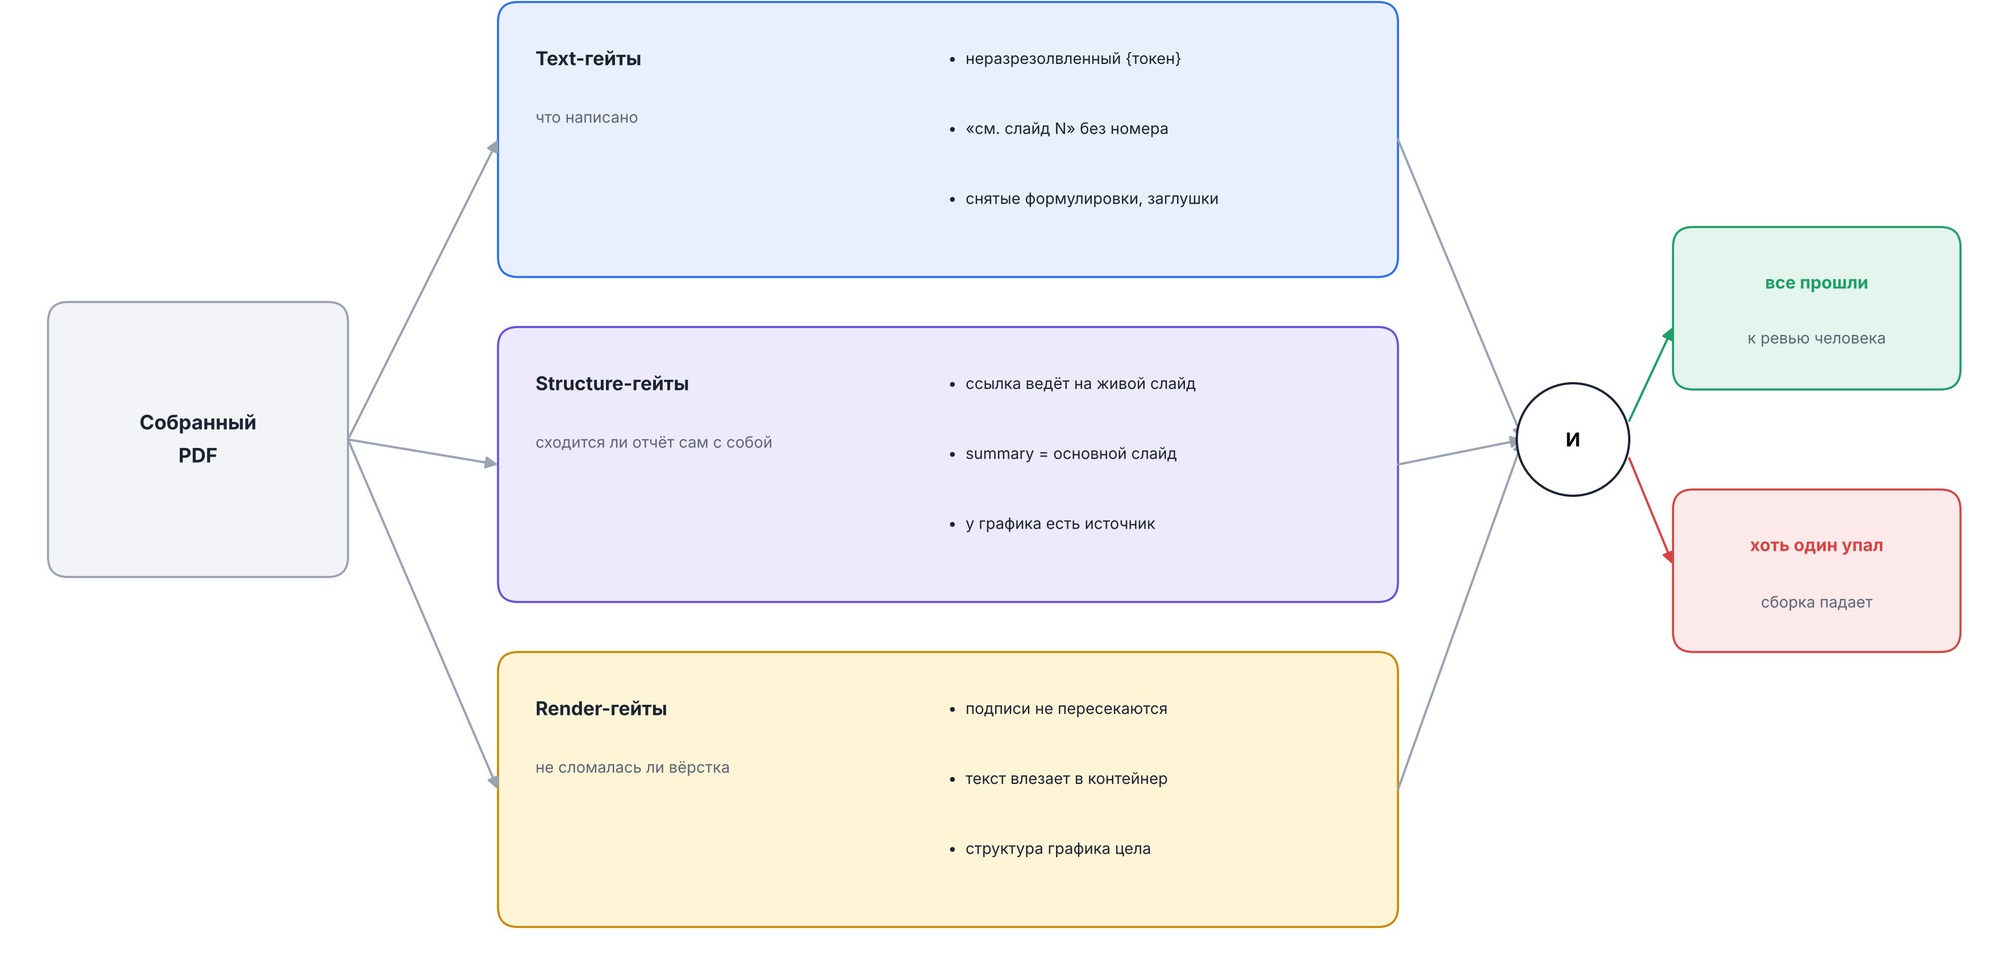
Гейты работают не с исходными данными, а с готовым артефактом: текстом, извлечённым из PDF, структурой слайдов и результатом рендера. Удобно делить их на три группы.
Text-гейты — что написано в тексте
Самая простая и при этом очень полезная группа. Из собранного PDF вытаскивается весь текст и проверяется на то, чего в финальной версии быть не должно:
FORBIDDEN = [
    r"\{[a-zA-Z0-9_]+\}",  # незарезолвленный токен
    r"см\. слайд N",       # шаблонная ссылка
    r"выросл(о|а|и)\s+в\s+разы",  # снятое на ревью преувеличение
]
Логика простая, почти примитивная — и в этом её сила. Гейт не понимает смысл презентации. Он не знает, обоснованный ли получился вывод. Но он точно знает, что {queue_growth_pct} не должно оказаться в готовом PDF.
Сюда же уходят снятые формулировки, устаревшие термины, следы отладки, временные заглушки — всё, что можно описать правилом: «такой строки в финале быть не должно».
Structure-гейты: сходится ли отчёт сам с собой
Здесь проверяется не отдельная строка, а согласованность артефакта:
- ссылка «см. слайд 12» указывает на слайд, который существует;
- число в summary совпадает с числом на основном слайде (этот гейт — подстраховка на случай, когда один факт по недосмотру завели двумя токенами);
- обязательные блоки на месте: у графика есть источник, у вывода — оговорка, у раздела — итог.
Такие гейты ловят ошибки, которые не всегда видны в пределах одного слайда. По отдельности всё может выглядеть правильно, а вместе — противоречить друг другу.
Render-гейты — не сломалась ли вёрстка
Графики — нативные объекты PowerPoint, поэтому их финальную раскладку определяет движок рендера. На этом же этапе вылезают повторяемые дефекты вёрстки: подпись налезает на ось, текст выходит за границы, заголовок перекрывает легенду, блок переполняется. «Красоту» автоматически не проверишь, но известные классы поломок — можно: не пересекаются ли текстовые элементы, помещаются ли подписи и значения в свои контейнеры, не поехала ли структура графика после рендера. Это контроль не качества дизайна, а повторяемых технических дефектов. Часть проверок я делаю на уровне PPTX-объектов, часть — уже по финальному PDF.
Общий смысл всех трёх групп один: отчёт выглядит готовым только после того, как прошёл гейты, а не после того, как отрисовался. PDF, в котором остался незарезолвленный токен, битая ссылка или наехавшая подпись, — это не готовый отчёт. Это отчёт, который пока не прошёл контроль.
Рисунок 5. Три уровня автоматической проверки готового PDF: текст, структура и вёрстка
Как ревью стало управляемым
До внедрения проверок каждый раунд ревью начинался почти с нуля: заново сверить числа с источником, пройтись по summary, проверить ссылки, поймать старые формулировки и посмотреть, не сломалась ли вёрстка. На сотнях чисел и нескольких пересборках это быстро превращается в работу человека-линтера: много внимания уходит на механические вещи, а на смысл остаётся меньше сил.
После токенов, assert-проверок и гейтов ревью разделилось на два слоя. Первый слой — формализуемый, его проверяет сборка. Если что-то не сходится, артефакт не доезжает до ручного ревью. Второй слой остаётся за человеком: поддерживают ли данные вывод, не выдана ли корреляция за причинность, правильно ли расставлены акценты, не перегружен ли summary, не обещает ли текст больше, чем показывает график.
Удобно думать об этом как о ярусах контроля:
- числа — assert-резолв ловит неверное округление, смену выборки и дрейф значения;
- сборка — text-гейты ловят снятые тезисы, заглушки и незарезолвленные токены;
- навигация — structure-гейты проверяют ссылки, номера слайдов, согласованность повторяющихся чисел и обязательные элементы;
- вёрстка — PPTX/PDF-гейты ловят повторяемые проблемы рендера и расположения элементов;
- смысл — человек проверяет причинность, атрибуцию, рамку вывода и приоритеты.
Рисунок 6. Распределение проверок между автоматической сборкой и человеком
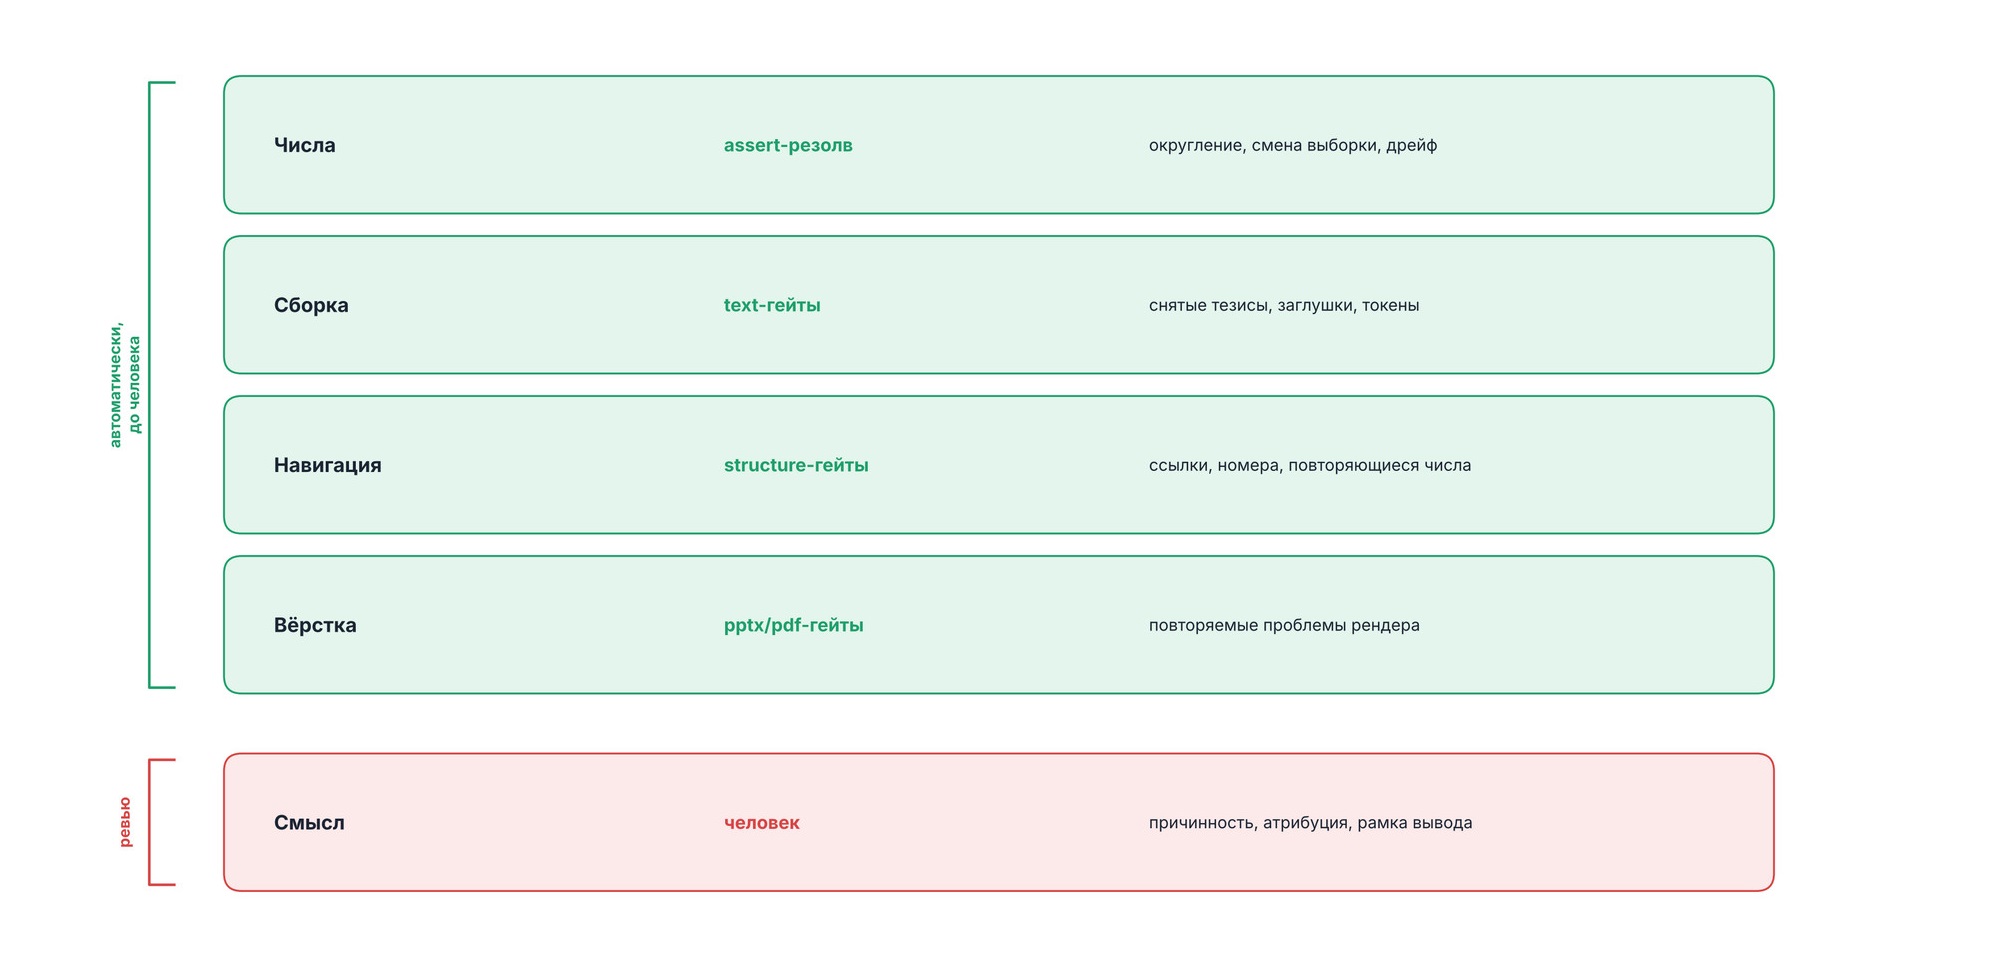
Главное изменение не только в том, что механические ошибки реже доходят до человека. Из ревью ушёл нижний слой работы, который можно описать правилами. Теперь оно начинается не с вопроса «а всё ли вообще сошлось?», а с вопроса «правильно ли мы это интерпретируем?».
Где это не нужно и что не ловит
Легко прочитать всё предыдущее как «стройте CI для любой презентации». Не стройте. У подхода есть цена, и на коротком артефакте она не окупается. Для разового короткого материала с несколькими числами токены, assert и гейты только добавят работы. Проще собрать руками и один раз внимательно вычитать. Такой контур стоит строить там, где артефакт:
- содержит много чисел, повторяющихся в нескольких местах;
- пересобирается не раз: данные обновляются, формулировки меняются;
- существует в нескольких версиях;
- уходит наружу, где ошибка дорого стоит;
- собирается автоматически, быстро порождая всё новые версии.
При этом проверки не оценивают смысл. Они поймают изменившееся число, битую ссылку, незарезолвленный токен или старый тезис, но не заметят, что корреляцию выдали за причинность, а в summary вынесли второстепенный вывод. Причинность, приоритеты и финальная рамка остаются за человеком.
Подход требует дисциплины: один токен — одно значение и один владелец; если то же число заводят вторым токеном, рано или поздно они разойдутся, и вся идея сломается. Ожидаемые значения надо обновлять осознанно, а не просто принимать новое число ради успешной сборки. Иначе контур формально остаётся, но доверять ему уже нельзя.
Выводы
ИИ сильно снизил стоимость сборки data-heavy отчётов: теперь быстрее написать код, собрать шаблон, пересчитать метрики и получить аккуратный PDF. Но ровно поэтому проверка результата не может оставаться только ручной: артефакты стали появляться быстрее, чем их успеваешь вычитывать.
Я решаю это не тем, что вычитываю ещё внимательнее, а тем, что часть контроля переношу внутрь самой сборки. Всё, что описывается правилом, проверяется до человека: токены, значения, ссылки, снятые формулировки, повторяемые дефекты вёрстки. Тогда ручное ревью начинается не с механической сверки всего подряд, а с того, ради чего оно действительно нужно: смысла, акцентов и финальной рамки вывода.
ИИ может помочь собрать отчёт. Но отвечать за то, чему в этом отчёте можно доверять, всё равно должен человек. Для аналитика это значит одно: мало правильно посчитать метрику — нужно построить контур, в котором она не изменится незаметно.


