


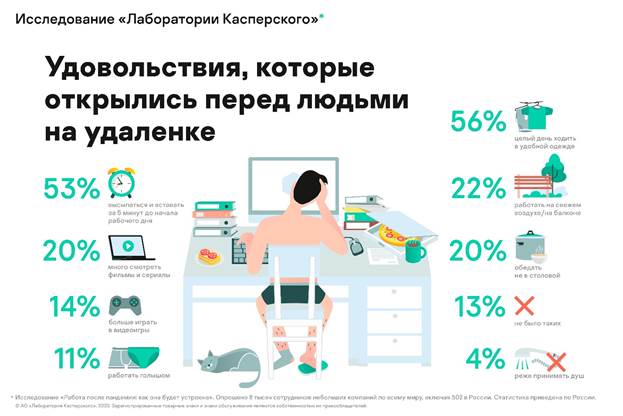

11% сотрудников работают на удалёнке без одежды, 4% — реже принимают душ

11% сотрудников работают на удалёнке без одежды, 4% — реже принимают душ

11% сотрудников работают на удалёнке без одежды, 4% — реже принимают душ

Как выяснили аналитики «Лаборатории Касперского», проведя опрос среди работающих дистанционно граждан, каждому десятому сотруднику нравится работать без одежды. Именно за такой комфорт люди ценят удалёнку.

Согласно данным опроса, проведённого «Лабораторией Касперского», 55% работающих удалённо сотрудников надевают удобную одежду в рабочие часы. При этом 11% предпочитают вообще обходиться без неё.

53% респондентов очень нравится, что проснуться можно буквально за несколько до начала рабочего дня, а в перерывах вообще есть возможность полежать на удобной домашней кровати.

22% опрошенных сообщили, что ценят возможность работать на свежем воздухе — на балконе, например. 20% полюбили обедать дома, а не в столовой. Нашлись и грязнули: 4% респондентов нравится, что душ можно принимать реже.


Подробно с исследованием «Лаборатории Касперского» под названием «Работа после пандемии: как она будет устроена» можно ознакомиться по этой ссылке (PDF). Аналитики опросили 8 тысяч человек по всему (502 сотрудника российских компаний).

Подпишитесь на новости

1,8 ТБ и вагон ошибок: как выгрузка с Яндекс Диска превратилась в квест

Пользователь «Яндекс Диска» решил сделать резервную копию 1,8 ТБ файлов, а также примерно 160 ГБ фотографий и получил приключение с ошибками API, зависшими загрузками и собственными скриптами.

По его словам, после октябрьских проблем с дата-центрами привычное скачивание папок через веб-интерфейс стало недоступно.

Подробности инженер Сергей Терёхин, известный как KenGuru66, описал  в собственном разборе на Хабре.

План был такой: rclone, сервер в Нидерландах, копия в Google Drive. Но стандартная аутентификация позволяла получить сведения о диске, а обращения к файлам возвращали ошибку 410. Доступ удалось наладить с другим OAuth-токеном.

Фотографии из безлимитной автозагрузки добавили веселья: для копирования через выбранный API их пришлось переместить в обычную папку. После этого они начали занимать место в тарифе. Более 30 тысяч снимков переносились около шести часов.

В выборке из 300 случайных файлов автор смог получить начало только 146. По важной папке с документами он скопировал и проверил по MD5 2315 файлов; ещё 3079 на момент публикации оставались недоступны.

Потерю данных автор не утверждает, он продолжает повторные загрузки. Скрипты опубликованы на GitHub.

RSS: Новости на портале Anti-Malware.ru