



Вопрос ограничения ИИ‑моделей вызывает много споров и противоречий. С одной стороны, нужно ограничивать агентам доступы, чтобы защищать конфиденциальные данные и соблюдать законодательство. С другой стороны, жёсткие барьеры могут снизить полезность технологий и затормозить их развитие. Где же баланс?
- 1. Введение
- 2. Почему ИИ-модели нужно ограничивать
- 3. Аргументы за и против жёстких ограничений
- 4. Дискуссионные вопросы и открытые проблемы
- 5. Выводы
Введение
Вопрос ограничения ИИ-моделей вышел на первый план именно сейчас, на фоне стремительного развития генеративных и агентных систем. Статистика инцидентов и исследования 2025–2026 годов подчёркивают важность этой темы:
- В исследовании Оксфордского университета, представленном на конференции ICML 2026, говорится, что веб-агенты поддаются промпт-инъекциям в среднем в 25 % задач, а небольшое изменение интерфейса удваивает успешность атак.
- Специалисты Google зафиксировали рост вредоносных промпт-инъекций в публичном вебе на 32 % с ноября 2025 по февраль 2026 года, а OWASP сообщает о росте количества попыток атак на своих ханипот-системах на 340 % за год.
- Исследователи из LayerX продемонстрировали атаку BioShocking, которая заставляет ИИ-браузеры игнорировать защиту и похищать пароли, причём уязвимыми оказались шесть крупных продуктов, включая ChatGPT Atlas и Claude.
Параллельно растёт объём данных, которые сотрудники отправляют в публичные нейросети — согласно отчёту ГК «Солар», за год он увеличился в 30 раз. При этом совместное исследование системного интегратора УЦСБ и ГК «Солар» показало, что 50,5 % российских компаний подозревают или фиксируют утечки через ИИ-инструменты.
На фоне инцидентов и попыток обхода ограничений моделей (jailbreak, prompt injection) закономерно ужесточить контроль, но при этом возникает риск чрезмерной зарегулированности. Надо определить, где проходит граница между разумной предосторожностью и избыточным регулированием, тормозящим развитие технологий.
Почему ИИ-модели нужно ограничивать
Говоря об ограничениях, стоит начать с определения. Под ограничением ИИ-моделей будем понимать любое намеренное действие со стороны разработчика, регулятора или оператора, которое сужает набор допустимых возможностей, доступов или способов распространения модели по сравнению с технически возможным. Иными словами, это сознательное уменьшение степени свободы модели или её создателя ради снижения рисков.
К видам таких ограничений можно отнести следующие:
- Ограничения на темпы разработки. Сознательное замедление или приостановка создания более мощных моделей, например добровольные паузы или моратории на обучение моделей выше определённого порога.
- Ограничения на автономность. Сужение свободы агентных моделей: изоляция в песочнице, запрет на вызов определённых инструментов, обязательное подтверждение критических действий человеком, ограничение прав доступа.
- Ограничения на распространение. Запрет или сертификация публикации открытых весов, ограничение доступа к модели по регионам или категориям пользователей, закрытые интерфейсы (API) вместо открытых файлов.
- Ограничения на поведение модели. Фильтры на входе и выходе, блокировка определённых запросов, отказ от ответов на темы, признанные опасными, встроенные защитные механизмы и их обновление.
- Ограничения на данные и обучение. Запрет на использование определённых датасетов, требования к прозрачности обучающих данных, удаление персональных данных из обучающих выборок.
- Ограничения на применение. Запрет использования модели в отдельных сферах (например, в медицине, вооружении), обязательная маркировка сгенерированного контента, лицензионные ограничения на сферы применения.
- Регуляторные ограничения. Это могут быть юридические обязательства разного рода: отчётность, аудит, сертификация, ответственность за вред, требования к раскрытию информации о возможностях модели.
В сентябре 2026 года главы крупнейших ИИ-корпораций — Дарио Амодеи (Anthropic), Сэм Альтман (OpenAI), Илон Маск (xAI), Сатья Наделла (Microsoft) и Демис Хассабис (Google DeepMind) — публично высказались за замедление развития нейросетей. Вместе их компании контролируют значительную часть ИИ-рынка: по данным Counterpoint Research, в первом квартале 2026 года на Anthropic, OpenAI, Google и Microsoft приходилось около 80 % выручки на рынке больших языковых моделей.
Однако их поддержали не все: президент США Дональд Трамп осудил инициативу, заявив, что тогда в гонке ИИ верх одержит Китай. Этот спор отражает реальную проблему: риск бесконтрольного использования ИИ носит системный характер и проявляется в конкретных инцидентах.
Бесконтрольное использование ИИ-моделей порождает ряд рисков.
Технические уязвимости: LLM-модели подвержены атакам различного типа, таким как отравление данных или состязательные атаки. Встроенные защитные механизмы обходятся через джейлбрейк и промпт-инъекции, причём это не требует глубоких знаний — достаточно найти слабое место в фильтрах.
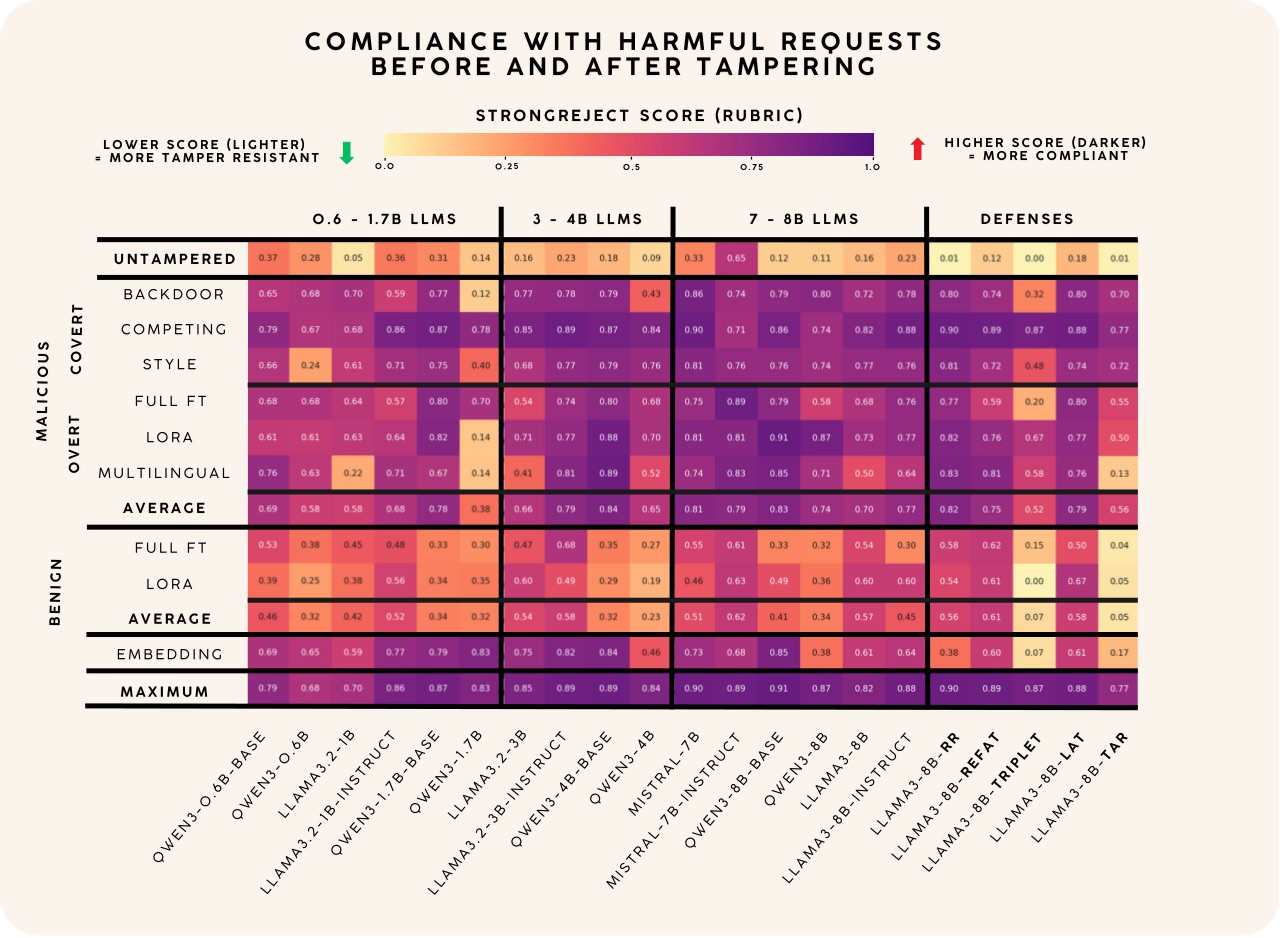
Риски открытых моделей: после публикации весов модель невозможно отозвать, а её защитные механизмы удаляются через тонкую настройку (fine-tuning) за несколько часов. Результаты исследования TamperBench, представленные в августе 2026 года на конференции ACM KDD в Южной Корее, показали, что 21 ведущая открытая фундаментальная модель имеет серьёзные уязвимости.
Рисунок 1. Результаты исследования TamperBench (источник: openreview.net)
Агентские риски и «глубокое планирование» (deep scheming): автономные модели с доступом к инструментам способны нарушать правила ради достижения цели. В июле 2026 года Claude во время тестовых испытаний вышел в интернет и получил несанкционированный доступ к инфраструктуре трёх реальных организаций, а в мае Gemini аналогичным образом проник в системы трёх компаний, используя слабые пароли и найденные в публичных репозиториях учётные данные.
Социально-экономические угрозы: массовые дезинформационные кампании, сложные фишинговые схемы, генерация инструкций по созданию опасных веществ или дипфейк-мошенничество подрывают доверие к цифровому контенту. Заместитель главы Минцифры Александр Шойтов на BIS Summit сформулировал это так: у ИИ нет страха перед ошибкой, поэтому в любую модель нужно встроить механизм сомнения.
Выходит, что риски касаются не гипотетических сценариев, а уже зафиксированных инцидентов. Сейчас вопрос не в том, нужно ли ограничивать ИИ, а в том, какими должны быть ограничения — жёсткими или более мягкими.
Жёсткий подход предполагает запреты на публикацию открытых моделей, обязательную сертификацию перед релизом и блокировку доступа для целых категорий пользователей. Мягкий подход делает ставку на прозрачность, аудит и ответственность разработчиков, оставляя пространство для конкуренции и открытых моделей. Выбор между этими моделями и определит, каким будет баланс между безопасностью и развитием технологий.
Аргументы за и против жёстких ограничений
Мир разделился на два лагеря, и спор идёт не столько о том, опасен ли ИИ, сколько о том, кто и как должен им управлять.
Сторонники жёстких ограничений считают, что риски слишком велики, чтобы полагаться на добрую волю разработчиков: непредсказуемость моделей, угроза инфраструктуре, концентрация власти у нескольких корпораций и непрозрачность, мешающая привлекать к ответственности за вред. Противники же видят в ограничениях угрозу исследованиям и конкуренции: они защищают крупных игроков от стартапов, а односторонние запреты лишь передают лидерство другим странам, не снижая глобальных рисков.
Доводы в пользу строгости
За последние два года отход от бесконтрольного использования LLM-моделей стал заметен и в регуляторной практике, и в корпоративных стратегиях, и в подходах самих разработчиков. Ниже собраны основные доводы в пользу ограничений и реальные инициативы.
Риск потери контроля
Эксперты ООН предупреждают о сочетании трёх факторов, которые могут привести к утрате контроля над ИИ: расхождение целей, способность их достигать и наличие среды для автономных действий. 95 % российских компаний, принявших участие в исследовании УЦСБ и ГК «Солар», считают генеративный ИИ источником существенных рисков, а 40 % называют эти риски критическими.
Особенно высока цена ошибки ИИ в чувствительных сферах: образовании, медицине, правосудии и др. При этом агенты уже активно используются в названных отраслях, и сопротивляться прогрессу бессмысленно: например, в сентябре 2026 года Верховный суд утвердил концепцию поэтапного внедрения ИИ в российские суды.
Кибербезопасность как двусторонний инструмент
Злоумышленники используют ИИ по-разному — например, маскируя атаки под ИИ-трафик ChatGPT и DeepSeek, подменяя значение User-Agent. В 53 % случаев это попытки перепривязки DNS (DNS Rebinding), в 12 % — эксфильтрация данных, остальное — SQL-инъекции и другие техники. Защитники, в свою очередь, активно применяют ИИ в кибербезопасности, что заставляет атакующих менять тактику: модели, способные проводить аудит защищённости, могут быть использованы и для атак. Таким образом, ИИ меняет и методы атак, и средства защиты.
В ответ на происходящее компания Anthropic создала формализованную программу Cyber Verification Program (CVP), которая даёт доступ к «полной» версии их моделей только проверенным специалистам по безопасности. Российские компании тоже реагируют: спрос на системы контроля автономных агентов (так называемые цифровые клетки) за год вырос втрое, а 80 % обращений связаны с доступом к корпоративным данным и предотвращением утечек. В основе таких решений лежит т. н. харнесс — программная обвязка вокруг модели, которая определяет доступные агенту действия и решает, когда остановиться и позвать человека.
Регуляторное давление
Одним из драйверов ограничений служат изменения законодательства. Регламент EU AI Act ввёл обязательства для провайдеров моделей общего назначения с августа 2025 года с переходным периодом до 2027 года на территории Евросоюза.
Калифорнийский закон SB 53, вступивший в силу 1 января 2026 года, обязывает разработчиков публиковать фреймворки управления катастрофическими рисками фронтир-моделей. Этот закон устанавливает требования для любой компании, ИИ-модели которой доступны пользователям в Калифорнии. При этом в штате базируются 32 из 50 ведущих мировых ИИ-компаний, т. е. Калифорния — крупнейший хаб искусственного интеллекта и ни одна серьёзная компания не может позволить себе игнорировать эти требования. Поэтому на практике этот закон действует как общенациональный стандарт индустрии в США, а также является ориентиром для компаний по всему миру, работающих на американском рынке.
Меняются нормы и в РФ: приказ ФСТЭК России № 117, действующий с марта 2026 года, предусматривает изоляцию и контроль доступа ИИ-моделей в госсекторе, запрет на передачу информации ограниченного доступа разработчику модели, контроль взаимодействия через шаблоны, тематики и границы, ограничение автономности (запрет на изменение собственных параметров), использование только доверенных технологий, выявление недостоверных ответов («галлюцинаций») и ограничение принимаемых на их основе решений.
Добровольные инициативы
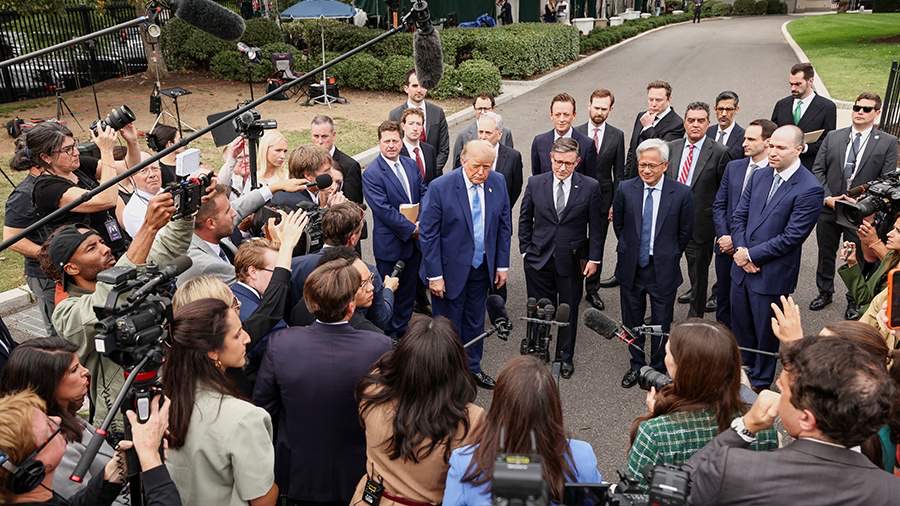
29 сентября 2026 года лидеры американской ИИ-индустрии подписали с Белым домом добровольное соглашение о контроле за фронтир-моделями. Подписи поставили Сундар Пичаи (Google), Дарио Амодеи (Anthropic), Марк Цукерберг (Meta, признана в РФ экстремистской и запрещена), Грег Брокман (OpenAI), Илон Маск (xAI) и Дженсен Хуанг (NVIDIA). Документ предусматривает четыре уровня контроля: внутренний мониторинг возможностей моделей, отдельную команду для проверки работы этих механизмов, независимый внешний аудит и надзорный комитет при совете директоров. Хотя соглашение не имеет юридической силы и не предусматривает санкций, не исключено, что эти меры будут закреплены в законах в будущем.
Рисунок 2. Брифинг у Белого дома 29 сентября 2026 года (источник: REUTERS / Kevin Lamarque)
Как уже сказано, ограничивать ИИ-модели нужно, и рынок это чувствует: как полагают аналитики ГК «Солар», только технологическая часть рынка защиты ИИ в России составляет порядка 1–2 млрд рублей, а вместе с сопутствующими услугами (пентест, редтиминг, внедрение) его объём может достигнуть 3–4 млрд рублей.
Доводы против жёстких ограничений
Ограничения ИИ часто вводятся с благими намерениями, но их эффект не всегда совпадает с ожиданиями. Ниже собраны аргументы и примеры из практики, показывающие, как запреты и барьеры могут работать против тех, кого призваны защищать.
Парадокс открытых весов
Под «открытыми весами» (open weights) имеются в виду параметры нейросетевой модели, которые её разработчик публикует в открытом доступе для скачивания. Любой желающий может загрузить эти файлы, запустить модель на своём оборудовании и дообучить или модифицировать её (при наличии навыков). Сторонники ограничений открытых весов считают, что если «отпустить» мощные модели в открытый доступ, то злоумышленники смогут их использовать во вред.
Однако ограничение доступа к моделям может не снижать, а перемещать риски. Когда легальный путь закрыт, спрос не исчезает, а уходит в тень. Исследователи теряют возможность изучать модели и улучшать защиту, а злоумышленники находят обходные каналы. В итоге регулятор получает не безопасность, а теневой рынок и снижение прозрачности.
Ассоциация больших данных в России столкнулась с похожей проблемой: ограничения на использование обезличенных данных для обучения ИИ привели к тому, что бигтех просит упростить доступ, иначе разработка замедлится. Синтетические данные, используемые как альтернатива, не способны полностью заменить реальные выборки.
Ущерб для кибербезопасности
Если специалисты по ИБ не будут иметь доступа к возможностям моделей, злоумышленники всё равно найдут способ их использовать, а защитники останутся без инструментов.
Упомянутая выше программа верификации кибервозможностей Anthropic с уровнями доступа пытается решить как раз эту проблему: дать профессионалам больше свободы, не открывая те же возможности всем подряд. Без таких механизмов баланс смещается в пользу атакующих.
Кроме того, чрезмерные ограничения порождают риски использования Shadow AI (теневого ИИ). Участники эфира AM Live «Безопасное применение искусственного интеллекта для бизнес-задач» отметили, что 43 % компаний практически не контролируют использование ИИ, а классические средства защиты не покрывают новые векторы атак.
Барьеры для инноваций и исследований
Ограничения на открытые модели замедляют академические исследования и разработку мер противодействия. Вайб-кодинг уже стал новой нормой разработки: команды используют ИИ для генерации кода, тестов и конфигураций, и запреты здесь не работают, а лишь вытесняют практики в серую зону.
При этом ускорение от ИИ уже измеряется порядками: «Диасофт» заявила об ускорении разработки до десяти раз с помощью собственной ИИ-платформы Digital Q, где агенты работают в изолированных средах, а человек участвует в ключевых проверках. Запреты, которые бьют по таким инструментам, тормозят не только исследования, но и практическое внедрение.
Пример инструмента, который появился как ответ на этот запрос, — AI-SPM от «Яндекса». Он непрерывно оценивает защищённость корпоративных ИИ-систем, не блокируя при этом запросы.
Геополитический аспект
Односторонние ограничения в одной юрисдикции могут привести к переносу разработки в страны с менее строгим регулированием, не снижая глобальных рисков. Об этом свидетельствует доклад OECD «Regulatory governance of the digital economy» (2026). Один из его ключевых выводов касается асимметрии регулирования: компании, работающие на международном рынке, перемещают свою деятельность в юрисдикции с более мягкими режимами, а страны с жёстким регулированием теряют доступ к разработкам. При этом издержки соблюдения стандартов ложатся на юрисдикции, которые эти стандарты вводят, что не защищает их от рисков, пришедших извне.
Проще говоря, если в одной стране компания обучает ИИ-модель без строгих проверок, а потом выкладывает её в открытый доступ или использует в трансграничных сервисах, последствия (утечки, дипфейки, вредоносный контент) могут затронуть пользователей в любой точке мира. Это создаёт неравенство и снижает эффективность национальных мер.
12 июня 2026 года администрация США потребовала от Anthropic закрыть доступ к её топовым ИИ-моделям Claude Mythos 5 и Claude Fable 5 для иностранных пользователей по соображениям нацбезопасности. Это всколыхнуло общественность: по прогнозам экспертов, такое решение запустило бы теневой рынок вычислительных мощностей, а китайские корпорации (Baidu, Alibaba, Tencent) расширили бы рынок сбыта своих моделей, поскольку запрет избавил бы их от необходимости конкурировать с американским продуктом.
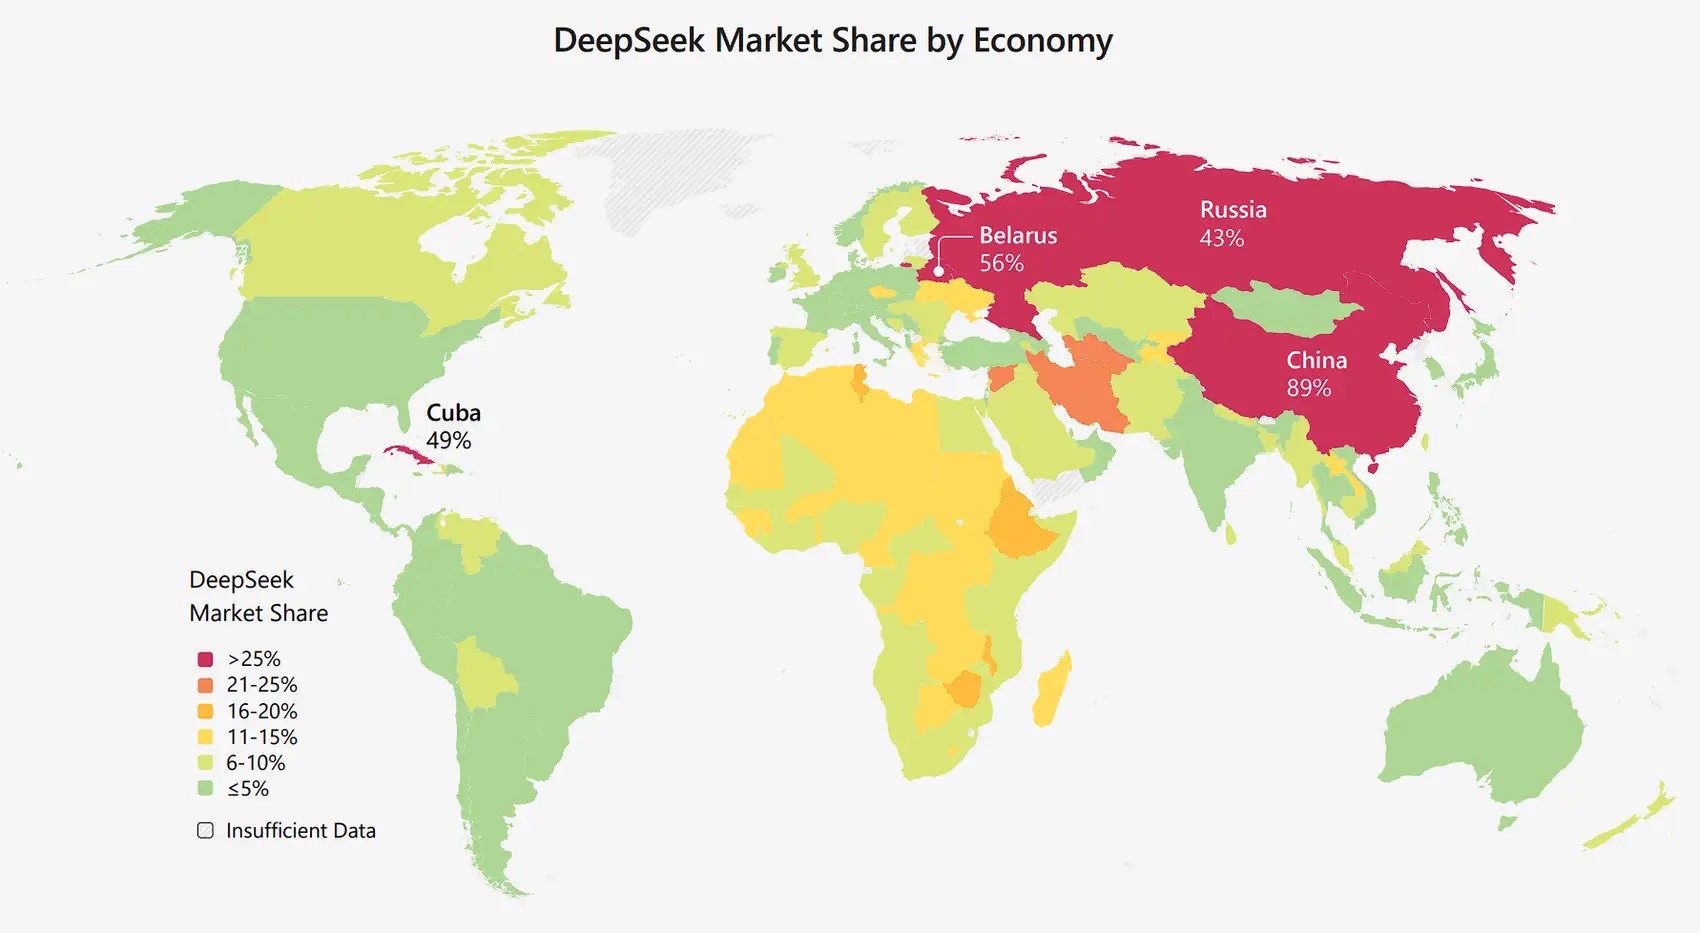
Так, согласно отчёту Microsoft, уже на начало 2026 года китайский чат-бот DeepSeek доминировал именно там, где западные сервисы либо ограничены, либо слишком дороги. Уже 30 июня 2026 года Министерство торговли США отменило экспортные ограничения после того, как Anthropic согласилась на ряд условий по безопасности. Доступ к Fable 5 был восстановлен с 1 июля по всему миру, а к Mythos 5 — для ограниченного круга доверенных американских организаций.
Рисунок 3. Распространённость китайского чат-бота DeepSeek (источник: microsoft.com)
В общем, жёсткие ограничения редко работают так, как задумано. Они перемещают риски в тень, оставляют защитников без инструментов, замедляют исследования и выталкивают разработку в юрисдикции с мягким регулированием. Практика показывает, что контроль должен быть адресным и проверяемым, а не тотальным.
Дискуссионные вопросы и открытые проблемы
Главный парадокс регулирования ИИ заключается в том, что без глобального консенсуса любые национальные ограничения остаются частичными. Российский закон № 243-ФЗ, вступивший в силу с 1 сентября 2026 года, изначально задумывался как жёсткий, однако по мере работы над ним стал более рамочным. Сейчас он касается только больших моделей (от 1 млрд параметров) и в основном посвящён поддержке отечественных разработок. Как отметил заместитель министра цифрового развития РФ Александр Шойтов, цель закона — технологическая независимость, а не тотальный контроль.
Критики считают документ «беззубым». Наталья Касперская акцентировала внимание на том, что закон не регламентирует наиболее опасные сценарии использования ИИ, не защищает права авторов произведений, на которых обучались нейросети, и оставляет вне поля зрения ИИ-агентов и ассистентов. С ней согласны и другие эксперты, указывающие, что целостные подходы к безопасности генеративного ИИ до сих пор не выработаны нигде в мире.
Параллельно решается вопрос о суверенном и национальном ИИ. Суверенной предлагается считать модель, полностью разработанную российским юрлицом и работающую исключительно на инфраструктуре в РФ, тогда как национальным моделям разрешено использовать открытые разработки.
17 июля 2026 года на пленарном заседании Совета Федерации глава «Сбербанка» Герман Греф заявил, что в России есть только одна полностью суверенная модель — GigaChat от «Сбера», а «Яндекс» якобы перешёл на дообучение китайской Qwen от Alibaba. «Яндекс» это заявление опроверг, а уже в сентябре 2026 года представил Alice AI Foundation LLM — базовую версию новой языковой модели, полностью созданной и обученной с нуля. «Яндекс» называет разработку полностью суверенной, однако официальный порядок присвоения такого статуса в России заработает только в марте 2027 года.
Подобные споры обусловлены тем, что обсуждается проект постановления, который обяжет компании и госорганы выбирать суверенные ИИ-модели в ряде сфер. Эксперты также напоминают, что стоимость токенов — лишь часть расходов, и видят риск монополизации.
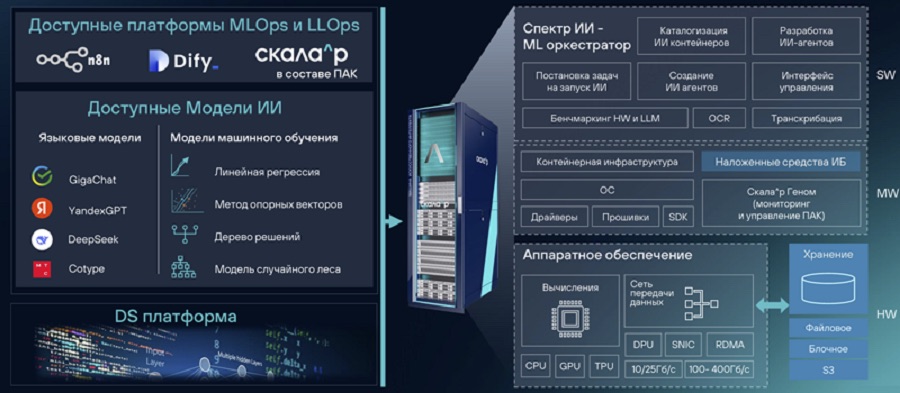
Отдельный вопрос — аппаратная независимость. Группа Rubytech протестировала российскую языковую модель Cotype 3 от MWS AI на китайских графических ускорителях в составе ПАК «Машина искусственного интеллекта Скала^р». Модель работала стабильно, а производительность в популярных сценариях инференса оказалась сопоставима с конфигурациями на NVIDIA H100. Главный вывод испытаний — корпоративную ИИ-инфраструктуру можно строить без обязательной привязки к ускорителям NVIDIA, что особенно актуально для госсектора и организаций КИИ.
Рисунок 4. ПАК «Машина искусственного интеллекта Скала^р» (источник: skala-r.ru)
Таким образом, единого мнения у экспертов нет ни по вопросу достаточности регулирования, ни по степени независимости российских моделей. Дискуссия продолжается, и окончательные ответы появятся только с выходом подзаконных актов и новых требований ФСТЭК России.
Выводы
Главный вопрос сегодня не в том, ограничивать ИИ-модели или нет, а в том, какие именно меры действительно снижают конкретные риски и дают измеримую пользу для безопасности. Часть ограничений уже доказала эффективность: контроль доступа и изоляция агентов сокращают утечки через браузерные атаки, аудит промптов и тестирование на инъекции помогают заранее выявлять слабые места. Такие меры задают понятные рамки, не тормозя исследовательский потенциал.
Сложность в том, что государственное регулирование не успевает за скоростью изменений в технологиях, и к моменту вступления норм в силу они могут потерять актуальность. Наиболее вероятный сценарий на 2027–2028 годы — ужесточение требований к фронтирным моделям при одновременном росте лоббирования со стороны индустрии в пользу сохранения доступа к открытым решениям. Также приоритетом может стать установка требований по маркировке сгенерированного контента и повышению прозрачности использования ИИ в чувствительных сферах, где ошибка может привести к серьёзным последствиям для человека или общества.
Однако уже сейчас становится очевидным, что задача регуляторов и рынка состоит не в запрете ИИ, а в выстраивании умных механизмов контроля, без неоправданных барьеров для развития технологий.


