


Wiz обнаружил конфиденциальные данные DeepSeek в открытом доступе

Wiz обнаружил конфиденциальные данные DeepSeek в открытом доступе

Wiz обнаружил конфиденциальные данные DeepSeek в открытом доступе

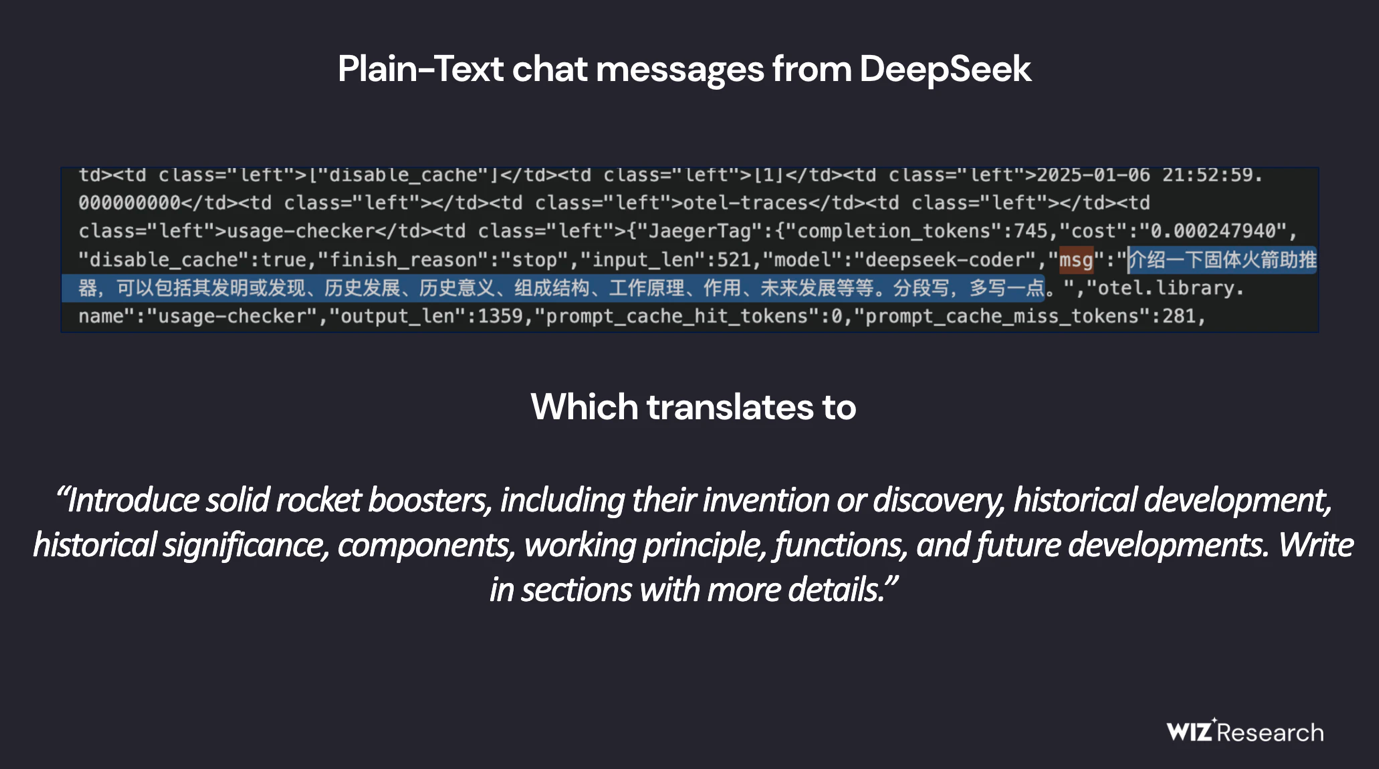
Эксперты американской компании Wiz Research обнаружили в открытом доступе массив данных ClickHouse объемом в миллион строк, содержащий конфиденциальную информацию. После уведомления исследователей компания DeepSeek оперативно устранила проблему.

Специалисты Wiz Research по собственной инициативе решили проверить уровень защищенности ИТ-инфраструктуры DeepSeek. Как отметил Гал Нагли, один из участников пентеста, проблемная база данных была обнаружена всего за несколько минут.

Содержавшиеся в ней сведения оказались конфиденциальными.

«Эта БД включала значительный объем истории чатов, внутренние данные и конфиденциальную информацию, в том числе журналы событий, секретные ключи API и эксплуатационные сведения. Причем она была полностью открыта для внешнего доступа, без каких-либо механизмов защиты», — сообщил Нагли.

Исследователи немедленно уведомили DeepSeek о выявленной уязвимости. Как отметила технический директор Wiz Research Ами Литвак в комментарии для агентства Reuters, проблему удалось устранить в течение часа.


«Эта уязвимость была слишком очевидной. Есть большая вероятность, что мы были не единственными, кто её обнаружил», — добавила Литвак.

Находка подтвердила опасения экспертов, связанные с безопасностью генеративного искусственного интеллекта, включая реализацию DeepSeek. Впрочем, авторы исследования отмечают, что стремительное развитие технологий неизбежно сопровождается рисками, среди которых — пренебрежение вопросами безопасности.

Напомним, вчера мы писали, что призывают к осторожности при использовании сервиса DeepSeek из-за возможных рисков, связанных со сбором данных для обучения нейросетей и их потенциальной передачей третьим лицам.

Подпишитесь на новости

Google поддержит единый запрет на обучение ИИ через robots.txt

Владельцам сайтов обещают упростить отказ от использования их материалов для обучения нейросетей. Google поддержит общий механизм в robots.txt: вместо отдельных инструкций каждому ИИ-провайдеру можно будет задать единую настройку для участников инициативы.

О планах компания сообщила в блоге Search Central. Поддержку механизма намерены запустить в 2027 году.

В основе лежат разработки рабочей группы AIPREF при IETF. В robots.txt появится общий маркер политики, который позволит обозначить предпочтения сайта относительно обучения ИИ.

Google планирует трактовать запрет через такой маркер аналогично запрету Google-Extended, если отдельная инструкция для него не задана. При этом существующие настройки для конкретных компаний сохранятся: можно будет установить общее правило и отдельно уточнить условия для отдельных провайдеров.

Для издателей это потенциально меньше возни с растущим списком ИИ-ботов. Но универсального технического щита здесь нет: robots.txt сообщает правила использования контента, а не перекрывает доступ к серверу. Эффект зависит от того, какие компании поддержат механизм и будут соблюдать инструкции.

Инициатива пока остаётся предложением, которое продолжат дорабатывать и стандартизировать.

RSS: Новости на портале Anti-Malware.ru