



Можно ли независимо от одного вендора свободно переезжать с одной платформы на другую? На практике миграция может занимать недели и даже месяцы. Эксперты в совместном эфире AM Live и MIND Software обсудили управление мультиплатформенной ИТ-инфраструктурой, миграцию, реальные кейсы и прогнозы.
- 1. Введение
- 2. Зависимость от вендора (вендор-лок) или портфельный подход
- 3. Миграция: сроки и сложности
- 4. Обеспечение катастрофоустойчивости и непрерывности бизнеса
- 5. Прогнозы: новая роль ИТ и FinOps
- 6. Выводы
Введение
Мультиплатформенная ИТ-инфраструктура стала реальностью крупного бизнеса: несколько облаков, несколько операционных систем, несколько платформ виртуализации. Одни компании идут к этому осознанно, другие вынуждены мигрировать в рамках импортозамещения. Но чем сложнее инфраструктура, тем острее вопросы управления, стоимости эксплуатации, совместимости и миграции.
Эксперты собрались в студии AM Live, чтобы обсудить, как эффективно управлять мультиплатформенной ИТ-инфраструктурой, как быстро и безопасно мигрировать с одной платформы на другую и какие проблемы стоят за этим.
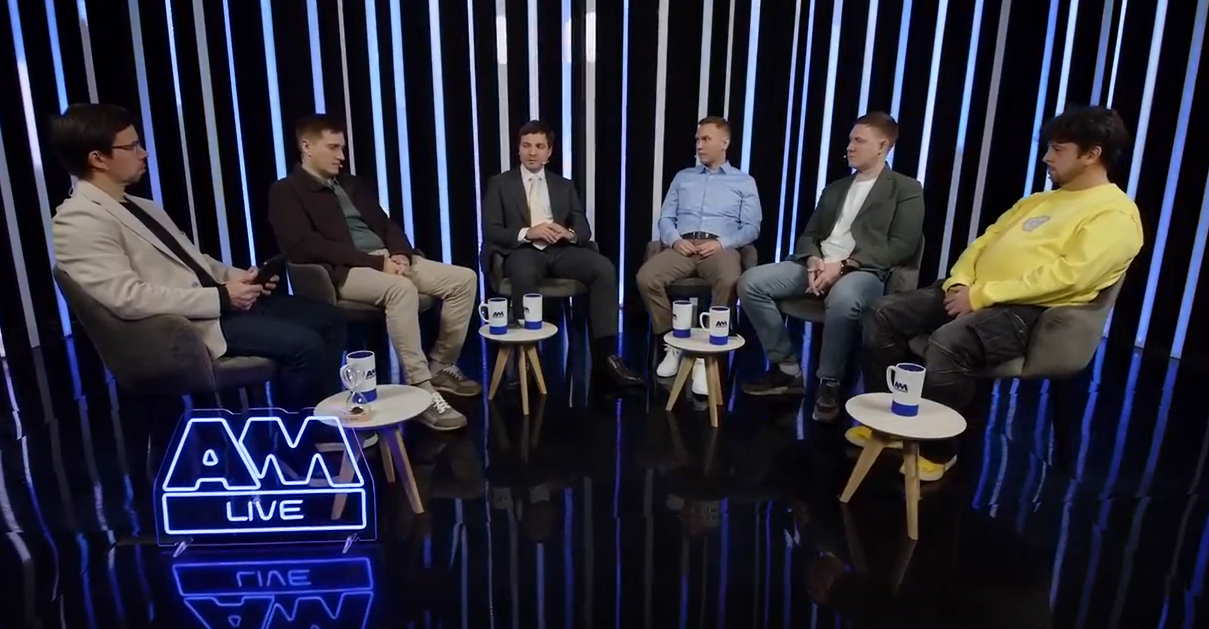
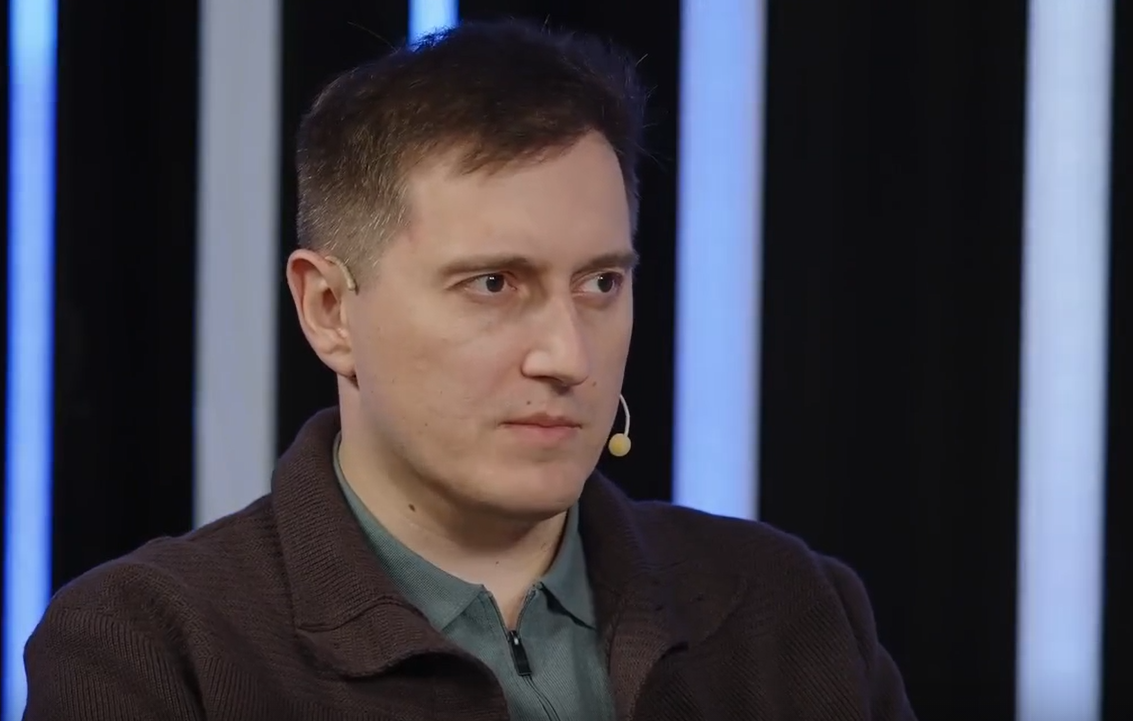
Рисунок 1. Эксперты в студии AM Live
Участники эфира:
- Михаил Соловьёв, директор по развитию закупок и трансформации, «Т-Банк».
- Антон Банчуков, директор департамента управления продуктами, MIND Software.
- Александр Локтионов, руководитель отдела системной архитектуры, «Инфосистемы Джет».
- Кирилл Носков, директор по вычислительным ИТ-платформам, «Газпромнефть ИТО».
- Дмитрий Лазаренко, директор по облачным сервисам, VK Tech.
Ведущий и модератор эфира — Илья Шабанов, генеральный директор «АМ Медиа».
Зависимость от вендора (вендор-лок) или портфельный подход
Кирилл Носков рассказал, что «Газпромнефть» пришла к гибридному подходу, основанному на портфеле технологий. Готовые рыночные решения не выполняют всех задач и требуют адаптации, поэтому компания взаимодействует более чем с пятнадцатью поставщиками.
Технологии нужно интегрировать, а внедрение влечёт за собой эксплуатацию и обучение команд, что является культурной трансформацией и дорого для бизнеса. Поэтому на первый план выходит управление: принципы менеджмента, риски и скорость. Компания пришла к архитектурным решениям, которые обеспечивают более одного способа решения задачи с выбором по надёжности и эксплуатационной гибкости, это выстраивание единой команды наблюдаемости и портфеля технологий.
«Портфельный подход — осознанный выбор. Задачи у компании разнопрофильные, а цепочка бизнеса сложная: от добычи до переработки и сбыта. Масштаб задач сильно различается на месторождениях, крупных заводах и ретейловых заправочных комплексах, поэтому инфраструктура должна подбираться под задачу. Без портфеля не обойтись, а объединяют всё собственные разработки, выступающие интеграционным слоем», — объяснил Кирилл.
Антон Банчуков добавил, что портфельный подход — это то, с чем сталкивается практически весь крупный бизнес, и в этом нет ничего удивительного. Компании другого масштаба также попадают на поле мультиплатформенности, причём не только в какой-то один момент, но и итерационно, исторически.
Бизнес вырос на импортозамещении, когда переходили с западных платформ на российские: даже если компания ставит перед собой задачу иметь одну платформу, она не всегда может это себе позволить. В какой-то момент она всё равно живёт параллельно в двух мирах и сталкивается с теми же задачами управления рисками, ресурсами и сроками.
Антон Банчуков, директор департамента управления продуктами, MIND Software
Дмитрий Лазаренко отметил, что у заказчиков картина неоднородна: везде есть унаследованная инфраструктура, многие балансируют между нею и решениями класса «специально для облака» (cloud native) на базе Kubernetes. VK Tech тоже проходит эту трансформацию, потому что cloud native даёт больше гибкости и наблюдаемости.
Михаил Соловьёв объяснил позицию «Т-Банка»: компания строит собственную моноплатформу поверх серверов без виртуализации (bare metal) всех крупных российских облачных провайдеров. Опора на открытый код, сокращение количества технологий и полное владение ими — основа для технологической компании.
«Если ты построен на чужих лицензированных технологиях, непонятно, почему бизнес устойчив: в 2022 году такие компании повисли в воздухе. Опора на Open Source, сокращение количества технологий, которые ты используешь, и полное владение этими технологиями — это основа для технологической компании».
Александр Локтионов добавил, что компании, выросшие до уровня бигтеха, обращаются к интеграторам реже. Остальные закупают рыночные продукты и всё больше приходят с запросом навести порядок в «зоопарке». Драйвер — экономика: спрос на утилизацию ресурсов, поиск простаивающих мощностей и снижение стоимости владения (TCO).
Александр Локтионов, руководитель отдела системной архитектуры, «Инфосистемы Джет»
Опасен ли вендор-лок?
Дмитрий Лазаренко назвал ключевой вопрос: кто решит проблему, когда она возникнет? Опенсорс-проекты содержат сотни тысяч строк кода, написанных годы назад, и при P0-инциденте (блокировка всей работы компании) промышленная компания вряд ли будет иметь нужную экспертизу. Вендор даёт гарантии — спасательный круг на случай катастрофы.
Кирилл Носков добавил, что для «Газпромнефти» важно понимать свои границы. Компания осознанно сохраняет небольшой штат инфраструктурных разработчиков. Ключевые принципы облака — переносимость (быстро дать бизнесу альтернативу), воспроизводимость и наблюдаемость. В процессе аудита выяснилось, что не всё подряд нужно мигрировать: есть потерянная инфраструктура — сотни виртуальных машин, которые кто-то когда-то развернул и потом утратил над ними контроль.
Кирилл Носков, директор по вычислительным ИТ-платформам, «Газпромнефть ИТО»
Михаил Соловьёв привёл историю из практики, когда он руководил облаком DataLine, занимавшим около четверти российского рынка облаков. Компания Intel перешла с сетевых карт Intel 610 / 620 на Intel 810, и работоспособность сети в облаке, а также активов заказчиков, размещённых в нём, зависела от драйверов Intel.
Между VMware, выпустившей платформу, на которой работали все провайдеры, и драйверами Intel возникла коллизия, и обе компании заявляли, что проблема на другой стороне. Все провайдеры VMware в мире завалили вендоров письмами, потому что не могли повлиять на ситуацию: они зависели от двух компаний, которые перекладывали ответственность друг на друга, а страдали при этом их клиенты.
Ситуация завершилась только в 2025 году, когда Broadcom признал ошибку и выпустил корректные драйверы, и сети заработали. Но затем Lenovo заявила, что ей неинтересно забирать патчи Broadcom и реализовывать прошивки для своих сетевых карт. В результате серверы Lenovo на этих картах до сих пор не работают с VMware и не могут использоваться.
Провайдеры понесли огромные потери, потому что им пришлось заменить все сетевые карты в большом объёме оборудования. Эта история — иллюстрация того, на что реально можно рассчитывать при вендор-локе: формально вендор даёт поддержку, но когда возникает коллизия между двумя крупными поставщиками, клиент остаётся заложником их разбирательств.
В первом опросе зрители назвали проблемы, которые создаёт мультивендорная и мультиплатформенная инфраструктура (мультивыбор):
- Высокая стоимость эксплуатации — 76 %.
- Нехватка специалистов и компетенций — 72 %.
- Проблемы совместимости и интеграции решений — 68 %.
- Сложность выполнения требований по безопасности и отказоустойчивости — 54 %.
- Зависимость от отдельных вендоров и платформ — 27 %.
- Сложность изменений и обновлений инфраструктуры — 24 %.
Тех, кто не видел бы серьёзных проблем, не нашлось.
Рисунок 2. Какие проблемы создаёт мультивендорная и мультиплатформенная инфраструктура?
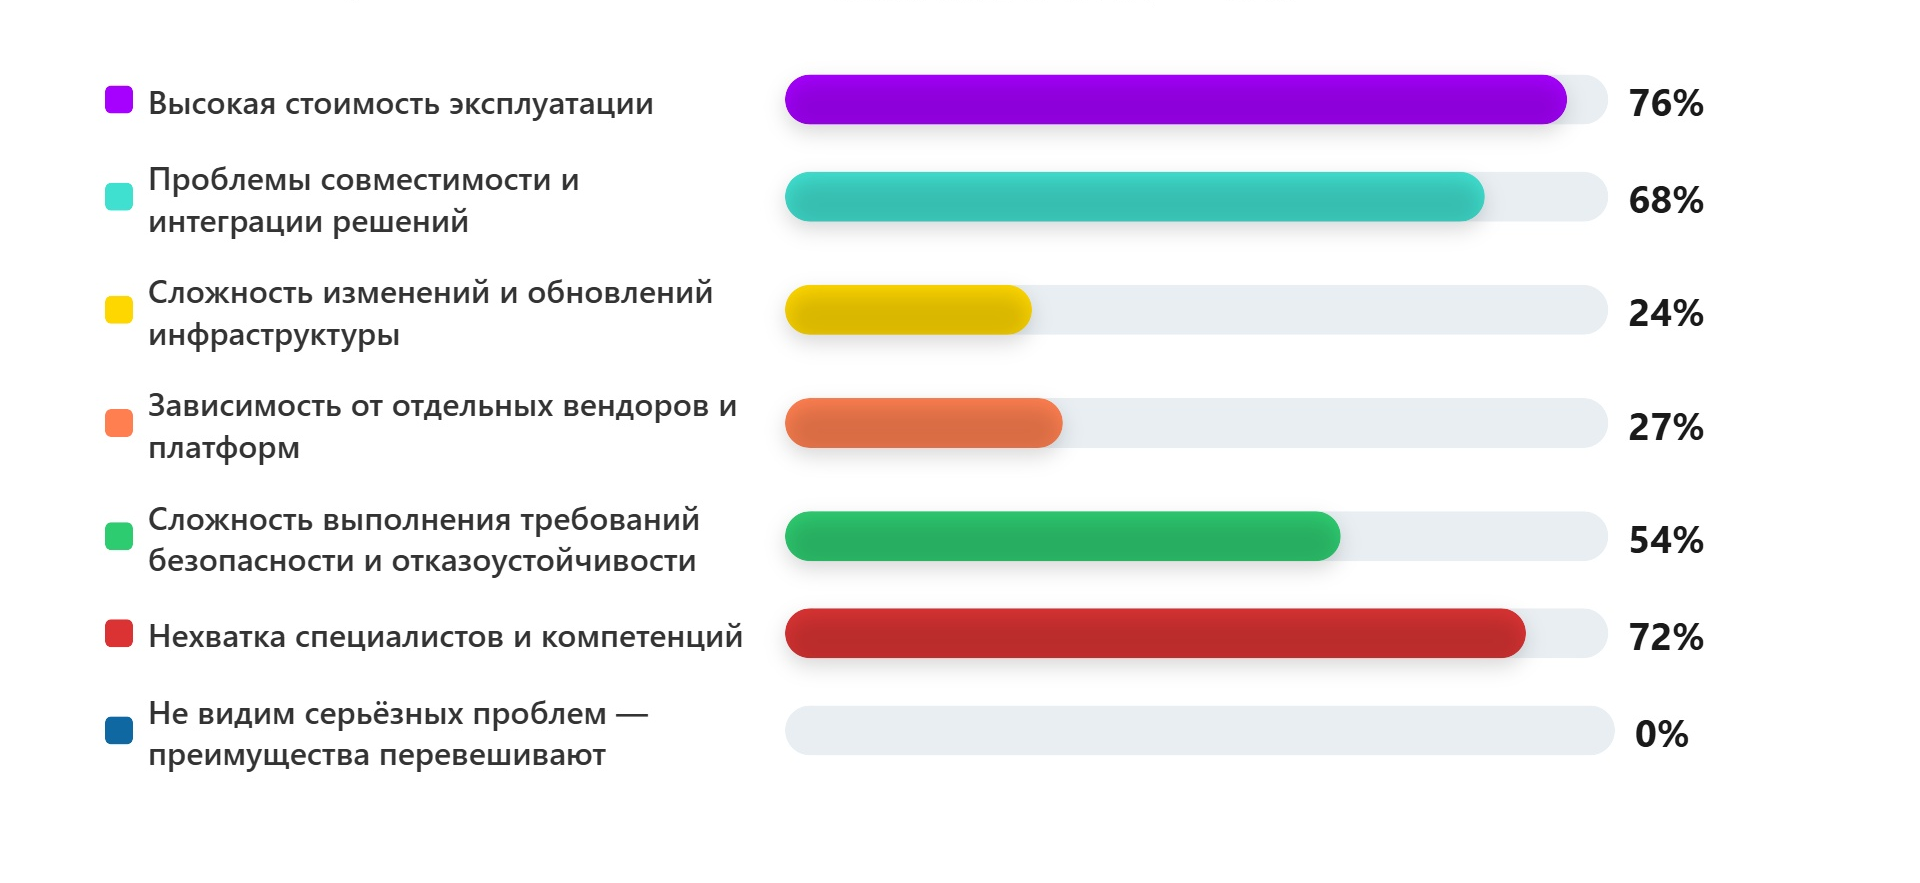
Проблемы мультиплатформенности
Антон Банчуков отметил, что мультиплатформенность — это не просто одно окно управления, а возможность проводить сквозные операции. Стандарт обслуживания, действия при аварии, ввод в эксплуатацию, запланированный простой — всё это должно быть унифицировано для всех платформ, с которыми компания сталкивается: западных унаследованных, собственных разработок, сервисов провайдера. MIND Software смотрит в сторону того, чтобы при планировании регламентов и действий компании получали единый уровень операций и компетенций для всех платформ.
Он также отметил, что 2022–2023 год был годом презентаций: заявлялись отдельные функции — репликация, защита платформы, резервное копирование, — но за каждой из них стоит целый пласт работы, и реализованы они могли быть по-разному. Сейчас зрелость решений повышается. При этом 80 % работы компании — не разработка технологии переезда, а обеспечение её одинаково корректной работы на какой угодно платформе.
Компания давно ждёт консолидации, но пока существенного изменения по количеству игроков на рынке не видно: фрагментация значительная, есть производители платформ виртуализации с одним-двумя-тремя заказчиками, которые чувствуют себя комфортно, и приходится работать со всеми.
Илья Шабанов высказал свою позицию: для него это неудобно прежде всего с точки зрения управления. Он отметил, что при мультиплатформенной инфраструктуре всё равно возникают большие затраты на поддержку этого «зоопарка» и нужен какой-то софт управления, который будет решать эту проблему. Пугает разрозненность, когда в инфраструктуре много всего разного, и хочется это упорядочить, чтобы всё было одинаково.
Илья Шабанов, генеральный директор «АМ Медиа»
Дмитрий Лазаренко добавил, что общий знаменатель между Kubernetes и любой виртуализацией крайне мал, а у каждого вендора разный набор фич. Концепция единой панели управления на практике скатывается до уровня «инфраструктура как сервис» или «bare metal как сервис», потому что это ядро общей функциональности у всех облачных платформ.
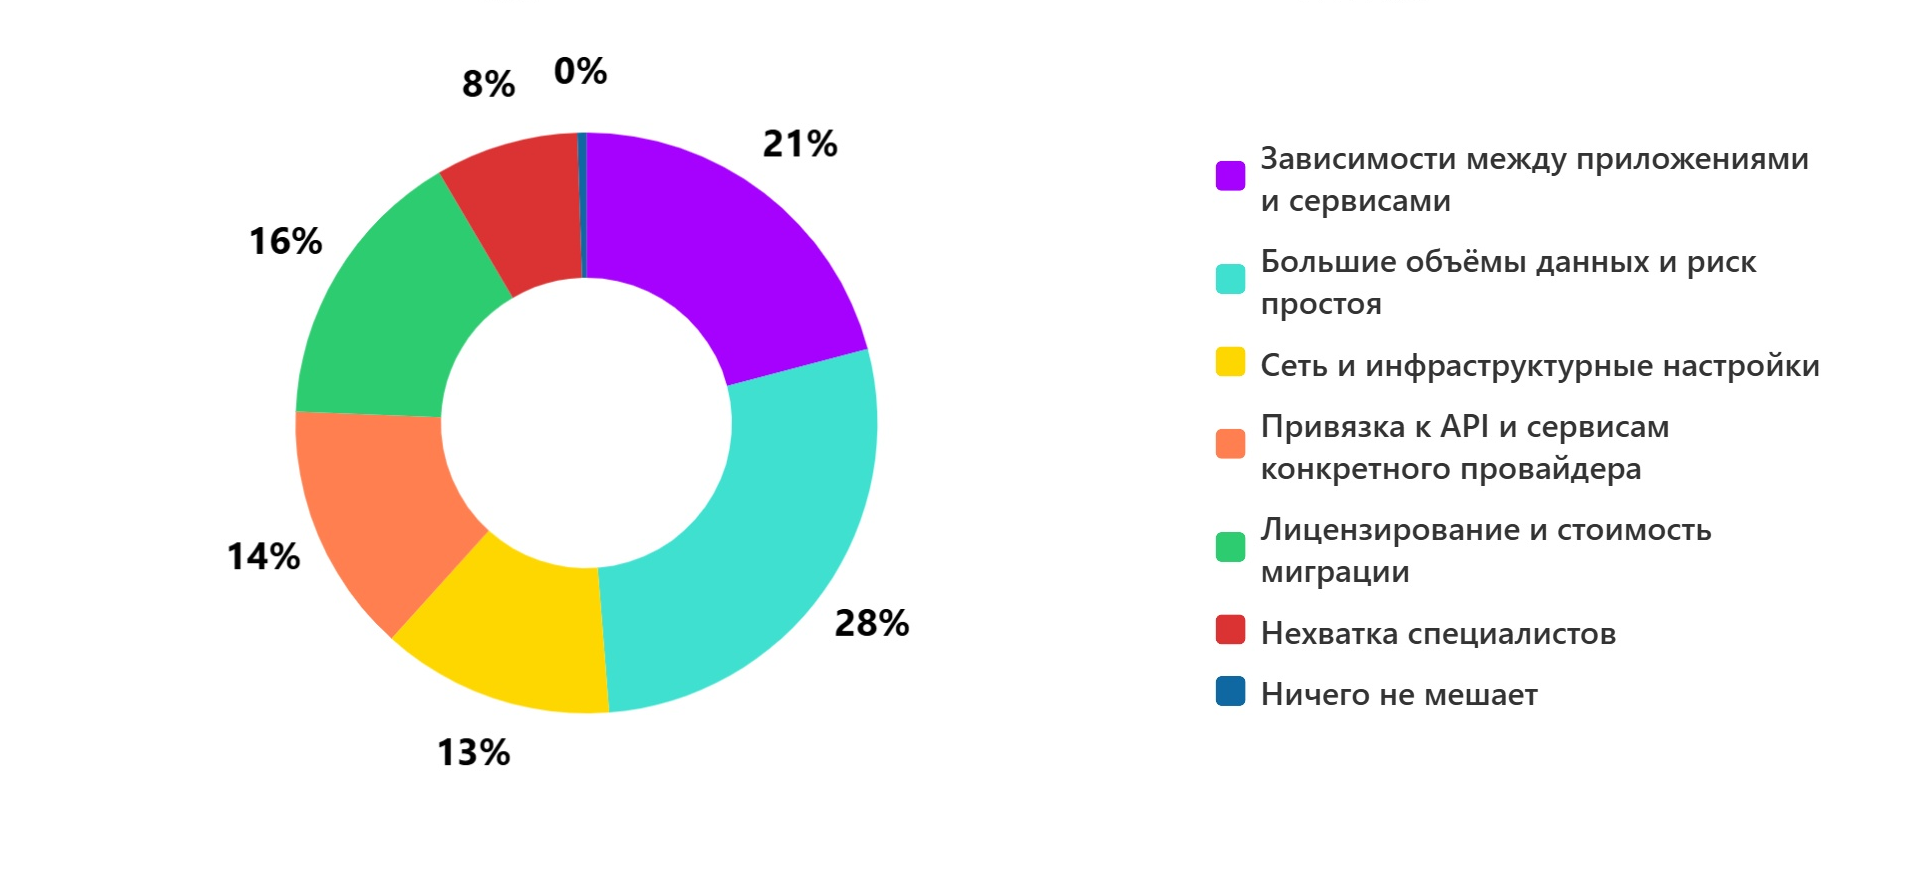
Во втором опросе выяснилось, что сильнее всего мешает свободно переносить нагрузки между платформами:
- Большие объёмы данных и риск простоя — 28 %.
- Зависимости между приложениями и сервисами — 21 %.
- Лицензирование и стоимость миграции — 16 %.
- Привязка к API и сервисам конкретного провайдера — 14 %.
- Сеть и инфраструктурные настройки — 13 %.
- Нехватка специалистов — 8 %.
Вариант ответа «Ничего не мешает» не выбрал никто.
Рисунок 3. Что сильнее всего мешает свободно переносить нагрузки между платформами?
Миграция: сроки и сложности
Антон Банчуков отметил, что планирование и дизайн не позволяют выявить все сложности инфраструктуры. Владельцы систем могут быть уверены, что знают, как всё устроено, но аудит не всегда вскрывает проблемы. Всё, что не учтено, проявляется непосредственно в процессе переноса: во время миграции обнаруживаются другие ОС, системы оказываются устаревшими, данные не обновлялись. От четверти до трети миграций не проходят с первого раза — по разным причинам: порты не подали, сеть не настроена, операционная система не запустилась.
Дмитрий Лазаренко рассказал, что VK Tech сделал инструмент, который собирает весь граф зависимостей — сетевых, портов и так далее, что значительно облегчает проекты миграции. Второй момент — автоматизация: часто в исходной инфраструктуре всё создавалось руками, информация держалась только в облачной платформе или в голове одного инженера. Открытые стандарты Terraform позволяют реализовать концепцию «инфраструктура как код», а кодинг-агенты позволяют автоматизировать перенос и обрабатывать ошибки быстрее, чем люди.
Михаил Соловьёв рассказал, как устроена платформа «Т-Банка», чтобы миграция не понадобилась: в компании нет L2-сети, разработчик кладёт код и YAML-файл с уровнем критической значимости в Git, приложение само деплоится Kubernetes в нескольких регионах без участия администратора. В случае аварийного восстановления Kubernetes берёт приложение из Git и деплоит в новую зону, а данные находятся в базе или S3.
Унаследованные приложения приходится мигрировать руками. Эксперт привёл пример миграции Lotus Domino с данными, которые нужно хранить 50 лет: пришлось найти последних специалистов, ушедших на пенсию, чтобы они объяснили программистам, как разобрать систему.
Михаил Соловьёв, директор по развитию закупок и трансформации, «Т-Банк»
Александр Локтионов поддержал коллег: можно стремиться к миру, в котором всё деплоится и ничего не нужно сохранять, но практически у каждого заказчика есть 1С с базой объёмом в десятки гигабайт или терабайт, а также базы DB2, которые являются жёсткой зависимостью современного Kubernetes-стека. Систему можно выстроить и разместить в нескольких зонах доступности, однако эту зависимость сдвинуть с места не получится.
Кирилл Носков добавил, что российская контейнеризация с 2021 года в проде — это всего 27 % всей вычислительной нагрузки. Проблема с виртуализацией и bare metal остаётся, и главные сложности — большие объёмы данных, зависимости приложений и сеть, включая перенос политик микросегментации между разными SDN.
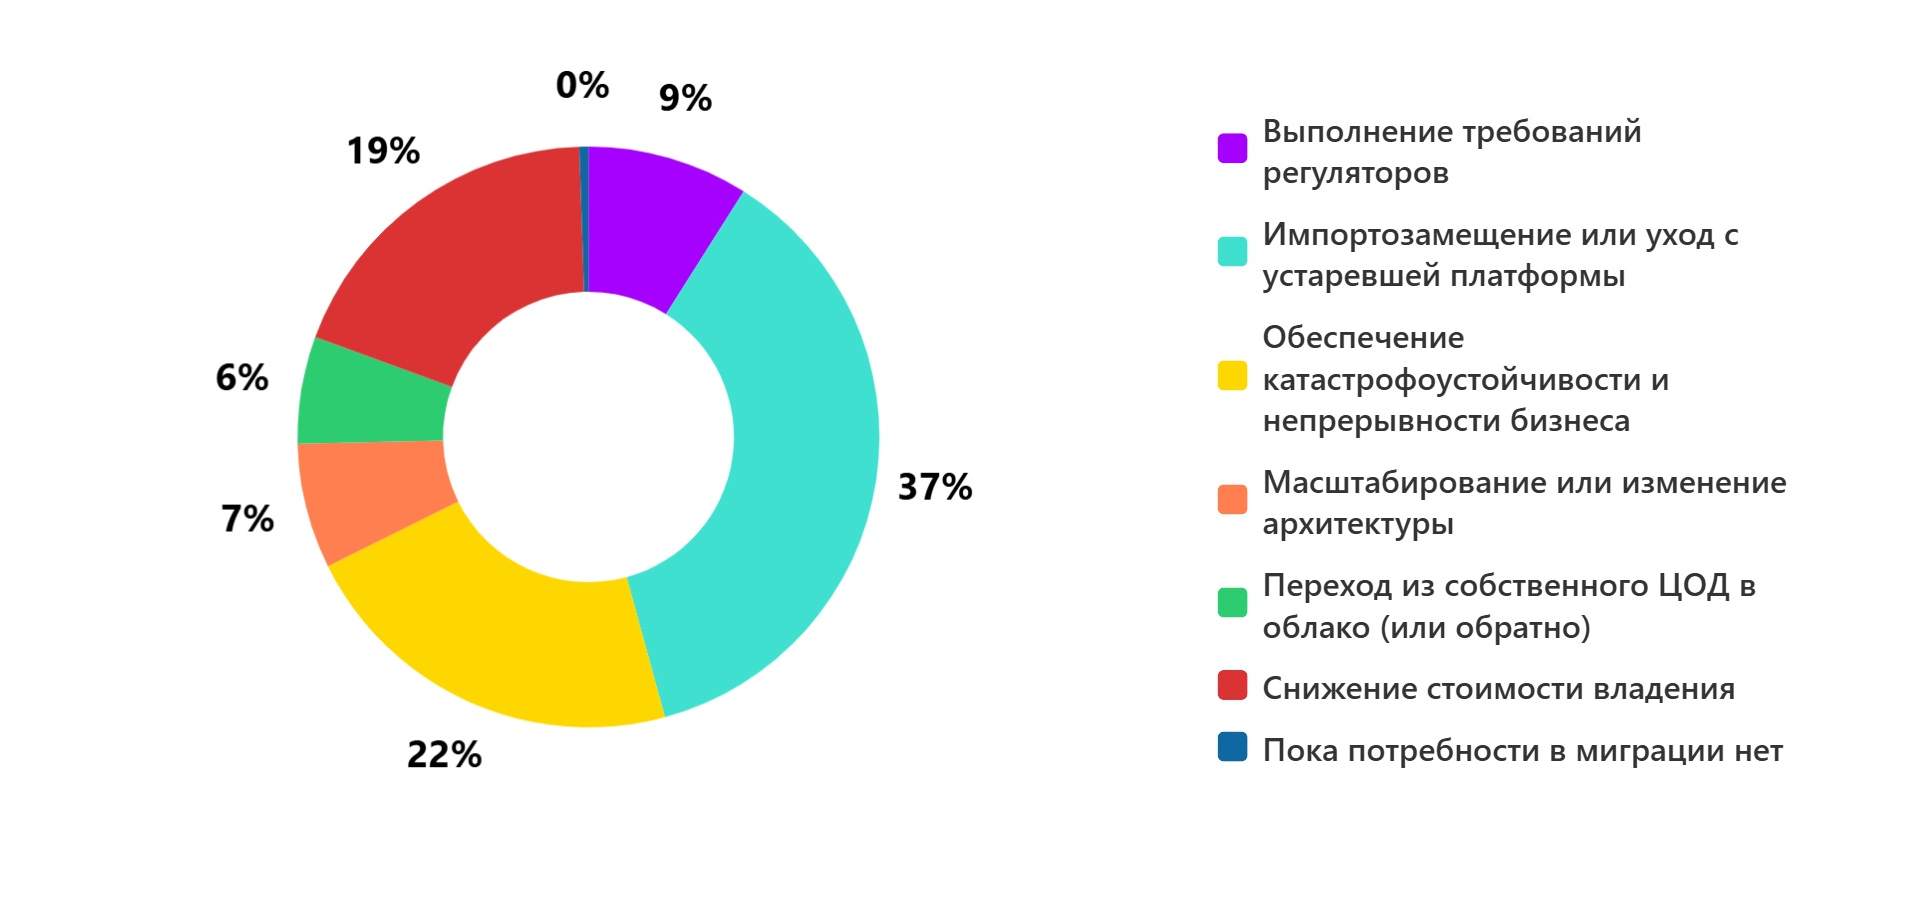
В третьем опросе зрители поделились, что сегодня является главной причиной миграции ИТ-инфраструктуры в их компании:
- Импортозамещение или уход с устаревшей платформы — 37 %.
- Обеспечение катастрофоустойчивости и непрерывности бизнеса — 22 %.
- Снижение стоимости владения — 19 %.
- Выполнение требований регуляторов — 9 %.
- Масштабирование или изменение архитектуры — 7 %.
- Переход из собственного ЦОД в облако (или обратно) — 6 %.
Среди респондентов не оказалось тех, кто пока не нуждался бы в миграции.
Рисунок 4. Что является главной причиной миграции ИТ-инфраструктуры в вашей компании?
Обеспечение катастрофоустойчивости и непрерывности бизнеса
Дмитрий Лазаренко отметил, что бизнес нужно убедить инвестировать в катастрофоустойчивость, и на этом лучше не экономить. Есть порочный треугольник: невозможно одновременно сократить затраты, сделать систему катастрофоустойчивой и проапгрейдиться по «железу».
VK Tech сделал задачи по восстановлению (Disaster Recovery) более приоритетными, чем продуктовые и бизнес-задачи, чтобы достичь результата за короткий срок. Теоретические выкладки никак не помогают, когда наступает критическая ситуация. Про страховку лучше подумать заранее, полноценно.
Дмитрий сравнил эту историю с работой хирургов: в медицине процессы отточены и оттачиваются каждый день, а в российском бизнесе их откладывают до последнего. Вероятность событий меняется: два года назад риск был во временной недоступности ЦОДов, сейчас — в постоянной потере одного или двух ЦОДов.
Дмитрий Лазаренко, директор по облачным сервисам, VK Tech
Михаил Соловьёв призвал провести разговор с собственником бизнеса о том, как бизнес будет работать без ИТ-инфраструктуры. План устойчивости (Business Continuity Plan) должен определять рисковые сценарии, которые рано или поздно могут сработать. Он привёл пример пивоваренной компании, у которой в облаке были виртуальные машины, управляющие заводом. Во время локальной катастрофы она переключила систему управления с одного облака на другое и продолжила работу — благодаря тестировавшемуся DR-плану.
Обратный пример — компания, сдававшая в Москве автомобили в прокат. У неё не было BCP-сценария, а облако, на котором она работала, упало на несколько часов. Все клиенты приехали к офису на арендованных машинах и начали сигналить, потому что компания не выходила на связь. Сдать машину было невозможно — такой кнопки не было. Это крайний случай отсутствия Business Continuity Plan: клиенты не смогли завершить взаимодействие с сервисом, а компания не продумала этот сценарий.
Кирилл Носков сравнил BCP с практикой выживальщика: рюкзак нужно собирать заранее, потому что потом будет поздно. Он также рассказал о возвращении ленточных библиотек как надёжного и дешёвого способа хранения и о том, что локальное резервирование виртуальных машин возвращается в решения вендоров.
Прогнозы: новая роль ИТ и FinOps
Михаил Соловьёв:
«Управление эффективностью и стоимостью мультиоблака — важный вопрос, мы решаем его несколько лет. Следующий шаг — тонкий FinOps в отношении сервисов и их распределения по мультиоблаку, особенно в части использования GPU. Уйдут ли компании от ручного принятия решений? Решение принимают человек и правила, и непонятно, зачем здесь нужен ИИ. Разработчик задаёт уровень критической значимости приложения, а Kubernetes по правилам поддерживает нужное количество копий. Это встроенный механизм, Kubernetes умеет это из коробки».
Антон Банчуков:
«С одной стороны, ухудшаются параметры бизнеса — инфраструктура дорогая, бюджеты ограничены. С другой стороны, вызовы становятся серьёзнее: киберугрозы, отказоустойчивость, доступность. Это потребует внимательнее смотреть на платформы, выжимать из них максимум и комбинировать.
Количество изменений будет расти: это не выбор навсегда — сегодня одна платформа, завтра она не подходит, нужен другой режим, что-то поменялось в регуляторике, опять меняем. Команды научатся быстрее реагировать, менее болезненно, и это станет не проектом, который долго придумывают, а рутинной операцией, в том числе благодаря ИИ-агентам, которые могут проводить аналитику».
Александр Локтионов:
«Агенты сейчас — завышенный хайп, но с их применением можно много чего сделать. Надеюсь, что люди в компаниях, в том числе инженеры, попробуют новый стиль работы, поймут, что многое можно описать кодом, начнут делать качественные автоматизации и автоматизировать свою инфраструктуру. Добившись уверенных результатов, люди перестанут бояться отвала ЦОДа — это должна быть штатная операция, в которой все знают, что делать, а не чрезвычайная ситуация».
Кирилл Носков:
«Роль ИТ меняется с поддерживающей функции на партнёра бизнеса. Имея мониторинг, дающий оптимизацию ресурсов (rightsizing), возможность самообслуживания, когда руки инженера не лезут в инфраструктуру, и средства обновления, а лучше — практику периодического пересоздания, компания может пересобрать инфраструктуру за те же деньги, что-то отрезать и заархивировать. Это новая роль solution-архитектора».
Дмитрий Лазаренко:
«В контексте Kubernetes агенты практически не востребованы. Однако при отказе самого Kubernetes или компонентов, на которых держится фундамент, агенты активно применяются для поиска и устранения проблем и для восстановления, что позволяет повысить доступность и быстрее устранять аварии.
Важен хаос-инжиниринг: мало компаний его используют в России, а за рубежом это делают все. Агенты и динамические среды позволят больше вкладываться в него и получать более надёжные системы».
Илья Шабанов:
«Технологическая диверсификация — это устойчивый тренд не только в России, но и во всём мире. Важно понимать, что мы здесь идём в ногу со всем миром. Gartner прогнозирует, что к 2029 году больше половины организаций не получат ожидаемого результата от своей мультиплатформенности и мультиоблачности. Главная проблема — интероперабельность, её отсутствие и связанность между теми самыми средами и платформами».
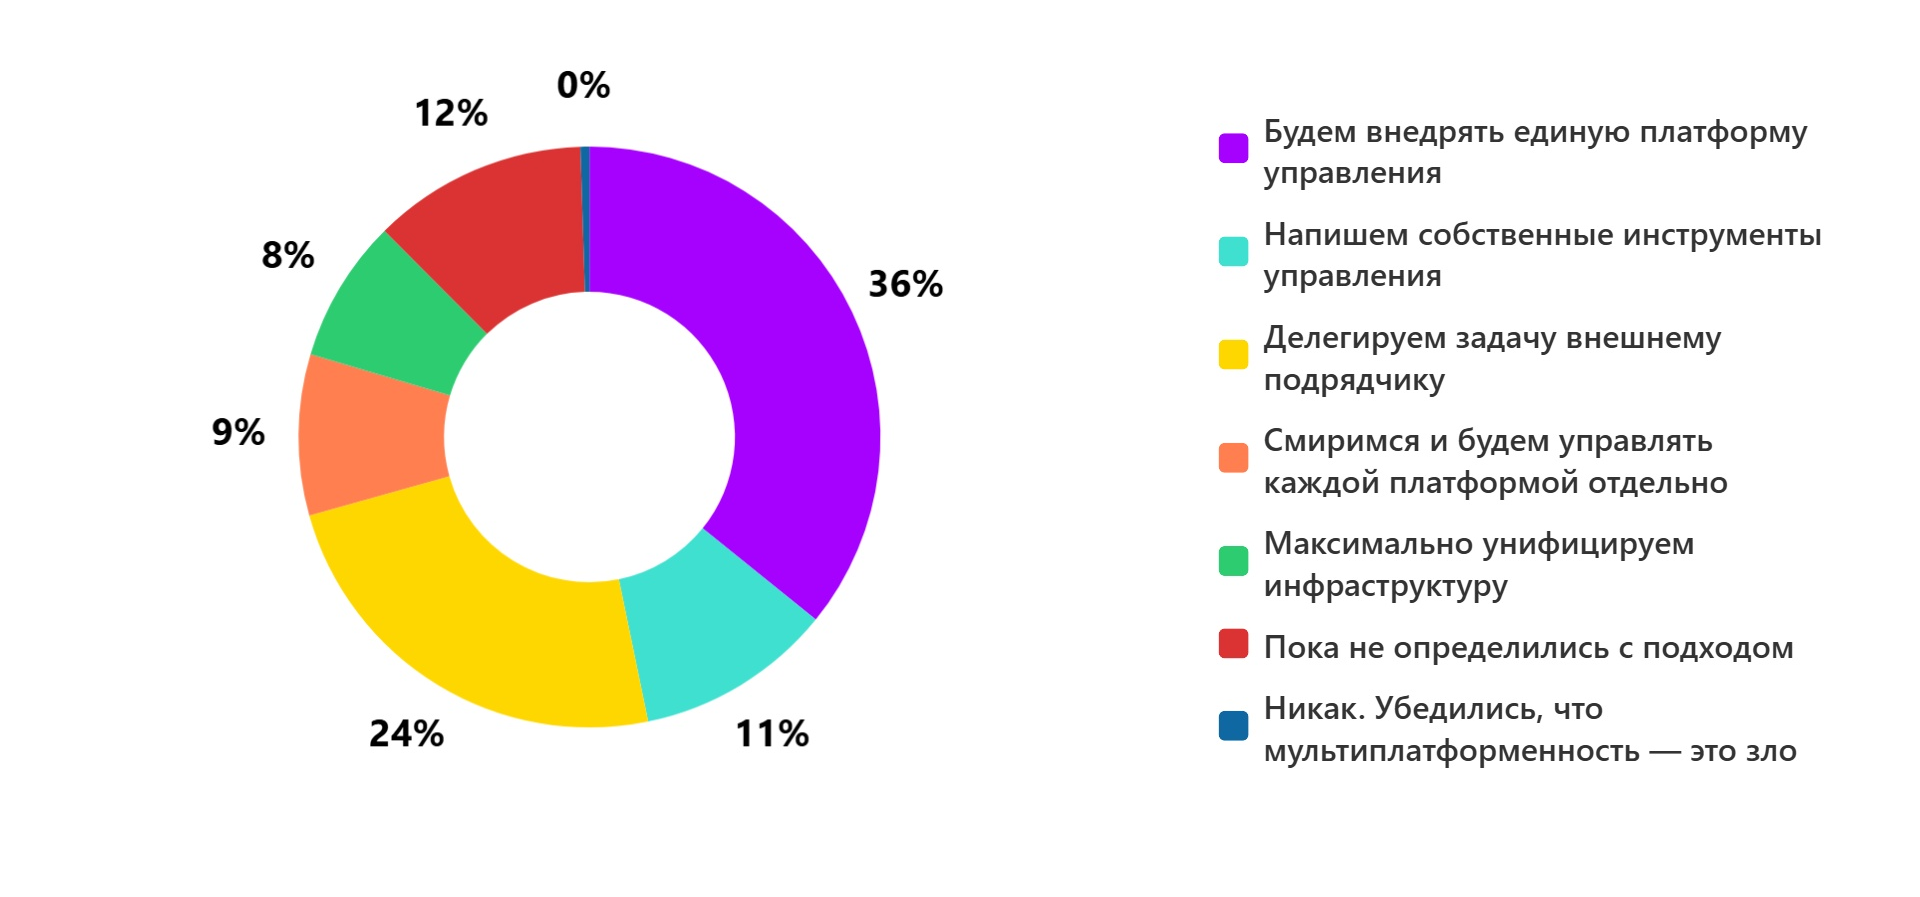
Финальный опрос показал, как зрители планируют управлять мультиплатформенной ИТ-инфраструктурой:
- Будут внедрять единую платформу управления — 36 %.
- Делегируют задачу внешнему подрядчику — 24 %.
- Пока не определились с подходом — 12 %.
- Напишут собственные инструменты управления — 11 %.
- Смирятся и будут управлять каждой платформой отдельно — 9 %.
- Максимально унифицируют инфраструктуру — 8 %.
Против мультиплатформенности как таковой никто не выступил.
Рисунок 5. Как вы планируете управлять мультиплатформенной ИТ-инфраструктурой?
Выводы
Мультиплатформенная ИТ-инфраструктура стала реальностью крупного бизнеса, и рынок движется к ещё большей гетерогенности. Главные проблемы — высокая стоимость эксплуатации и нехватка специалистов, а не зависимость от отдельных вендоров, как можно было ожидать. Компании готовы решать проблему совместимости, но экономика и кадры выходят на первый план.
Ключевой выбор — между вендор-локом и портфельным подходом. Одни компании строят собственную моноплатформу поверх bare metal всех провайдеров, опираясь на открытый код и полное владение технологиями. Другие осознанно выбирают портфель технологий и собственные разработки как интеграционный слой. Третьи покупают рыночные продукты и приходят к интегратору навести порядок. Универсального ответа нет: он зависит от масштаба, зрелости и риск-профиля компании.
Проблема вендор-лока острее, чем кажется: даже крупные компании не гарантируют поддержку, и рынок ждёт консолидация. Когда облако работает на чужом опенсорсе, важно иметь штат разработчиков, способных пересобрать его и диагностировать, а также систему наблюдаемости.
Миграция — это непрерывный процесс, и её сроки недооценивают. От четверти до трети миграций не проходят с первого раза, а главные сложности — большие объёмы данных, зависимости приложений и сетевые нюансы. Обратная миграция из облака экономически неоправданна из-за роста стоимости «железа». Правильный подход — не мигрировать всё после сбоя, а продумать DR-сценарий и распределить по трём-четырём поставщикам.
Обеспечение катастрофоустойчивости требует разговора с бизнесом о том, как он будет работать без ИТ. Компании, которые тестировали BCP и DR-планы, продолжают работать, когда инфраструктура «отваливается». Важно не откладывать это до последнего.
Будущее управления инфраструктурой — за автоматизацией, FinOps и новой ролью ИТ. ИИ-агенты полезны для поиска и устранения проблем, но в Kubernetes многие задачи решаются правилами. Главное — не плодить хаос, делать инфраструктуру управляемой и периодически пересоздавать её.
Телепроект AM Live еженедельно приглашает экспертов отрасли в студию, чтобы обсудить актуальные темы российского рынка ИБ и ИТ. Будьте в курсе трендов и важных событий. Для этого подпишитесь на наш YouTube-канал.
До новых встреч!


