


Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Группа исследователей из Университета Техаса и Университета Пердью предложила необычную идею: большие языковые модели (LLM), вроде ChatGPT, могут «тупить» от некачественных данных примерно так же, как люди — от бесконечных часов в соцсетях.

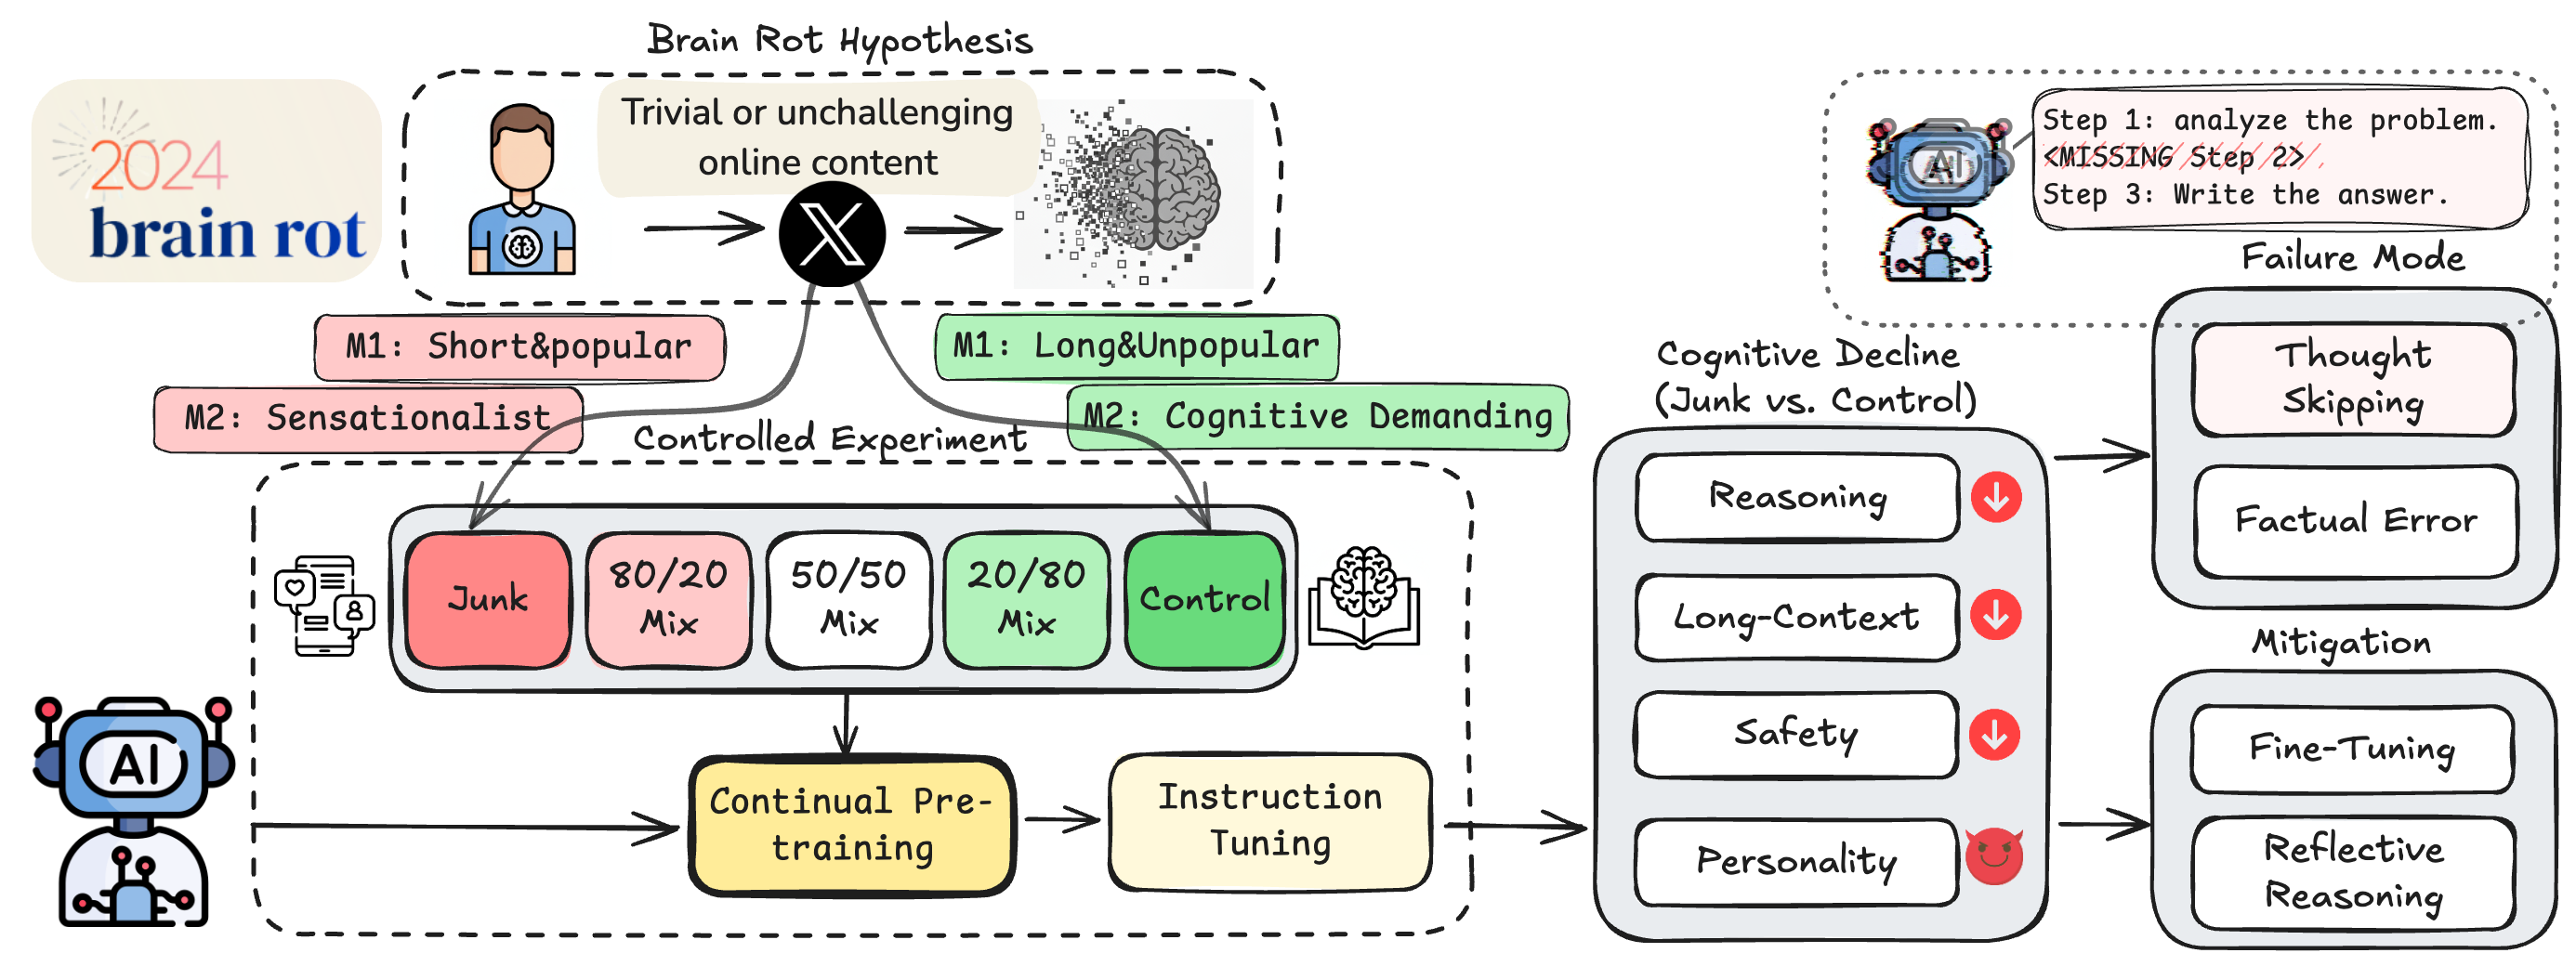
В отчёте специалисты выдвигают «гипотезу гниения мозга LLM». Суть проста: если продолжать дообучать языковую модель на «мусорных» текстах из интернета, она со временем начнёт деградировать — хуже запоминать, терять логику и способность к рассуждению.

Авторы понимают, что отличить хороший контент от плохого сложно. Поэтому они решили изучить 100 миллионов твитов с HuggingFace и отобрать те, что подходят под определение «junk».

В первую группу попали короткие твиты с большим количеством лайков и репостов — те самые, которые вызывают максимальное вовлечение, но несут минимум смысла. Во вторую — посты с «низкой семантической ценностью»: поверхностные темы, кликбейт, громкие заявления, конспирология и прочие «триггерные» темы.


Чтобы проверить качество отбора, результаты GPT-4o сверили с оценками трёх аспирантов — совпадение составило 76%.

Учёные обучили четыре разные языковые модели, комбинируя «мусорные» и «качественные» данные в разных пропорциях. Потом прогнали их через тесты:

  • ARC — на логическое рассуждение,
  • RULER — на память и работу с длинным контекстом,
  • HH-RLHF и AdvBench — на этические нормы,
  • TRAIT — на анализ «личностного стиля».

Результаты оказались любопытными: чем больше в обучающем наборе было «интернет-мусора», тем хуже модель справлялась с задачами на рассуждение и память. Однако влияние на «этичность» и «черты личности» было неоднозначным: например, модель Llama-8B с 50% «мусора» даже показала лучшие результаты по «открытости» и «низкой тревожности».

Исследователи сделали вывод: переизбыток интернет-контента может привести к деградации моделей и призвали разработчиков тщательнее отбирать данные для обучения. Особенно сейчас, когда всё больше онлайн-текста создаётся уже самими ИИ — и это может ускорить эффект так называемого model collapse, когда модели начинают обучаться на собственных ошибках.

Учёные шутят: если так пойдёт и дальше, возможно, придётся вернуться к книгам — хотя бы ради того, чтобы «накормить» модели чем-то действительно качественным.

Подпишитесь на новости

Yandex B2B Tech объединила полнотекстовый и векторный поиск в одном запросе

Найти точный номер документа и одновременно разобраться, что пользователь имел в виду, — теперь обе задачи можно решать в YDB. Yandex B2B Tech добавила в базу данных гибридный поиск, объединяющий полнотекстовый и векторный подходы.

Как объясняют разработчики в блоге YDB, два вида поиска дополняют друг друга.

Например, в запросе о выплате по страховке номер полиса нужно найти точно, а описание страхового случая — сопоставить по смыслу, даже если в документах использованы другие формулировки.

Полнотекстовый поиск отвечает за слова, названия и коды, векторный — за смысловую близость. YDB объединяет результаты и ранжирует их внутри одного SQL-запроса.

Практический бонус для компаний: данные остаются в одной базе. Для такого сценария не нужно отдельно поддерживать поисковый движок и векторную базу, а затем следить, чтобы информация между ними не разъехалась. Индексы обновляются вместе с данными в рамках одной транзакции.

Технология рассчитана на чат-ботов, рекомендательные сервисы и ИИ-ассистентов, которым мало простого совпадения слов. Особенно когда приходится искать по технической информации, где точный код детали и человеческое описание проблемы одинаково важны.

Гибридный поиск доступен в корпоративной версии YDB 26.3 для развёртывания на собственной инфраструктуре и в облачном Managed Service for YDB.

RSS: Новости на портале Anti-Malware.ru