


Атаки вредоносов через фейковые CAPTCHA стали трендом

Атаки вредоносов через фейковые CAPTCHA стали трендом

Атаки вредоносов через фейковые CAPTCHA стали трендом

В период с октября по декабрь 2024 года исследователи из Positive Technologies зарегистрировали на 5% больше киберинцидентов, чем в III квартале, и на 13% — в сравнении с IV кварталом 2023 года.

Более половины успешных атак на организации приводили к утечкам, в 32% случаев было зафиксировано нарушение основной деятельности. Для индивидуальных пользователей такие нападения обычно оборачивались финансовыми потерями (48%).

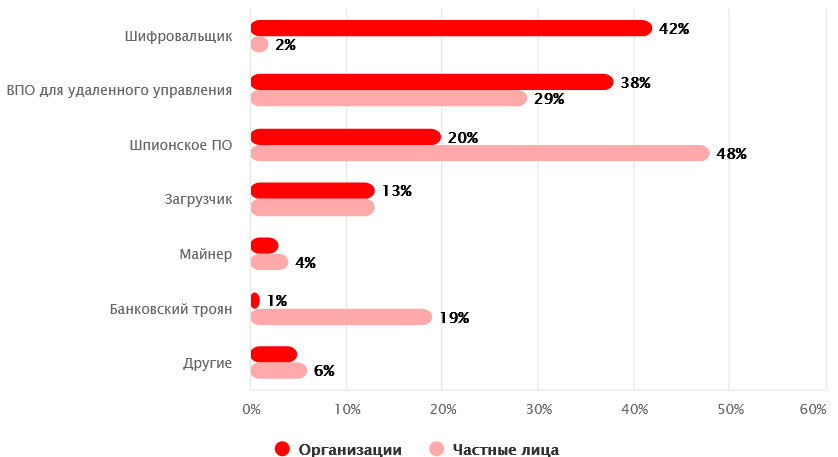
Основным инструментом злоумышленников по-прежнему является вредоносный софт. В отчетный период его применяли в 66% успешных атак на компании и в 51% атак, от которых пострадали частные лица.


В корпоративные сети зловреды в основном внедрялись посредством имейл-рассылок (84% успешных атак), обычных юзеров атаковали через сайты, соцсети и мессенджеры (44, 22 и 18% соответственно).

Особо аналитики отметили рост популярности имитаций CAPTCHA у распространителей вредоносных программ. Цепочку заражения запускает сама жертва, нажав кнопку «Я не робот» и следуя предложенным инструкциям.

«Настоящие проверки CAPTCHA никогда не требуют ввода команд в операционной системе и в пределах непосредственно веб-страницы, — напоминает аналитик Анна Голушко из PT. — Кроме того, настоящая CAPTCHA обычно не запрашивает логины, пароли, номера карт или другие сведения».

Схему заражения через такие фейки злоумышленники начали осваивать в III квартале, а к концу года их использование приобрело массовый характер. Чаще всего таким образом раздаются трояны-стилеры, такие как Lumma и Amadey.

Эксперты ожидают, что в этом году вредоносные CAPTCHA получат еще большее распространение, как и похожая схема ClickFix.

Подпишитесь на новости

PT Application Firewall получил защиту от атак на LLM

Корпоративному ИИ-ассистенту доверили документы, клиентские данные и доступ к системам. Теперь осталось проследить, чтобы командовать им не начал первый встречный. Positive Technologies разработала LLM Firewall — модуль защиты ИИ-сервисов в составе PT Application Firewall.

По словам компании, он проверяет запросы к языковым моделям и их ответы: ищет попытки обойти ограничения, вытащить системные инструкции, раскрыть конфиденциальную информацию или использовать возможности агента в интересах атакующего.

Одна из целей — противодействие инъекциям в промпт. Вредоносную инструкцию можно отправить боту напрямую или спрятать в документе, который тот обрабатывает. Внешне это обычный текст, а по замыслу — попытка назначить нейросети нового начальника.

Подозрительные обращения модуль позволяет блокировать либо фиксировать для последующего разбора. Отдельно заявлено обнаружение персональных данных, паролей, ключей доступа, а также токсичного и запрещённого контента.

Проверка работает в обе стороны: контролируется и то, что отправляют модели, и то, что она выдаёт пользователю. Секреты могут утечь не только из-за хитрого атакующего, но и благодаря очень старательному сотруднику.

LLM Firewall уже интегрирован в PT AF Cloud. Он подключается к обмену между приложением и моделью через API, совместимый с OpenAI Chat Completions и Responses. Отдельная консоль управления не требуется. В PT AF PRO для развёртывания внутри инфраструктуры заказчика модуль обещают добавить позднее.

Для разных ИИ-сервисов можно задавать свои политики, выбирать мониторинг или блокировку, отдельно настраивать проверку запросов и ответов. События поступают в PT AF для анализа и расследования.

RSS: Новости на портале Anti-Malware.ru