



В Сеть попали данные клиентов, предположительно, ПримСоцБанка

В Сеть попали данные клиентов, предположительно, ПримСоцБанка

В Сеть попали данные клиентов, предположительно, ПримСоцБанка

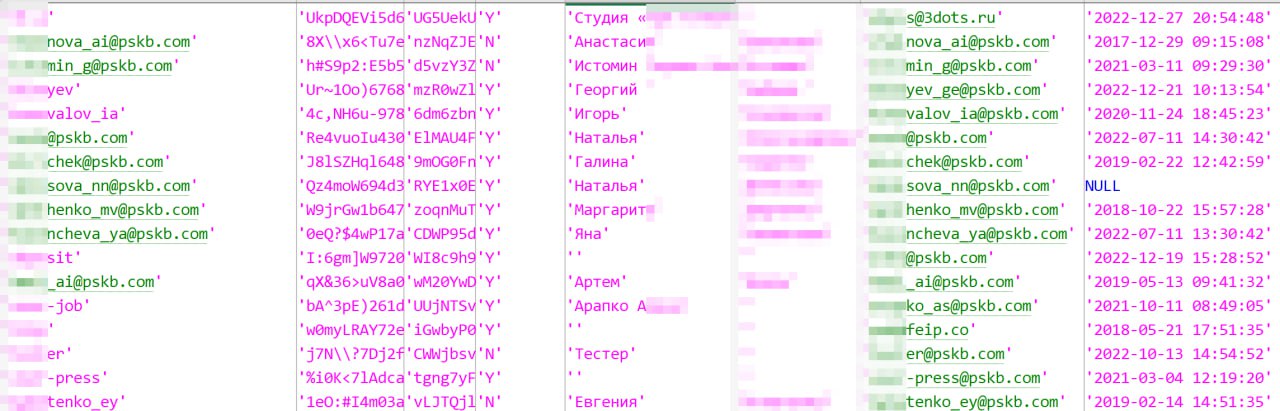
Частичный SQL-дамп из CMS «Bitrix», который может принадлежать сайту крупного Приморского краевого банка «ПримСоцБанк» (pskb.com), выложили в открытый доступ. Среди данных: логины, хешированные пароли, имейлы, имена, фамилии и т. п.

Как пишут «Утечки информации», сайт банка недоступен, поэтому исследователи не смогли проверить подлинность опубликованного дампа.

В таблице зарегистрированных пользователей обнаружено 90 848 записей, содержащих логины, хешированные пароли и адреса электронной почты (90 829 уникальных адресов), а также имена и фамилии пользователей за период с 22 декабря 2016 года по 29 декабря 2022 года.

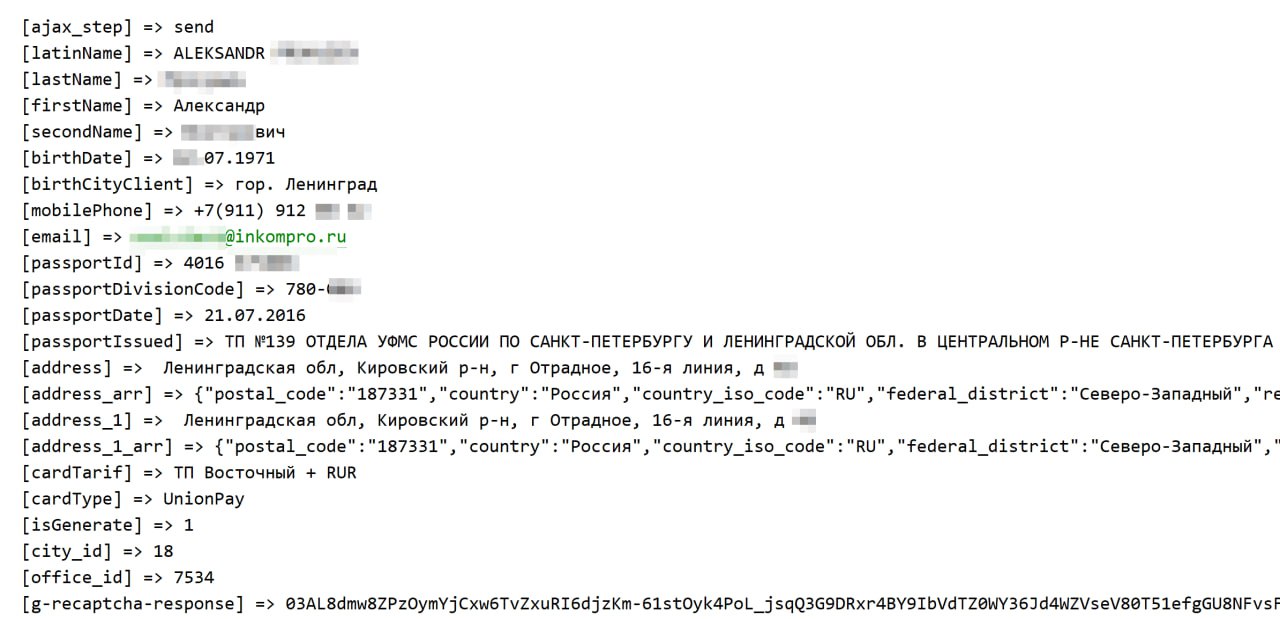
Кроме того, в открытый доступ попал текстовый файл с логами модуля регистрации заявок на банковские услуги.

Этот файл содержит 7 335 заявок, включающих ФИО, адреса электронной почты, телефоны (2 046 уникальных номеров), адреса проживания, паспортные данные (серия, номер, орган, выдавший документ, и дата выдачи), а также даты и места рождения за период с 16 февраля 2021 года по 21 июня 2023 года.


Напомним, вчера стало известно о продаже более 100 000 украденных аккаунтов ChatGPT на площадках дарквеба. А операторы BlackCat пообещали опубликовать 80 ГБ, украденных у Reddit.

Подпишитесь на новости

1,8 ТБ и вагон ошибок: как выгрузка с Яндекс Диска превратилась в квест

Пользователь «Яндекс Диска» решил сделать резервную копию 1,8 ТБ файлов, а также примерно 160 ГБ фотографий и получил приключение с ошибками API, зависшими загрузками и собственными скриптами.

По его словам, после октябрьских проблем с дата-центрами привычное скачивание папок через веб-интерфейс стало недоступно.

Подробности инженер Сергей Терёхин, известный как KenGuru66, описал  в собственном разборе на Хабре.

План был такой: rclone, сервер в Нидерландах, копия в Google Drive. Но стандартная аутентификация позволяла получить сведения о диске, а обращения к файлам возвращали ошибку 410. Доступ удалось наладить с другим OAuth-токеном.

Фотографии из безлимитной автозагрузки добавили веселья: для копирования через выбранный API их пришлось переместить в обычную папку. После этого они начали занимать место в тарифе. Более 30 тысяч снимков переносились около шести часов.

В выборке из 300 случайных файлов автор смог получить начало только 146. По важной папке с документами он скопировал и проверил по MD5 2315 файлов; ещё 3079 на момент публикации оставались недоступны.

Потерю данных автор не утверждает, он продолжает повторные загрузки. Скрипты опубликованы на GitHub.

RSS: Новости на портале Anti-Malware.ru