



Chrome и Firefox более года сливали данные пользователей Facebook

Chrome и Firefox более года сливали данные пользователей Facebook

Chrome и Firefox более года сливали данные пользователей Facebook

Более года браузеры Mozilla Firefox и Google Chrome раскрывали данные об именах пользователей Facebook, а также фотографии профилей и лайки, если те посещали сайт, на котором был установлен специальный скрипт. К такому выводу пришли исследователи в области безопасности.

Такая катастрофическая ошибка была спровоцирована так называемой уязвимостью сторонних каналов (side-channel vulnerability), которая возникла благодаря реализации браузерами новых стандартов для CSS введенных в 2016 году.

Одна из новых возможностей, получившая имя «mix-blend-mode», приводила к утечке размещенного на Facebook контента на сторонние сайты, которые содержали iframe и соответствующий код для сбора таких данных.

Как мы помним, «Правило ограничения домена» (Same Origin Policy, Принцип одинакового источника) запрещает доступ одного домена к содержимому, размещенному на другом домене. Именно потому, что данная брешь позволяла обойти эту политику, она считается крайне серьезной.

Проблема утечки была обнаружена двумя отдельными группами исследователей. Chrome устранил ее в версии 63, а две недели назад то же самое сделала Mozilla в Firefox 60.

Несмотря на то, что конкретно эта уязвимость более не угрожает пользователям, обновившим свои браузеры до актуальных версий, специалисты крайне озабочены все более мощными графическими возможностями, которые постепенно добавляют в HTML5 и CSS.

Эксперты считают, что эти возможности могут привести к появлению новых похожих проблем безопасности в будущем.

«CSS, HTML и JavaScript обладают многими функциями, которые могут стать проблемой для безопасности», — говорит эксперт Дарио Вейссер.

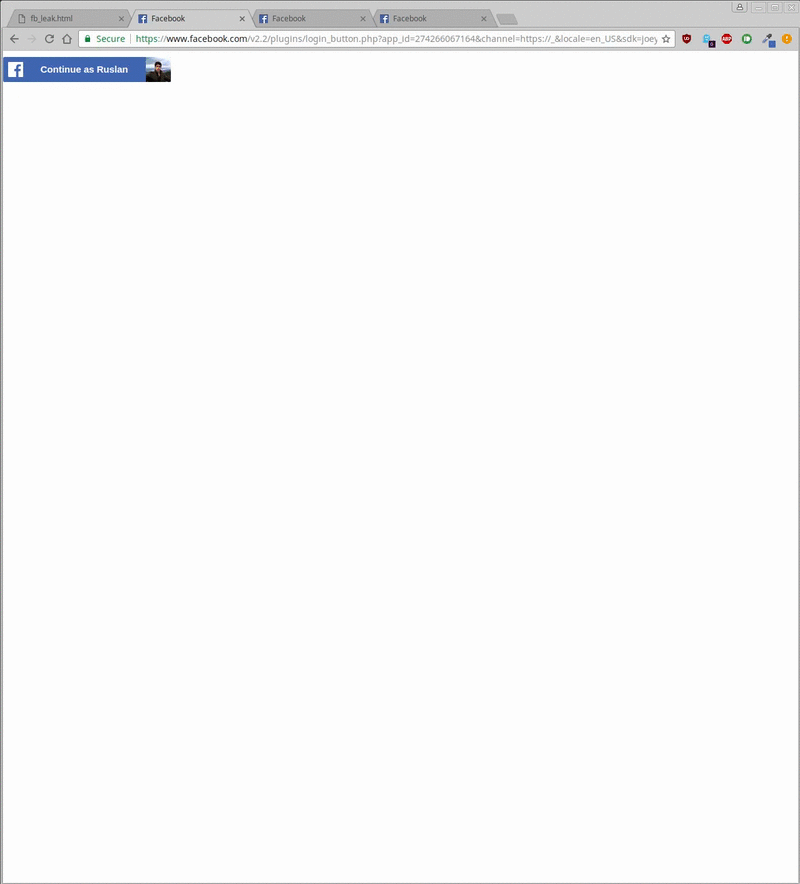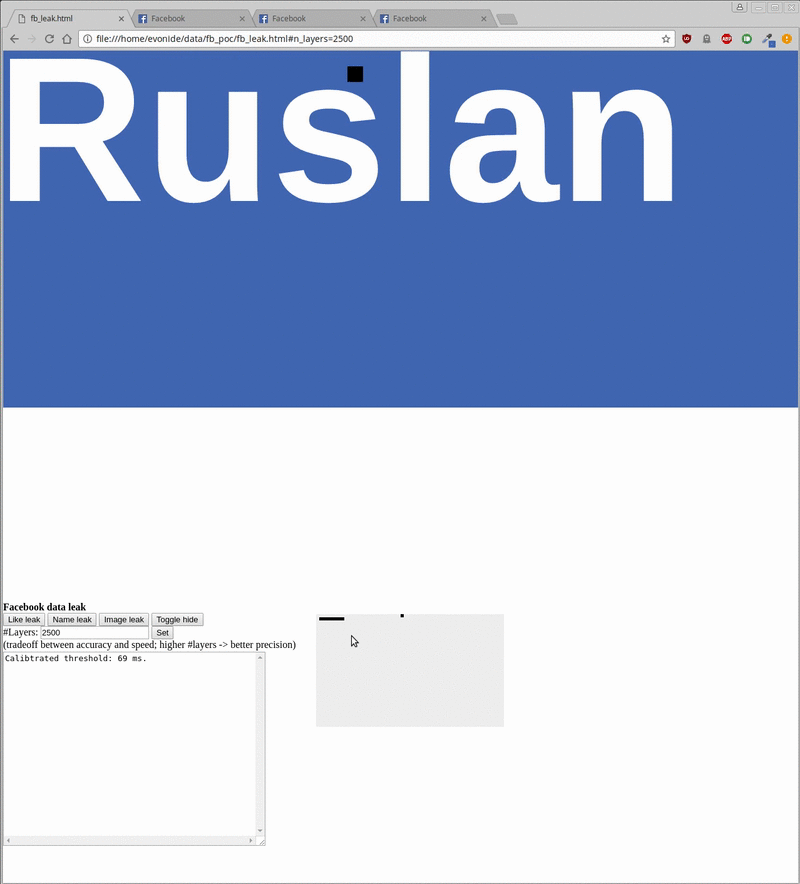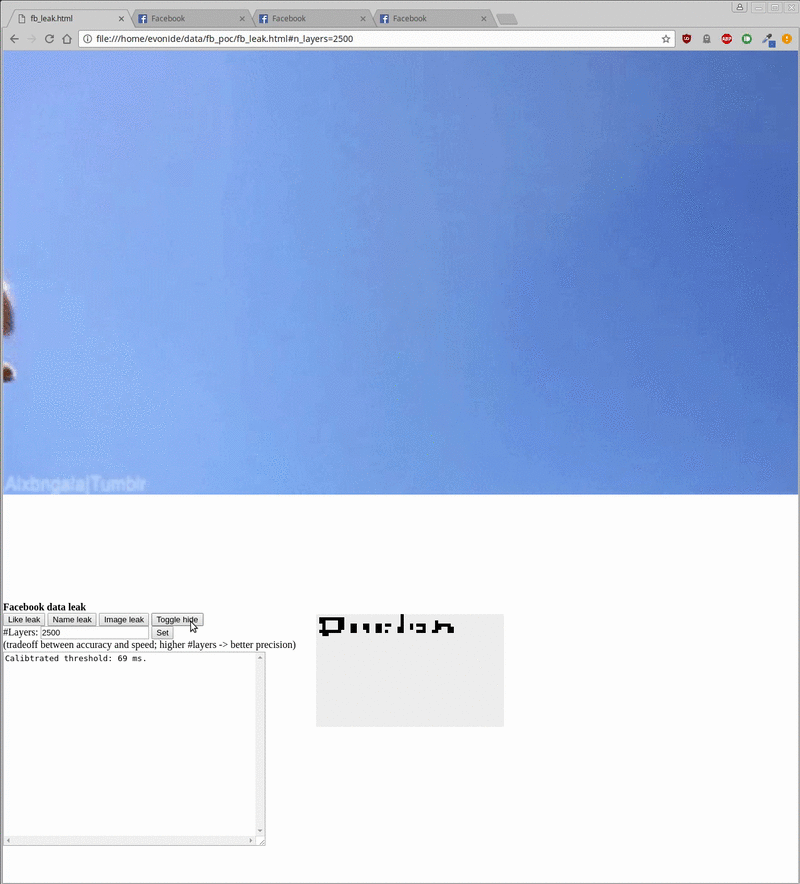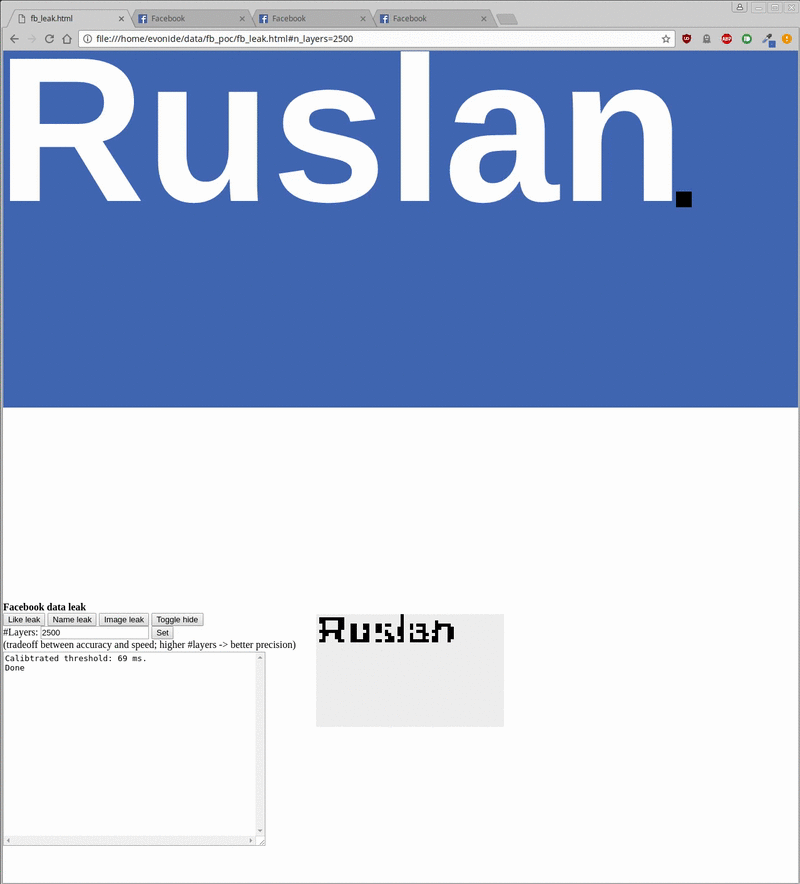
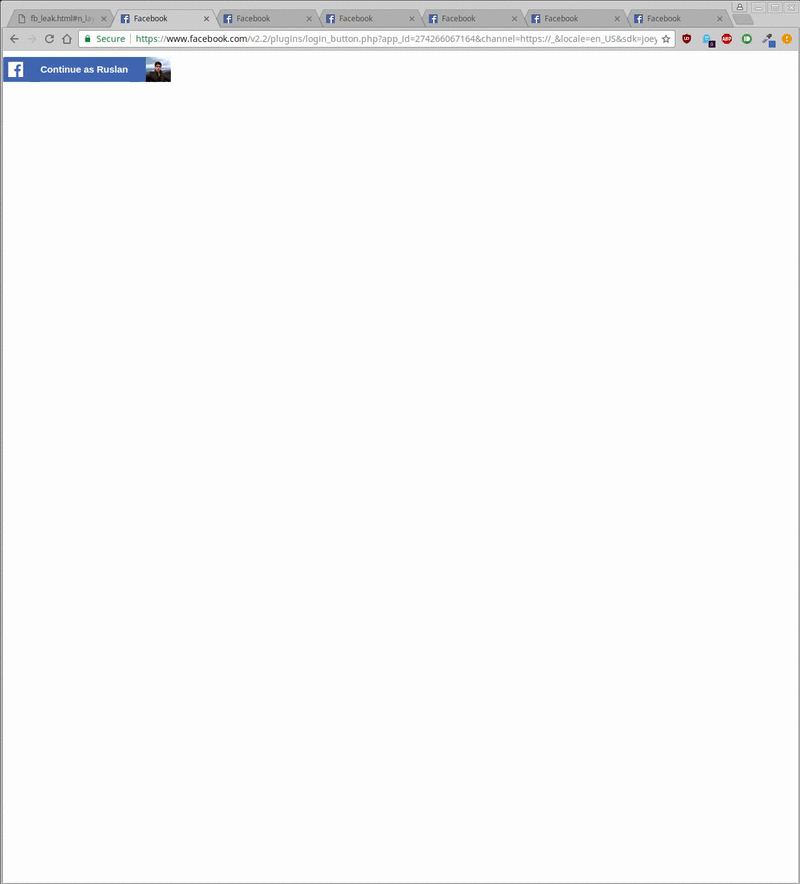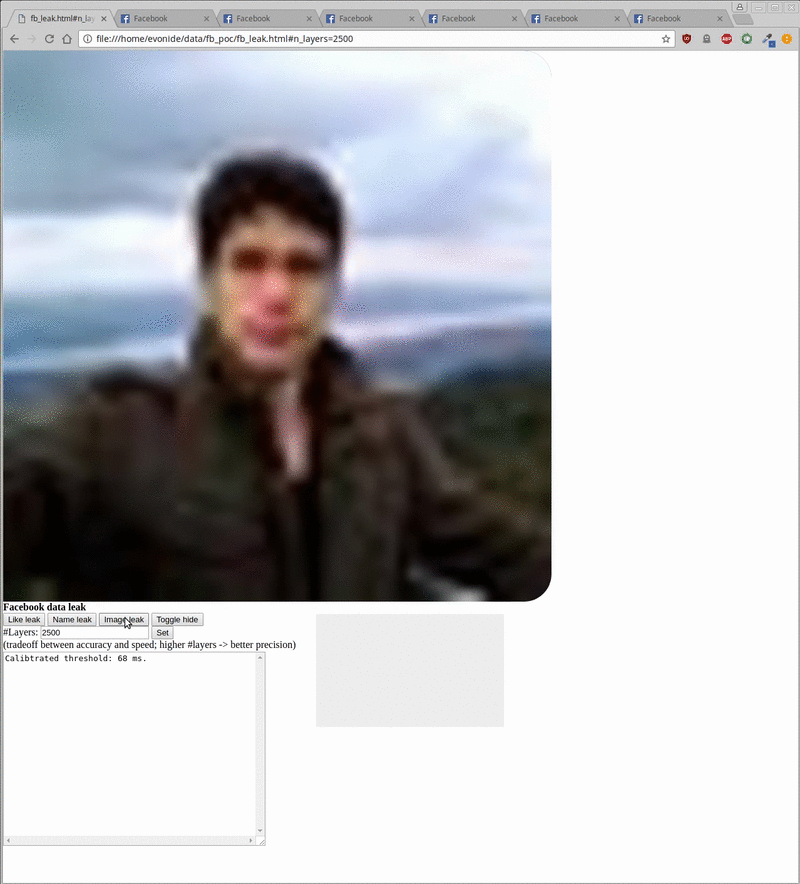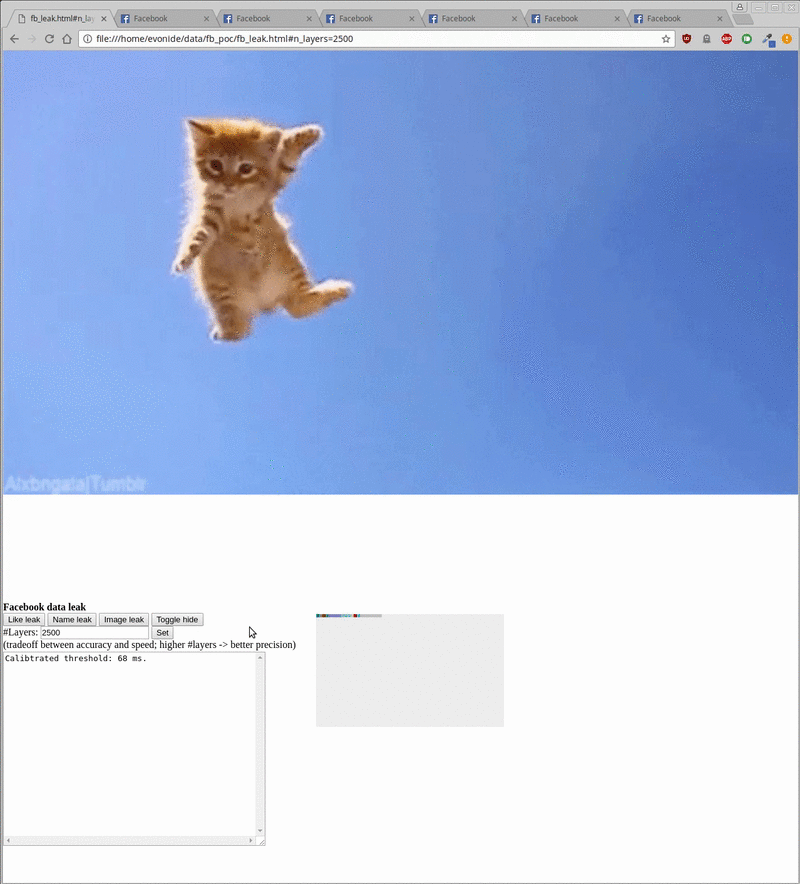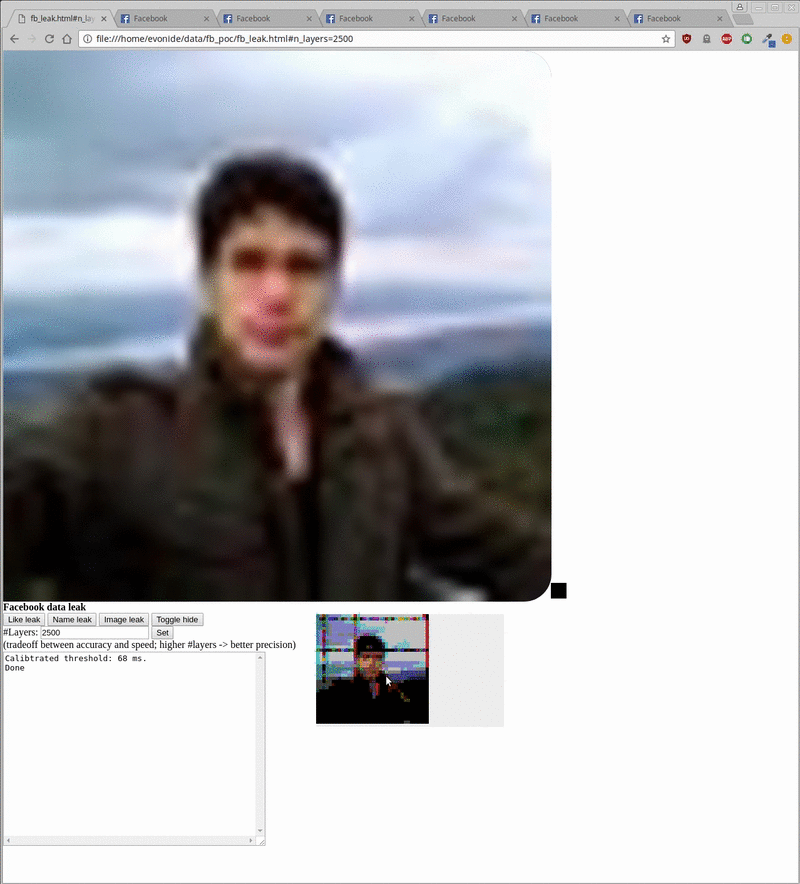
Специалист разработал PoC-код, который использовал iframe и социальный плагин Facebook для извлечения информации о профиле Facebook (имена, фото профиля, лайки). Демонстрацию работы proof-of-concept можно наблюдать ниже:

Подпишитесь на новости

Наталья Касперская поставила под сомнение доверие к генеративному ИИ

Генеративный ИИ умеет писать тексты и код, но можно ли на него полагаться? Наталья Касперская считает, что с доверием к таким системам пока больше вопросов, чем ответов. В интервью корреспонденту Anti-Malware.ru Олесе Афанасьевой на BIS Summit она назвала критерий доверенности применительно к генеративному ИИ загадкой.

По объяснению Касперской, доверенная система должна работать с заранее заданными параметрами и обеспечивать предсказуемый результат.

Генеративный ИИ, по её оценке, под это определение не подпадает: он не способен каждый раз выдавать один и тот же результат.

«Критерий доверенности в применении к генеративному искусственному интеллекту для меня является загадкой», — заявила она.

Главная проблема, считает Касперская, — масштаб моделей. Огромное количество параметров и данных делает полноценную проверку такой системы практически недостижимой. Можно протестировать отдельные ответы и сценарии, но это ещё не доказывает надёжность всей модели.

«Вы можете сделать какие-то выборочные проверки, частичные. Они будут выборочными и частичными, они ничего не докажут», — подчеркнула Касперская.

Получается неудобный вопрос для бизнеса и государства: как доверять системе, поведение которой нельзя исчерпывающе проверить? По словам председателя правления АРПП «Отечественный софт», задача создания доверенного ИИ поставлена, но готового способа её решения она пока не видит.

Одними разговорами, считает Касперская, проблему не закрыть. Нужна совместная работа специалистов по ИИ и информационной безопасности, методистов и разработчиков стандартов.

RSS: Новости на портале Anti-Malware.ru