



Chrome и Firefox более года сливали данные пользователей Facebook

Chrome и Firefox более года сливали данные пользователей Facebook

Chrome и Firefox более года сливали данные пользователей Facebook

Более года браузеры Mozilla Firefox и Google Chrome раскрывали данные об именах пользователей Facebook, а также фотографии профилей и лайки, если те посещали сайт, на котором был установлен специальный скрипт. К такому выводу пришли исследователи в области безопасности.

Такая катастрофическая ошибка была спровоцирована так называемой уязвимостью сторонних каналов (side-channel vulnerability), которая возникла благодаря реализации браузерами новых стандартов для CSS введенных в 2016 году.

Одна из новых возможностей, получившая имя «mix-blend-mode», приводила к утечке размещенного на Facebook контента на сторонние сайты, которые содержали iframe и соответствующий код для сбора таких данных.

Как мы помним, «Правило ограничения домена» (Same Origin Policy, Принцип одинакового источника) запрещает доступ одного домена к содержимому, размещенному на другом домене. Именно потому, что данная брешь позволяла обойти эту политику, она считается крайне серьезной.

Проблема утечки была обнаружена двумя отдельными группами исследователей. Chrome устранил ее в версии 63, а две недели назад то же самое сделала Mozilla в Firefox 60.

Несмотря на то, что конкретно эта уязвимость более не угрожает пользователям, обновившим свои браузеры до актуальных версий, специалисты крайне озабочены все более мощными графическими возможностями, которые постепенно добавляют в HTML5 и CSS.

Эксперты считают, что эти возможности могут привести к появлению новых похожих проблем безопасности в будущем.

«CSS, HTML и JavaScript обладают многими функциями, которые могут стать проблемой для безопасности», — говорит эксперт Дарио Вейссер.

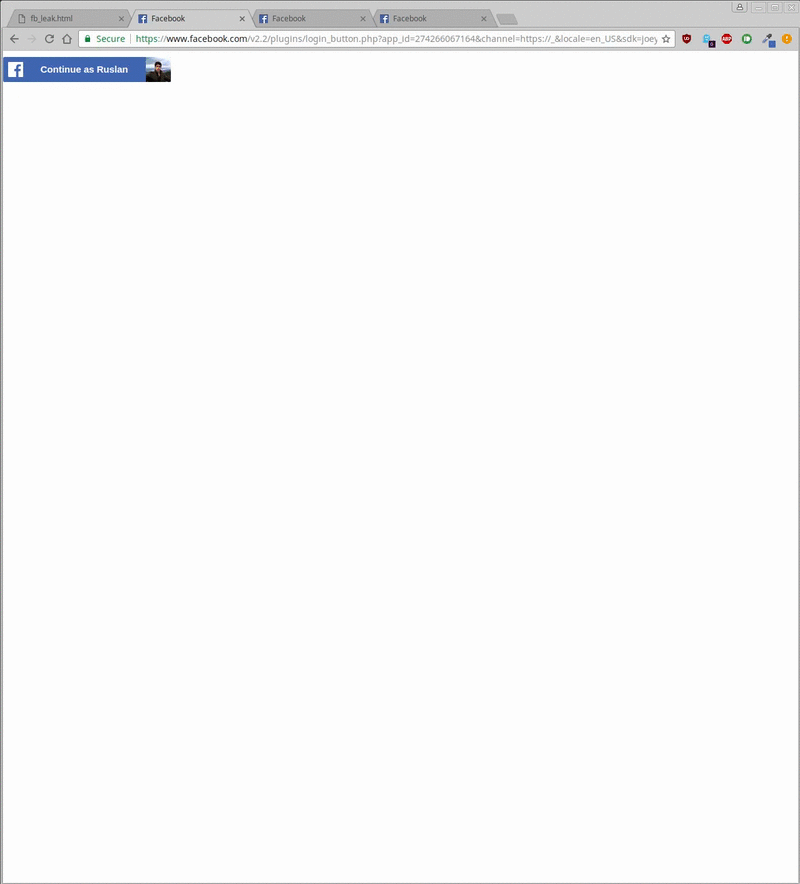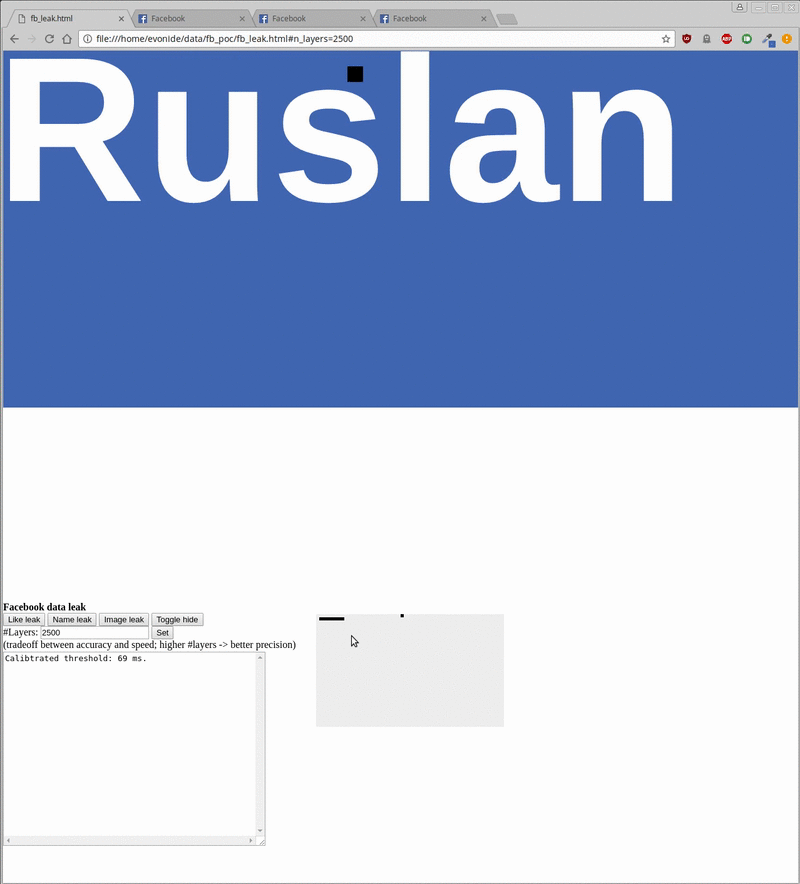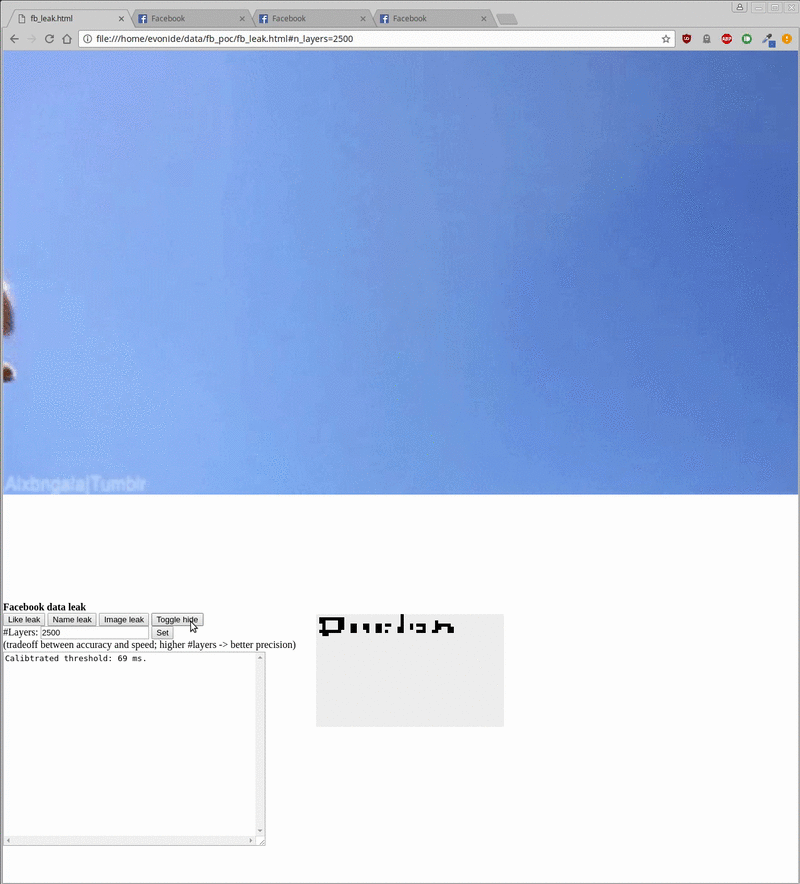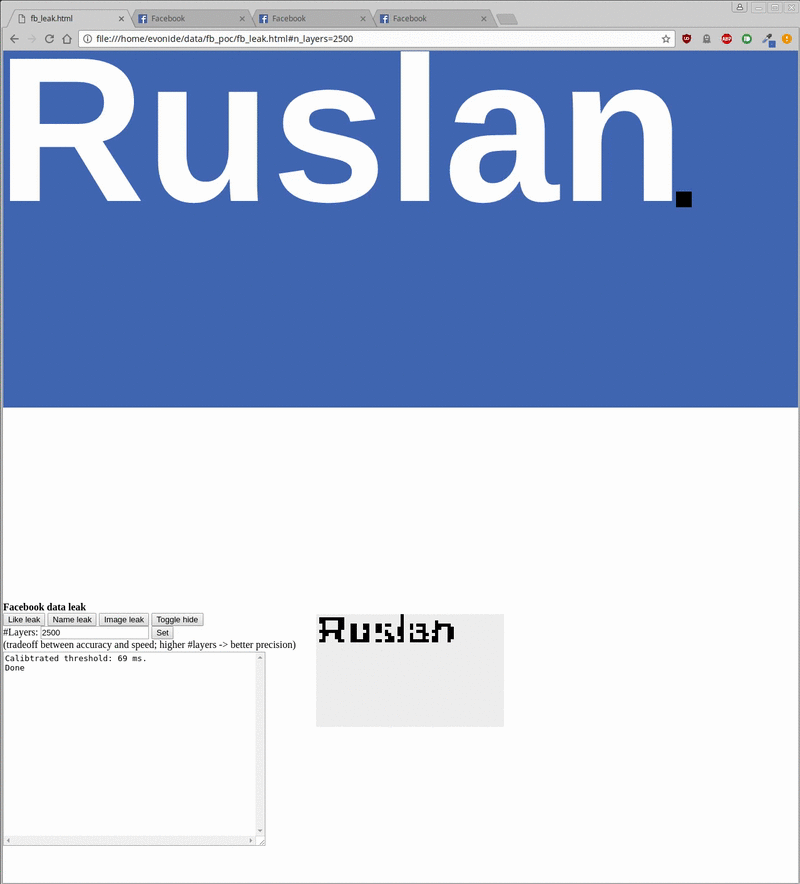
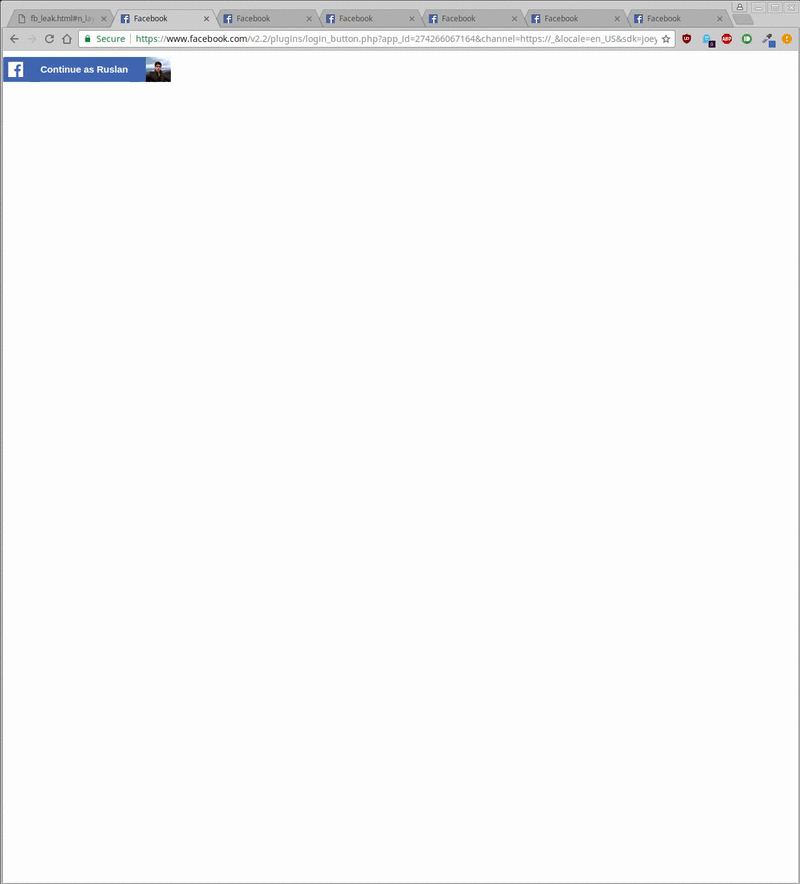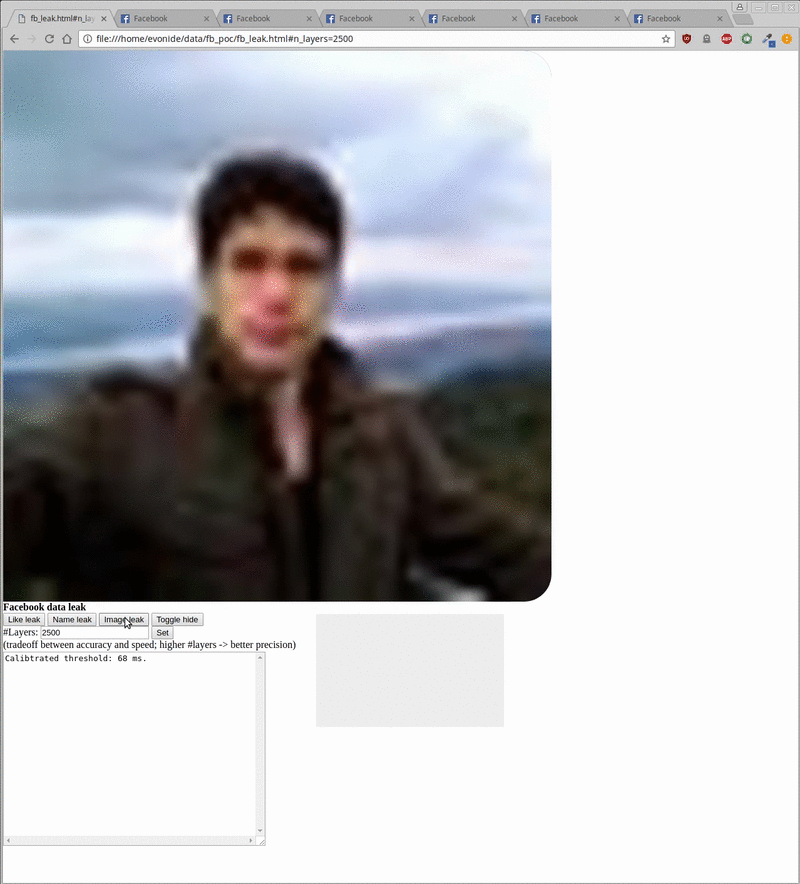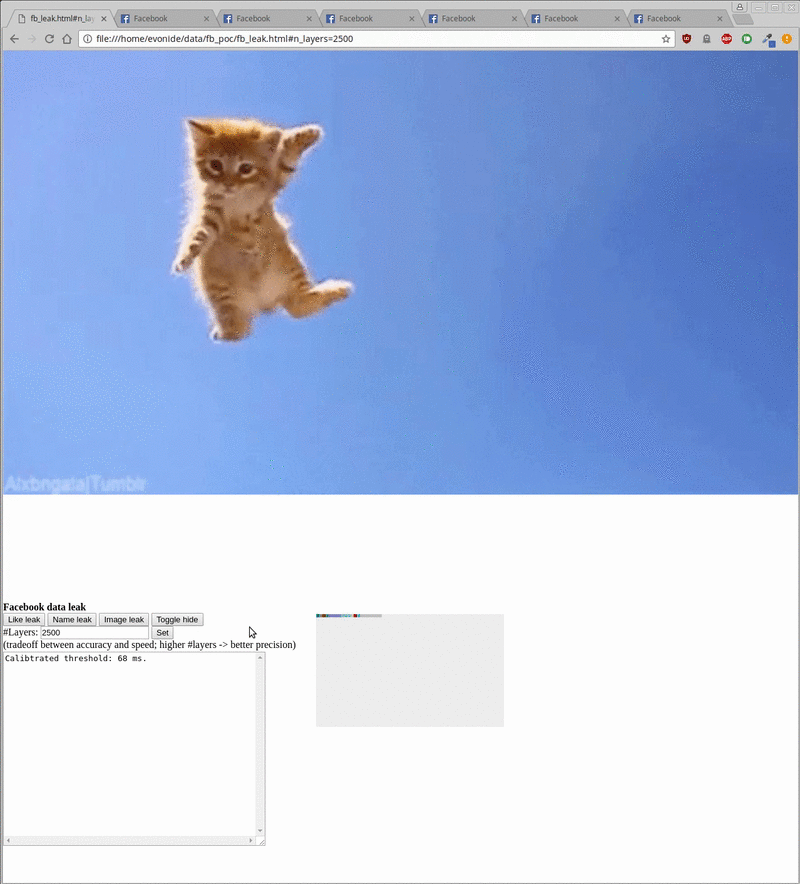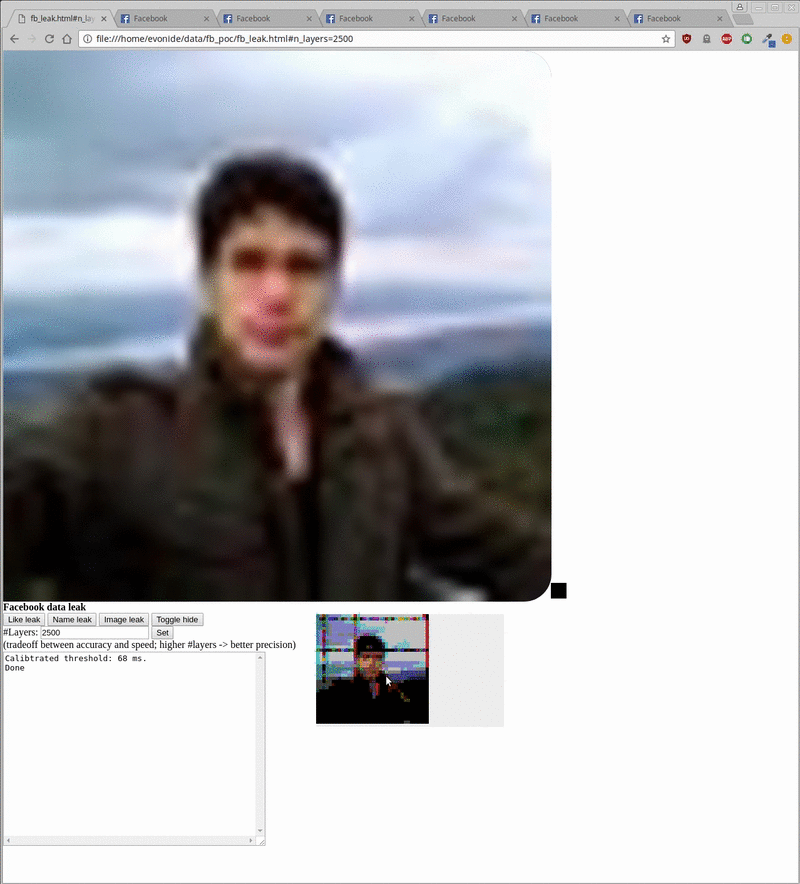
Специалист разработал PoC-код, который использовал iframe и социальный плагин Facebook для извлечения информации о профиле Facebook (имена, фото профиля, лайки). Демонстрацию работы proof-of-concept можно наблюдать ниже:

Подпишитесь на новости

Yandex B2B Tech объединила полнотекстовый и векторный поиск в одном запросе

Найти точный номер документа и одновременно разобраться, что пользователь имел в виду, — теперь обе задачи можно решать в YDB. Yandex B2B Tech добавила в базу данных гибридный поиск, объединяющий полнотекстовый и векторный подходы.

Как объясняют разработчики в блоге YDB, два вида поиска дополняют друг друга.

Например, в запросе о выплате по страховке номер полиса нужно найти точно, а описание страхового случая — сопоставить по смыслу, даже если в документах использованы другие формулировки.

Полнотекстовый поиск отвечает за слова, названия и коды, векторный — за смысловую близость. YDB объединяет результаты и ранжирует их внутри одного SQL-запроса.

Практический бонус для компаний: данные остаются в одной базе. Для такого сценария не нужно отдельно поддерживать поисковый движок и векторную базу, а затем следить, чтобы информация между ними не разъехалась. Индексы обновляются вместе с данными в рамках одной транзакции.

Технология рассчитана на чат-ботов, рекомендательные сервисы и ИИ-ассистентов, которым мало простого совпадения слов. Особенно когда приходится искать по технической информации, где точный код детали и человеческое описание проблемы одинаково важны.

Гибридный поиск доступен в корпоративной версии YDB 26.3 для развёртывания на собственной инфраструктуре и в облачном Managed Service for YDB.

RSS: Новости на портале Anti-Malware.ru