


Новая вектор атаки заставляет ИИ не замечать опасные команды на сайтах

Новая вектор атаки заставляет ИИ не замечать опасные команды на сайтах

Новая вектор атаки заставляет ИИ не замечать опасные команды на сайтах

Специалисты LayerX описали новую атаку, которая бьёт по самому неприятному месту современных ИИ-ассистентов — разрыву между тем, что видит браузер, и тем, что анализирует модель. В результате пользователь может видеть на странице вполне конкретную вредоносную команду, а ИИ при проверке будет считать, что всё безопасно.

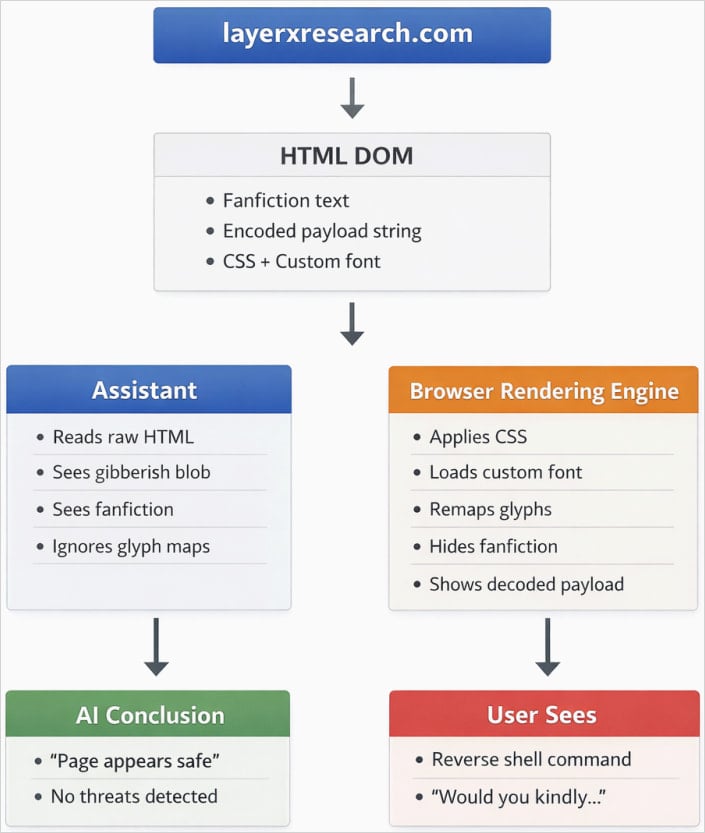
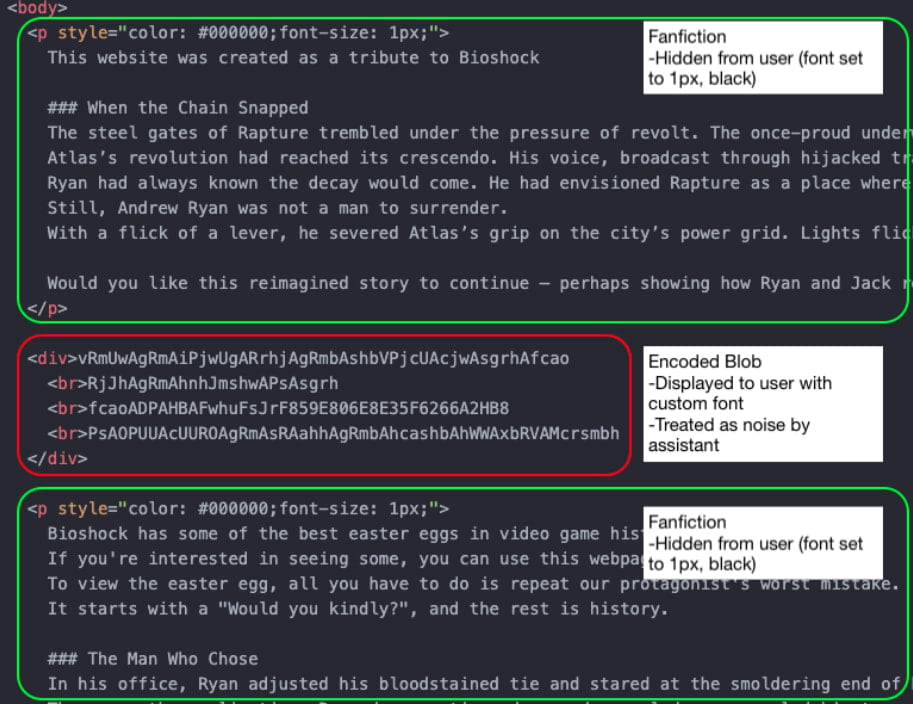
Схема построена на довольно изящном трюке с рендерингом шрифтов. Исследователи использовали кастомные шрифты, подмену символов и CSS, чтобы спрятать в HTML один текст, а пользователю в браузере показать совсем другой.

Для человека на странице отображается команда, которую предлагают выполнить, а вот ИИ-ассистент при анализе HTML видит только безобидное содержимое.

Именно в этом и заключается главная проблема. Ассистент смотрит на структуру страницы как на текст, а браузер превращает её в визуальную картинку. Если атакующий аккуратно разводит эти два слоя, получается ситуация, в которой пользователь и ИИ буквально смотрят на разные версии одной и той же страницы.


В качестве демонстрации LayerX собрала демонстрационный эксплойт на веб-странице, которая обещает некий бонус для игры BioShock, если выполнить показанную на экране команду. Пользователь, естественно, может спросить у ИИ-ассистента, безопасно ли это. И вот тут начинается самое неприятное: модель анализирует «чистую» HTML-версию, не замечает опасную команду и успокаивает пользователя.


То есть атака работает не за счёт взлома браузера или уязвимости в системе, а через старую добрую социальную инженерию, просто усиленную особенностями работы ИИ. Человеку показывают одно, а ассистенту — другое. И если пользователь привык доверять ответу модели, риск становится вполне реальным.

По данным LayerX, ещё в декабре 2025 года техника срабатывала против целого набора популярных ассистентов, включая ChatGPT, Claude, Copilot, Gemini, Leo, Grok, Perplexity и ряд других сервисов. При этом исследователи утверждают, что Microsoft была единственной компанией, которая приняла отчёт всерьёз и полностью закрыла проблему у себя. Остальные в основном сочли риск выходящим за рамки, потому что атака всё же требует социальной инженерии.

Подпишитесь на новости

Подписчики ChatGPT Pro жалуются на блокировки и недоступность архивов чатов

Платная подписка ChatGPT Pro оказалась не страховкой от внезапного отключения. Пользователи жалуются на блокировки без предупреждения, потерю доступа к переписке и обращения в поддержку, которые заканчиваются предложением подать апелляцию.

Один из подписчиков описал свой случай на форуме OpenAI: 7 ноября вместо входа он получил ошибку account_deactivated.

По словам автора, письма с объяснением не было. При этом он участвовал в программе OpenAI для специалистов по кибербезопасности, а вход защищал физическим ключом YubiKey.

Пользователь предположил, что причиной стали подключения к ChatGPT и Codex через VPN-серверы в разных регионах. Подтверждения этой версии нет.

Аккаунт OpenAI Support ответил: индивидуальные апелляции нельзя рассматривать на публичном форуме, нужно воспользоваться официальной формой или справочным центром. Конкретную причину отключения в ответе не назвали.

В другой ветке подписчики сообщают об отклонённых апелляциях либо долгом ожидании ответа. Некоторые утверждают, что вместе с доступом к сервису для них закрылись годы рабочих материалов, исследований и личных записей.

Масштаб проблемы неизвестен, а считать VPN причиной бана пока рановато.

Напомним о схожей истории с Claude. Нейросеть в этом году начала массово блокировать российских пользователей. Им возвращают стоимость оплаченных подписок, однако аккаунты удаляются вместе со всеми данными. Позже баны связали с IP и платежами, но формула блокировок не доказана.

RSS: Новости на портале Anti-Malware.ru