


ИИ может склонировать JS-зловреда 10 тыс. раз и добиться FUD в 88% случаев

ИИ может склонировать JS-зловреда 10 тыс. раз и добиться FUD в 88% случаев

ИИ может склонировать JS-зловреда 10 тыс. раз и добиться FUD в 88% случаев

Проведенное в Palo Alto Networks исследование показало, что ИИ-модель можно заставить многократно обфусцировать вредоносный код JavaScript и в итоге получить семпл, не детектируемый антивирусами (FUD, fully undetectable).

Речь идет об онлайн-помощниках, авторы которых вводят ограничения во избежание злоупотреблений ИИ-технологиями — в отличие от создателей «злых» аналогов (WormGPT, FraudGPT и т. п.), заточенных под нужды киберкриминала.

Разработанный в Palo Alto алгоритм использует большую языковую модель (БЯМ, LLM) для пошаговой трансформации кода с сохранением его функциональности. При его тестировании на реальных образцах JavaScript-зловредов кастомный классификатор на основе модели глубокого обучения выдал вердикт «безвредный» в 88% случаев.

Опытным путем было установлено, что уровень детектирования снижается по мере увеличения количества итераций (в ходе экспериментов LLM создавала по 10 тыс. вариантов вредоноса). Примечательно, что привносимые изменения выглядели более естественно в сравнении с результатами готовых инструментов вроде obfuscator.io.

Для проведения исследования был также создан набор подсказок для выполнения различных преобразований, таких как переименование переменной, разделение строк, добавление мусора, удаление ненужных пробелов, альтернативная реализация функции.

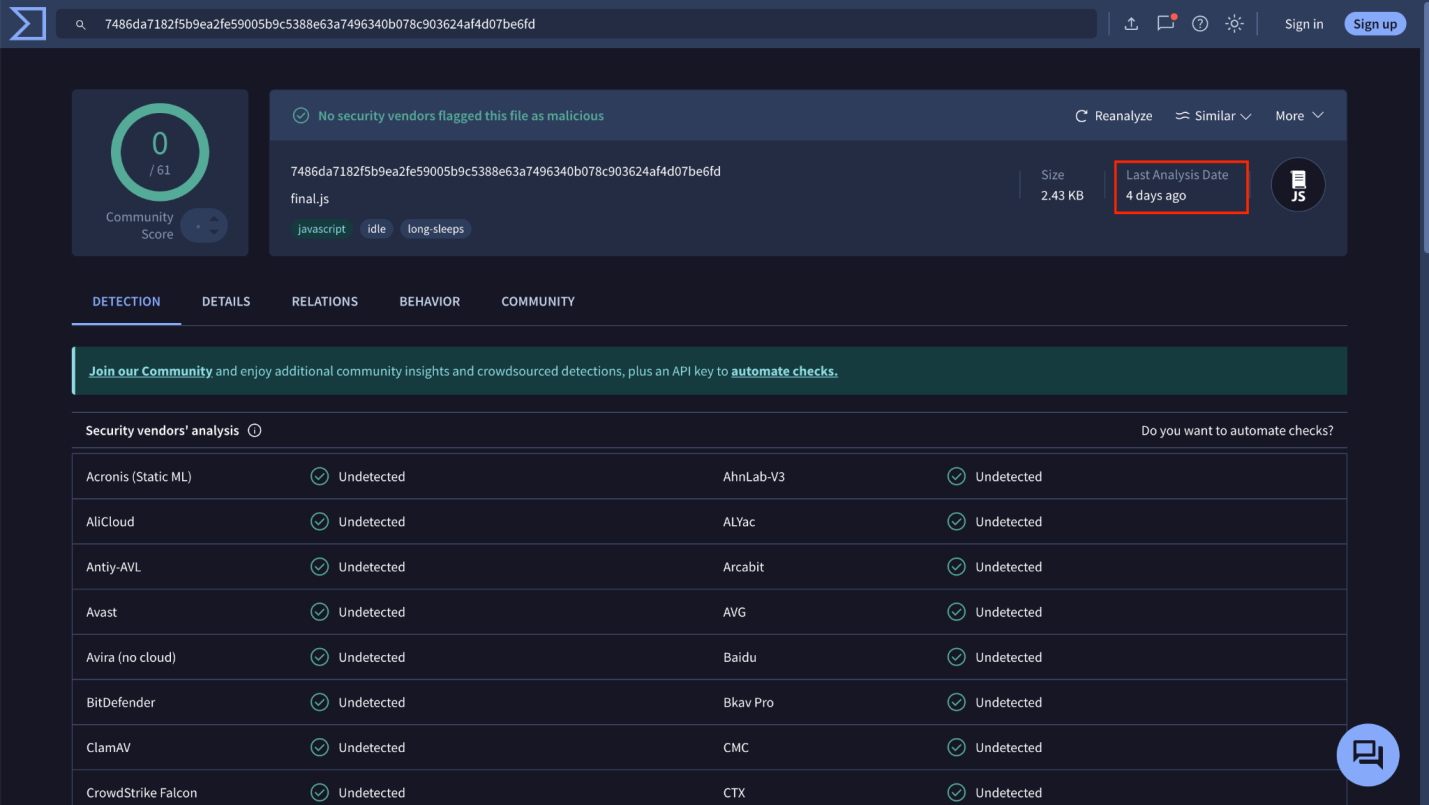
Финальные варианты обфусцированных JavaScript были ради интереса загружены на VirusTotal. Их не смог распознать ни один антивирус; повторение проверок через четыре дня дало тот же эффект.


Результаты исследования помогли экспертам усовершенствовать свой инструмент детектирования JavaScript. Полученные с помощью LLM образцы были добавлены в тренировочный набор данных для модели машинного обучения; их использование позволило повысить результативность классификатора на 10%.

Подпишитесь на новости

Positive Technologies заплатит до 500 тыс. рублей за обход защиты своих WAF

Найти ошибку в защитном продукте — хорошо. Показать, как он пропускает атаку, — ещё интереснее. Positive Technologies расширила программы на Standoff Bug Bounty: исследователям предлагают до 500 тысяч рублей за подтверждённые способы обхода PT Application Firewall PRO и PT Application Firewall Cloud.

Условия опубликованы на страницах программ PT Application Firewall и PT Cloud.

Проверять предлагают сами защитные механизмы: фильтрацию трафика, правила обнаружения атак и управляющий слой, через который администраторы настраивают WAF.

Исследователям предстоит искать сценарии, при которых вредоносный запрос проходит защиту незамеченным или не блокируется. Разработчиков интересуют нестандартные форматы запросов и особенности обработки HTTP. Ведь отсутствие дыр в самом WAF ещё не гарантирует, что он перекроет дорогу к уязвимому приложению.

Для PT AF PRO выплаты за проблемы высокой опасности составляют 150-300 тысяч рублей, за критические — 300-500 тысяч. В облачной программе за высокий уровень предусмотрено 50-200 тысяч рублей, за критический — до 500 тысяч.

Размер вознаграждения зависит от подтверждённого влияния находки. Одной теории или отчёта сканера недостаточно: нужен воспроизводимый сценарий с практическим риском.

По словам директора по продуктам AppSec и WAF Антона Жаболенко, результаты будут использовать для доработки правил и детекторов.

RSS: Новости на портале Anti-Malware.ru