


Google Chrome улучшит защиту от фишинга, сократив скорость реагирования

Google Chrome улучшит защиту от фишинга, сократив скорость реагирования

Google Chrome улучшит защиту от фишинга, сократив скорость реагирования

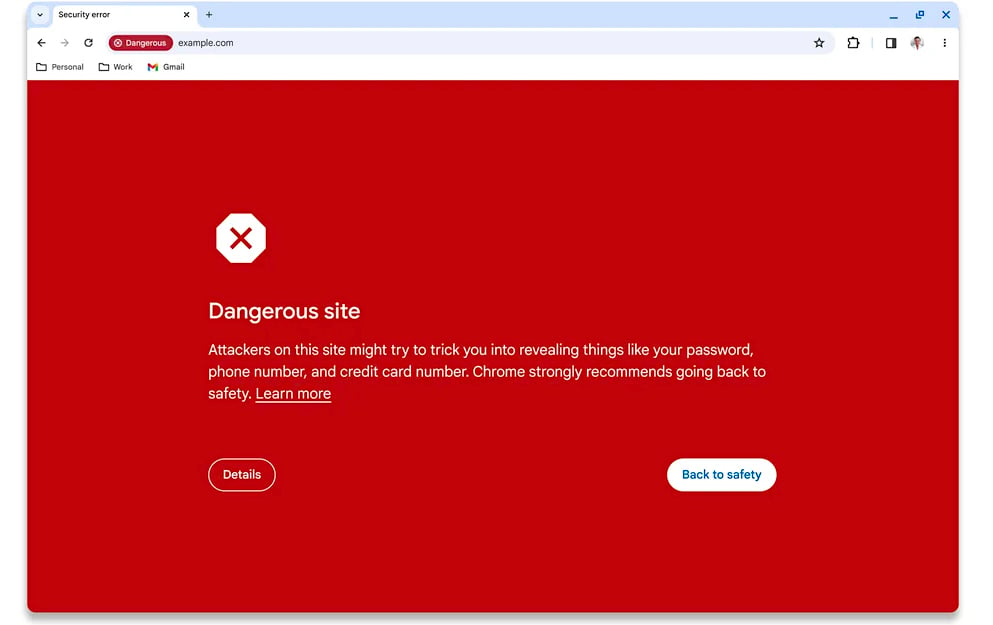
Google планирует выпустить обновление защитного механизма Safe Browsing в конце этого месяца для всех пользователей Chrome. После этого браузер будет в режиме реального времени защищать от вредоносных программ и фишинга.

Функциональность Safe Browsing — довольно древняя, её запустили аж в 2005 году. Изначально задача заключалась в защите пользователей от фишинга, однако позже возможности расширились до блокировки вредоносных доменов.

Разработчики добавили режим Enhanced Protection, который задействовал искусственный интеллект для противодействия кибератакам и более глубоко сканировал загруженные файлы.

На сегодняшний день Safe Browsing проверяет сайты, загрузки и расширения, сопоставляя их с локальным списком вредоносных URL, который обновляется с серверов Google каждые 30-60 минут.

Теперь корпорация хочет переключаться на проверки в режиме реального времени, когда информация будет приходить от серверов без какой-либо задержки. Скорость реагирования крайне важна, ведь некоторые вредоносные ресурсы появляются и исчезают меньше чем за десять минут.


Для этого Safe Browsing будет использовать новый API с релеем Fastly Oblivious HTTP (OHTTP) для обфускации URL помещаемых сайтов. Части хешированных URL передаются движку Safe Browsing через частный сервер OHTTP.

«Сервер удаляет всё, что может идентифицировать пользователя, — например, IP-адрес — и отправляет зашифрованные префиксы хеша серверу Safe Browsing. У Google не будет доступа к User Agent и IP-адресу пользователей», — объясняет Google в блоге.

Подпишитесь на новости

1,8 ТБ и вагон ошибок: как выгрузка с Яндекс Диска превратилась в квест

Пользователь «Яндекс Диска» решил сделать резервную копию 1,8 ТБ файлов, а также примерно 160 ГБ фотографий и получил приключение с ошибками API, зависшими загрузками и собственными скриптами.

По его словам, после октябрьских проблем с дата-центрами привычное скачивание папок через веб-интерфейс стало недоступно.

Подробности инженер Сергей Терёхин, известный как KenGuru66, описал  в собственном разборе на Хабре.

План был такой: rclone, сервер в Нидерландах, копия в Google Drive. Но стандартная аутентификация позволяла получить сведения о диске, а обращения к файлам возвращали ошибку 410. Доступ удалось наладить с другим OAuth-токеном.

Фотографии из безлимитной автозагрузки добавили веселья: для копирования через выбранный API их пришлось переместить в обычную папку. После этого они начали занимать место в тарифе. Более 30 тысяч снимков переносились около шести часов.

В выборке из 300 случайных файлов автор смог получить начало только 146. По важной папке с документами он скопировал и проверил по MD5 2315 файлов; ещё 3079 на момент публикации оставались недоступны.

Потерю данных автор не утверждает, он продолжает повторные загрузки. Скрипты опубликованы на GitHub.

RSS: Новости на портале Anti-Malware.ru