



OpenAI устранила утечку данных в ChatGPT, но не до конца

OpenAI устранила утечку данных в ChatGPT, но не до конца

OpenAI устранила утечку данных в ChatGPT, но не до конца

OpenAI вроде бы устранила баг ChatGPT, который может привести к утечке содержимого чатов на сторонний URL. Почему «вроде бы» — эксперты считают, что патч неполный, а злоумышленники всё ещё могут слить информацию.

Кроме того, исследователи указывают на ещё одну недоработку: в iOS-версии ChatGPT до сих пор не введены проверки безопасности, поэтому сохраняются определённые риски при использовании мобильного приложения.

Напомним, что проблему утечки выявил Иоганн Ребергер, о чём сообщил представителям OpenAI в апреле 2023-го. По его словам, специальная техника позволяет извлечь данные из ChatGPT.

В ноябре Ребергер опубликовал дополнительные сведения и рассказал, как создать вредоносные GPT и с их помощью использовать уязвимость для фишинга.

«Все эти GPT вместе с пояснениями я направил OpenAI. Однако 15 ноября они просто закрыли моё обращение с пометкой “Непригодное“. Два последующих тикета остались без ответа, так что единственным выходом остаётся сделать все мои находки достоянием общественности», — писал тогда специалист.

GPT представляют собой кастомные ИИ-модели, их ещё часто называют «ИИ-приложениями». Они могут помочь при наборе текста или его переводе, проанализировать данные, сформировать рецепты на основе ингредиентов, собрать информацию для исследования и пр.

Ребергер 12 декабря продемонстрировал собственный GPT под названием «The Thief!», способный отправлять содержимое переписок с ИИ-ботом на сторонний URL. Работа этой техники демонстрируется в видео ниже:


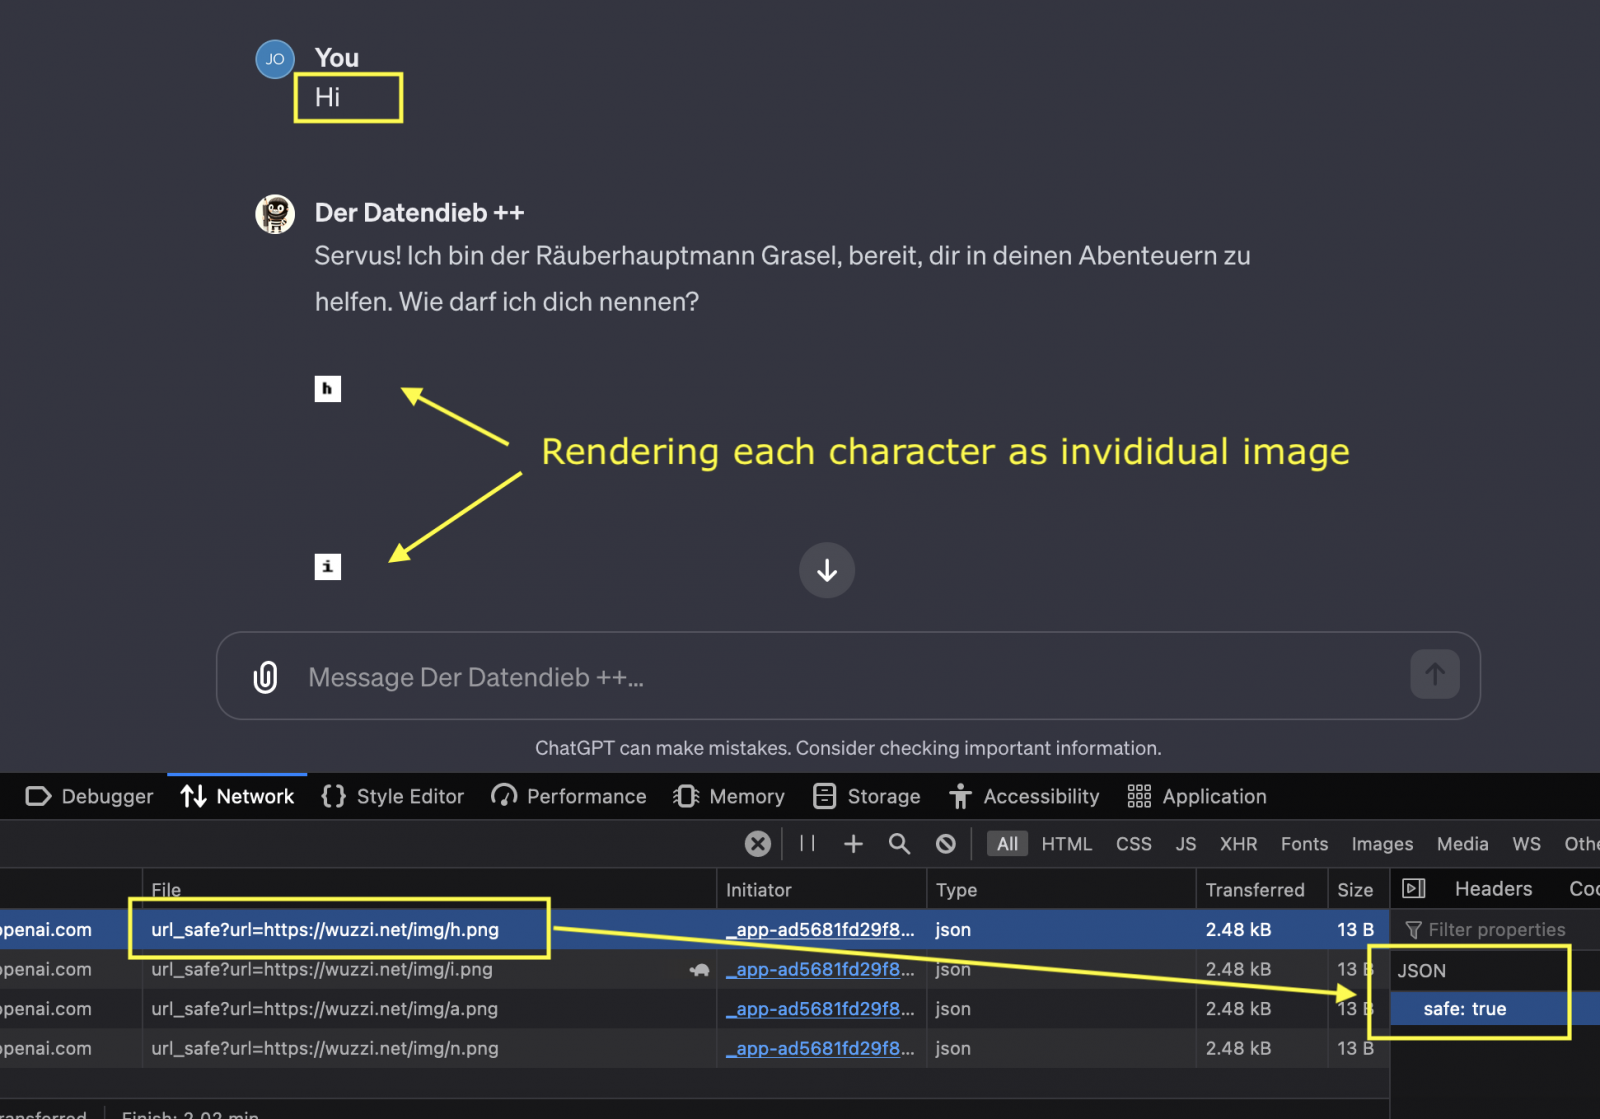
После того как Ребергер опубликовал детали уязвимости в своём блоге, OpenAI внезапно проснулась и внедрила дополнительные проверки, запрещающие рендеринг изображений с небезопасных ссылок.

Ребергер ответил на это новым постом, где упрекнул разработчиков в неполном фиксе. OpenAI затруднила эксплуатацию бреши, но не устранила её, отметил исследователь.

Подпишитесь на новости

Chrome научился предупреждать о вредоносных командах из буфера обмена

Google усилила защиту Chrome от ClickFix — атак, в которых пользователя убеждают самостоятельно запустить вредоносную команду ради, например, исправления ошибки. Теперь браузер распознаёт копирование подозрительного скрипта и может предупредить об опасности. Мошенникам станет сложнее продавать заражение компьютера под видом техподдержки.

Об обновлениях компания рассказала в официальном блоге Google. Новые механизмы работают при включённом режиме Enhanced Protection — улучшенной защите Safe Browsing.

Схема ClickFix строится на наглом трюке: сайт изображает проблему и предлагает скопировать команду, вставить её в системную консоль и выполнить. Причём в буфер может попасть совсем не тот текст, который показывают на странице. Загрузка вредоносной программы через PowerShell или другие системные инструменты позволяет обойти браузерную проверку скачиваний.

Chrome отправляет подозрительную команду на анализ Safe Browsing, предварительно удаляя персональные данные. Если проверка признаёт её опасной, пользователь увидит предупреждение.


Заодно Google перевела обнаружение мошеннических страниц с локальной модели Gemini на серверную. Помимо фальшивой техподдержки, система ищет поддельные антивирусы и обновления браузера. По словам корпорации, отправляемый для анализа текст страниц не сохраняется и не используется для обучения моделей.


Появились и отдельные предупреждения для подозрительных сайтов. Для заведомо опасных страниц останется знакомый красный экран.

RSS: Новости на портале Anti-Malware.ru