



ФБР может собирать данные из WhatsApp почти в реальном времени

ФБР может собирать данные из WhatsApp почти в реальном времени

ФБР может собирать данные из WhatsApp почти в реальном времени

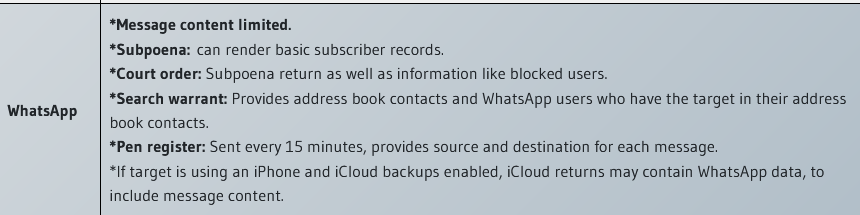
В Сеть слито внутреннее руководство ФБР по получению данных из мессенджеров, из которого следует, что федеральные агенты имеют ограниченный доступ к содержимому сообщений в iMessage, Line и WhatsApp — несмотря на сквозное шифрование. В последнем случае они могут также с разрешения IM-провайдера регистрировать источник и пункт назначения сообщений каждые 15 минут.

Глобальная аудитория WhatsApp обширна, в настоящее время им пользуются 2 млрд человек, и для правоохраны любого государства это кладезь полезной информации. ФБР давно ратует за более свободный доступ к данным таких сервисов в интересах расследований, и провайдеры, не выдержав давления или желая проявить лояльность, иногда уступают таким требованиям.

Документ ФБР от 7 января 2021 года, ставший достоянием общественности, опубликовала на своем сайте американская НКО Property of the People. Репортер The Record взял на себя труд прояснить плохо читаемый текст и переиначил таблицу для своей заметки.

Теперь всем ясно, что ФБР имеет возможность читать сообщения только в названных мессенджерах. В Signal, Telegram, Threema, Viber, WeChat и Wickr у спецслужбы такого доступа нет.

В случае WhatsApp федеральные агенты даже могут, не прибегая к правовым рычагам, получить сообщения, сохраненные в облаке (когда подозреваемый использует iPhone с включенной службой iCloud). Остальное — ПДн подписчика, списки контактов, сведения о блокировке — с провайдера можно стребовать лишь через обращение в суд.


Вполне вероятно, что у ФБР есть и другие возможности для получения доступа к защищенной информации. В прошлом году американские правозащитники попытались через суд выяснить, действительно ли у спецслужбы есть своя команда хакеров, ломающих мобильные устройства. Чем закончился этот порыв, пока неизвестно.

Подпишитесь на новости

Codex и Kimi провалили задачи после перевода промптов на русский

Попросили ИИ исправить код по-русски, а он сразу же решил обойтись без интернета и начал придумывать решение. Такое поведение заметила автор проекта worklore Валентина Конюхова: в её эксперименте Codex и Kimi K3.1 пропускали поиск, которым пользовались при англоязычных заданиях.

Подробности и методику она опубликовала на Хабре.

Автор провела 1350 прогонов: шесть задач, девять конфигураций агентов, задания на русском и английском (с подсказками и без них). У всех был доступ в интернет.

На одной задаче Codex с низким уровнем рассуждений нашёл нужный формат на форуме и справился во всех пяти англоязычных прогонах.


С русским заданием он ни разу не обратился в Сеть и получил ноль успешных решений. У Kimi K3.1 похожий провал произошёл на задаче с OAuth.

Зато заметка с нужным фактом возвращала результат до пяти успешных результатов из пяти. В среднем подсказки повышали успешность на 33 процентных пункта для английских заданий и на 39 — для русских. Язык самой заметки почти ничего не менял.


Стоит учитывать, что задач в примере было всего шесть, повторов немного, а причину изменения поведения автор не проверяла. Но на всякий случай смотрите в логи, искал ли агент ответ.

RSS: Новости на портале Anti-Malware.ru