



8,3 млн записей данных пользователей 123RF продаются на хакерском форуме

8,3 млн записей данных пользователей 123RF продаются на хакерском форуме

8,3 млн записей данных пользователей 123RF продаются на хакерском форуме

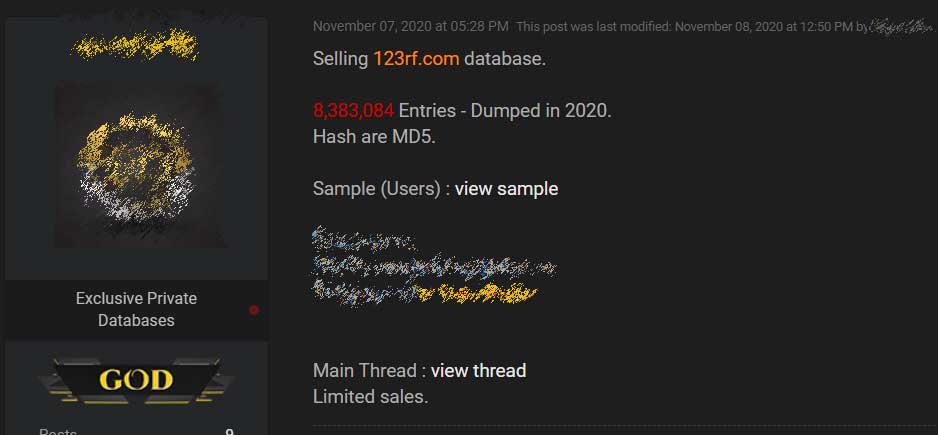
123RF, популярный сервис стоковых фотографий, стал жертвой крупной утечки данных. Неизвестный злоумышленник в настоящий момент продаёт на хакерском форуме базу пользовательских данных, насчитывающую 8,3 млн записей.

На площадке 123RF любой желающий может найти изображения, иллюстрации, видео- и аудиофайлы, которые можно использовать на веб-сайте. Согласно статистике SimilarWeb, 123RF принимает более 26 миллионов посетителей в месяц.

По словам киберпреступника, разместившего 8,3 млн записей пользовательских данных на одном из форумов, 123RF.com стал жертвой утечки.

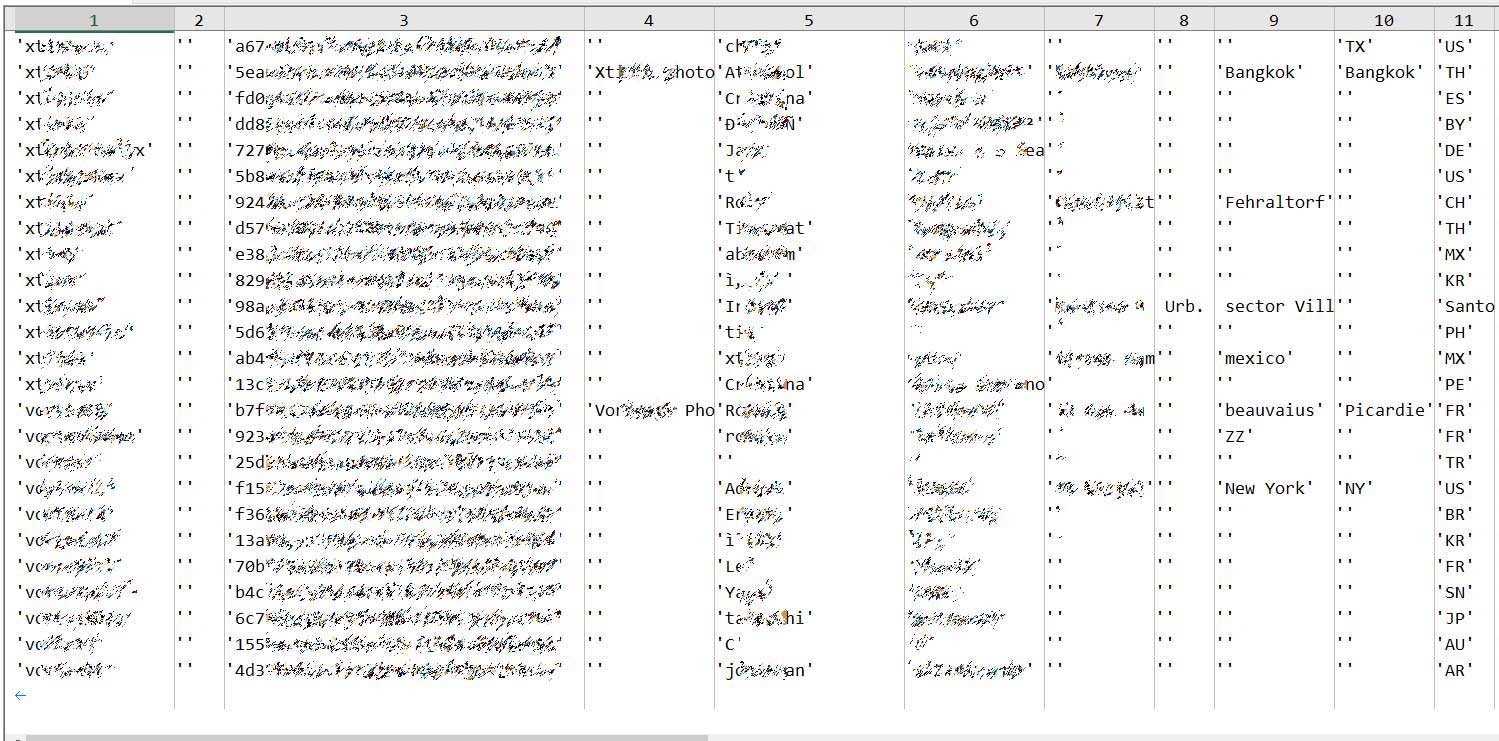
Из пробников БД удалось узнать, что в записях находятся полные имена пользователей, адреса электронной почты, захешированные MD5 пароли, имена организаций, физические адреса, привязанная к PayPal почта и IP-адреса.


Представители сервиса стоковых фотографий подтвердили факт утечки, уточнив, однако, что данные в базе, скорее всего, устарели. Специалисты проекта BleepingComputer по пробникам установили дату самой свежей информации — 27 октября 2019 года.


Хуже всего, что захешированные пароли можно легко перевести в простой текст, используя инструменты для взлома MD5.

Подпишитесь на новости

1,8 ТБ и вагон ошибок: как выгрузка с Яндекс Диска превратилась в квест

Пользователь «Яндекс Диска» решил сделать резервную копию 1,8 ТБ файлов, а также примерно 160 ГБ фотографий и получил приключение с ошибками API, зависшими загрузками и собственными скриптами.

По его словам, после октябрьских проблем с дата-центрами привычное скачивание папок через веб-интерфейс стало недоступно.

Подробности инженер Сергей Терёхин, известный как KenGuru66, описал  в собственном разборе на Хабре.

План был такой: rclone, сервер в Нидерландах, копия в Google Drive. Но стандартная аутентификация позволяла получить сведения о диске, а обращения к файлам возвращали ошибку 410. Доступ удалось наладить с другим OAuth-токеном.

Фотографии из безлимитной автозагрузки добавили веселья: для копирования через выбранный API их пришлось переместить в обычную папку. После этого они начали занимать место в тарифе. Более 30 тысяч снимков переносились около шести часов.

В выборке из 300 случайных файлов автор смог получить начало только 146. По важной папке с документами он скопировал и проверил по MD5 2315 файлов; ещё 3079 на момент публикации оставались недоступны.

Потерю данных автор не утверждает, он продолжает повторные загрузки. Скрипты опубликованы на GitHub.

RSS: Новости на портале Anti-Malware.ru