



Пользователи Twitter снова могут скачать архив со своим данными

Пользователи Twitter снова могут скачать архив со своим данными

Пользователи Twitter снова могут скачать архив со своим данными

Twitter снова разрешил скачивать архивы с пользовательскими данными, теперь можно просмотреть, к какой информации могли получить доступ киберпреступники. Напомним, что ранее социальная площадка отключала эту функции в связи с крупнейшим взломом в её истории.

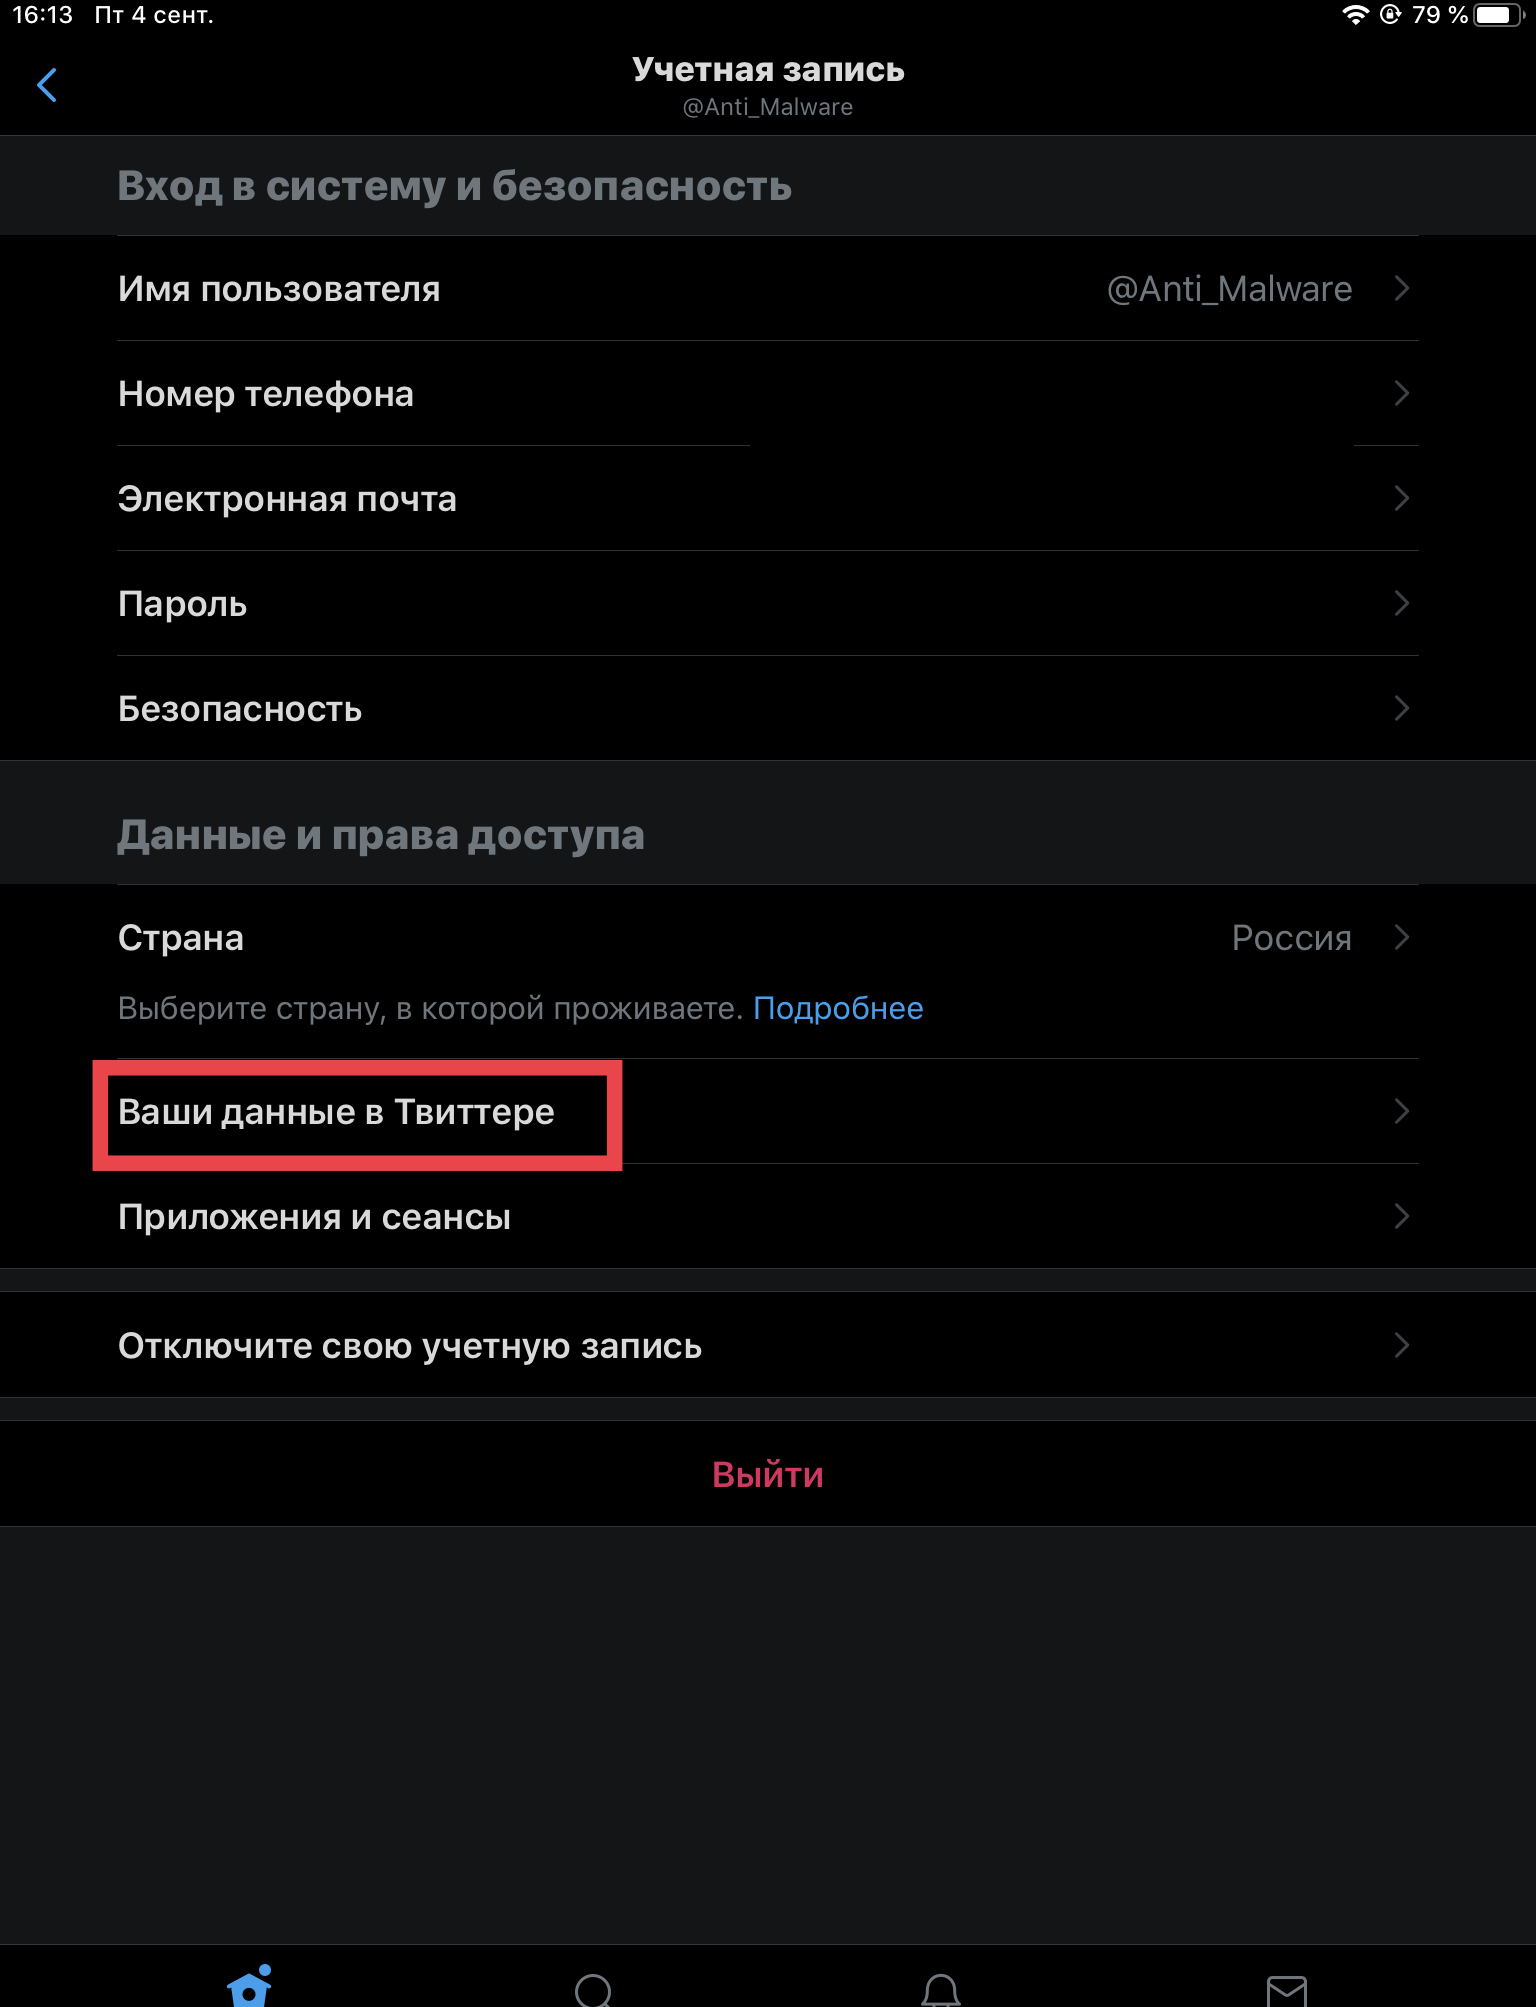
Найти эту опцию достаточно просто: зайдите в «Настройки» => «Учётная запись» => «Ваши данные в Твиттере».


После этого Twitter перенаправит вас на официальный сайт, где нужно ввести логин и пароль. После успешной аутентификации вы сможете получить данные вашего аккаунта. Для формирования соответствующего архива может потребоваться некоторое время. Иногда приходится ждать больше часа.

Если помните, в ходе «крупнейшего взлома в истории Twitter» киберпреступникам удалось получить доступ к подобным архивам с данными пользователей.

Теперь у нас есть возможность проверить, какого рода информация могла оказаться в руках злоумышленников.

Также напомним, что на днях задержали предполагаемого организатора взлома аккаунтов Twitter. Юноше, который якобы координировал всю операцию, оказалось всего 16 лет.

Подпишитесь на новости

1,8 ТБ и вагон ошибок: как выгрузка с Яндекс Диска превратилась в квест

Пользователь «Яндекс Диска» решил сделать резервную копию 1,8 ТБ файлов, а также примерно 160 ГБ фотографий и получил приключение с ошибками API, зависшими загрузками и собственными скриптами.

По его словам, после октябрьских проблем с дата-центрами привычное скачивание папок через веб-интерфейс стало недоступно.

Подробности инженер Сергей Терёхин, известный как KenGuru66, описал  в собственном разборе на Хабре.

План был такой: rclone, сервер в Нидерландах, копия в Google Drive. Но стандартная аутентификация позволяла получить сведения о диске, а обращения к файлам возвращали ошибку 410. Доступ удалось наладить с другим OAuth-токеном.

Фотографии из безлимитной автозагрузки добавили веселья: для копирования через выбранный API их пришлось переместить в обычную папку. После этого они начали занимать место в тарифе. Более 30 тысяч снимков переносились около шести часов.

В выборке из 300 случайных файлов автор смог получить начало только 146. По важной папке с документами он скопировал и проверил по MD5 2315 файлов; ещё 3079 на момент публикации оставались недоступны.

Потерю данных автор не утверждает, он продолжает повторные загрузки. Скрипты опубликованы на GitHub.

RSS: Новости на портале Anti-Malware.ru