



Эксперты нашли более быстрый и точный способ взлома текстовых CAPTCHA

Эксперты нашли более быстрый и точный способ взлома текстовых CAPTCHA

Эксперты нашли более быстрый и точный способ взлома текстовых CAPTCHA

Научные работники из Британии и Китая разработали новый алгоритм машинного обучения, который способен взломать текстовые версии CAPTCHA гораздо быстрее и более точно, нежели все известные до этого времени методы.

В разработке принимали участие специалисты Ланкастерского университета, китайского университета Northwest и Пекинского университета.

Специалисты сообщают, что новый алгоритм основан на генеративно-состязательной сети (Generative adversarial network, сокращённо GAN), что подразумевает комбинацию из двух нейронных сетей, одна из которых (сеть G) генерирует образцы,а другая (сеть D) старается отличить правильные («подлинные») образцы от неправильных.

У GAN имеется существенное преимущество перед другими алгоритмами — ему требуется куда меньший стартовый набор данных. Этого удается достичь благодаря так называемому «генеративному» (или производственному) компоненту, который производит похожие образцы данных.

По результативности такой подход можно сравнить с тем, как если бы алгоритм обучали с помощью миллионов данных.

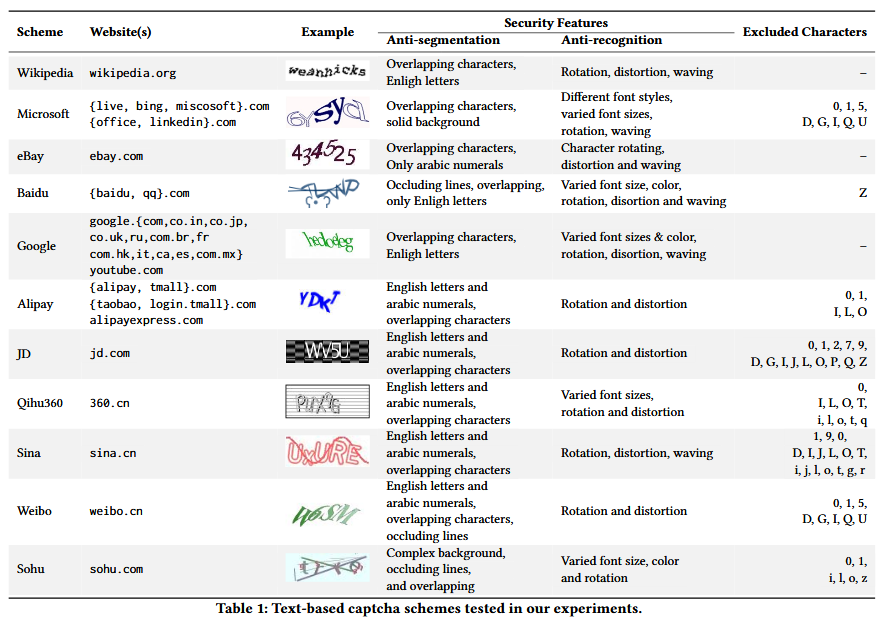
В итоге специалисты применили этот метод для взлома текстовых CAPTCHA. В ходе своей работы эксперты использовали лишь 500 текстовых «капч», принадлежащих 11 отдельным сервисам, которые используют на своих площадках 32 сайта из списка 50 топовых сайтов по версии Alexa.

Ученые тренировались на текстовых CAPTCHA, которые установлены на таких популярных ресурсах, как Wikipedia, Microsoft, eBay, Baidu, Google, Alipay, JD, Qihoo360, Sina, Weibo и Sohu.

С полным текстом исследования можно ознакомиться в документе «Yet Another Text Captcha Solver: A Generative Adversarial Network Based Approach» (PDF).

У CrowdSec украли код примерно 300 репозиториев через атаку на TanStack

Французская ИБ-компания CrowdSec подтвердила утечку исходного кода из GitHub. Злоумышленники добрались примерно до 300 репозиториев, около 170 из которых были закрытыми.

В официальном заявлении CrowdSec уточняется, что инцидент произошёл ещё в мае 2026 года, однако компания узнала о нём только 16 сентября.

В похищенный массив вошёл код SaaS-консоли, некоторых процедур для AWS, коннекторов и средств автоматизации. Остальные более 130 репозиториев содержали открытый код, который и так был публично доступен.

Предполагаемым входным билетом стала атака на цепочку поставок TanStack. В мае CrowdSec использовала скомпрометированный компонент, который, вероятно, вытащил API-ключ с правами на чтение закрытой кодовой базы.

Компания утверждает, что клиентские данные, имена, пароли и сведения об организациях в утечку не попали. Специалисты также не обнаружили токенов или других секретов, которые позволили бы атакующим двигаться по инфраструктуре дальше. Тем не менее все потенциально затронутые ключи и учётные данные CrowdSec сразу заменила.

В корпорации считают, что украденный код сложно применить за пределами её инфраструктуры: он тесно связан с внутренними данными и инструментами CrowdSec, а значительная часть компонентов за прошедшие четыре месяца уже изменилась. Код SaaS-сервиса также регулярно проходил аудит, поэтому непосредственной угрозы разработчики пока не видят.

Расследование продолжается, а CrowdSec обещает следить за подозрительной активностью.

RSS: Новости на портале Anti-Malware.ru