



Почти 200 000 сайтов по-прежнему уязвимы перед проблемой Heartbleed

Почти 200 000 сайтов по-прежнему уязвимы перед проблемой Heartbleed

Почти 200 000 сайтов по-прежнему уязвимы перед проблемой Heartbleed

Уязвимость Heartbleed (CVE-2014-0160), выявлена в популярной криптографической библиотеке OpenSSL еще в 2014 году. Основная проблема связана с отсутствием необходимой проверки границ в одной из процедур расширения Heartbeat (RFC6520) для протокола TLS/DTLS.

Из-за этой маленькой ошибки кто угодно может получить доступ к оперативной памяти машин, чьи коммуникации «защищены» уязвимой версией OpenSSL. В том числе, злоумышленник получает доступ к секретным ключам, именам и паролям пользователей и всему контенту, который должен передаваться в зашифрованном виде. При этом не остается никаких следов проникновения в систему, сообщает xakep.ru.

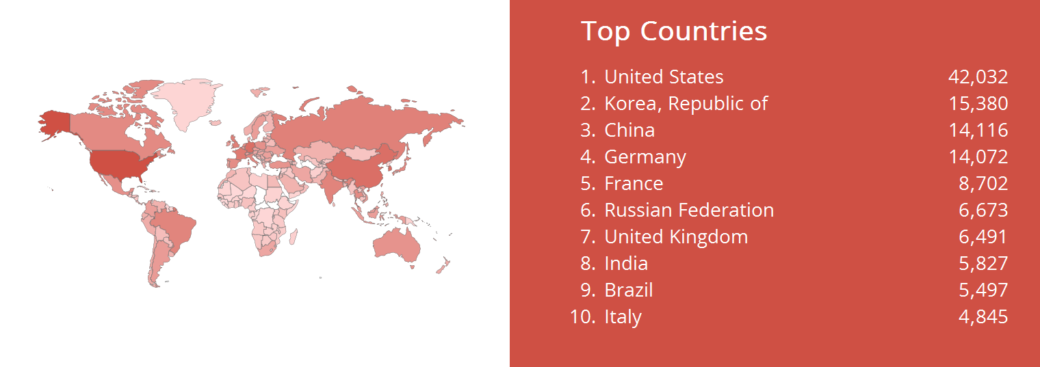
23 января 2017 года глава и основатель Shodan Джон Мазерли (John Matherly) представил свежий отчет о проблеме Heartbleed. Оказалось, что спустя почти три года уязвимость все еще представляет опасность для 199 594 сайтов, чьи администраторы, видимо, очень не любят устанавливать обновления. Подробную статистику по странам можно увидеть ниже.


Мазерли пишет, что около 75 000 уязвимых систем также используют истекшие SSL-сертификаты и работают на Linux 3.x.

Нежелание пользователей и администраторов обновлять ПО, остается одной из главных проблем, наряду с неугасающей любовью к паролю «123456». Совсем не удивительно, что в прошлом году специалисты Microsoft назвали самой опасной угрозой Stuxnet, хотя патч для этой проблемы был выпущен шесть лет тому назад. Еще одно доказательство беспечности пользователей – отчет специалистов Sophos, тоже представленный в прошлом году. Исследователи выявили, что эксплоиты для Office 2003, 2007 и 2010 по-прежнему занимают лидирующие позиции во всех топовых эксплоит-китах. Тогда авторы отчета писали, что сложившаяся ситуация напоминает им современный вариант дарвиновского труда «Происхождение видов».

Подпишитесь на новости

Google поддержит единый запрет на обучение ИИ через robots.txt

Владельцам сайтов обещают упростить отказ от использования их материалов для обучения нейросетей. Google поддержит общий механизм в robots.txt: вместо отдельных инструкций каждому ИИ-провайдеру можно будет задать единую настройку для участников инициативы.

О планах компания сообщила в блоге Search Central. Поддержку механизма намерены запустить в 2027 году.

В основе лежат разработки рабочей группы AIPREF при IETF. В robots.txt появится общий маркер политики, который позволит обозначить предпочтения сайта относительно обучения ИИ.

Google планирует трактовать запрет через такой маркер аналогично запрету Google-Extended, если отдельная инструкция для него не задана. При этом существующие настройки для конкретных компаний сохранятся: можно будет установить общее правило и отдельно уточнить условия для отдельных провайдеров.

Для издателей это потенциально меньше возни с растущим списком ИИ-ботов. Но универсального технического щита здесь нет: robots.txt сообщает правила использования контента, а не перекрывает доступ к серверу. Эффект зависит от того, какие компании поддержат механизм и будут соблюдать инструкции.

Инициатива пока остаётся предложением, которое продолжат дорабатывать и стандартизировать.

RSS: Новости на портале Anti-Malware.ru