


Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Группа исследователей из Университета Техаса и Университета Пердью предложила необычную идею: большие языковые модели (LLM), вроде ChatGPT, могут «тупить» от некачественных данных примерно так же, как люди — от бесконечных часов в соцсетях.

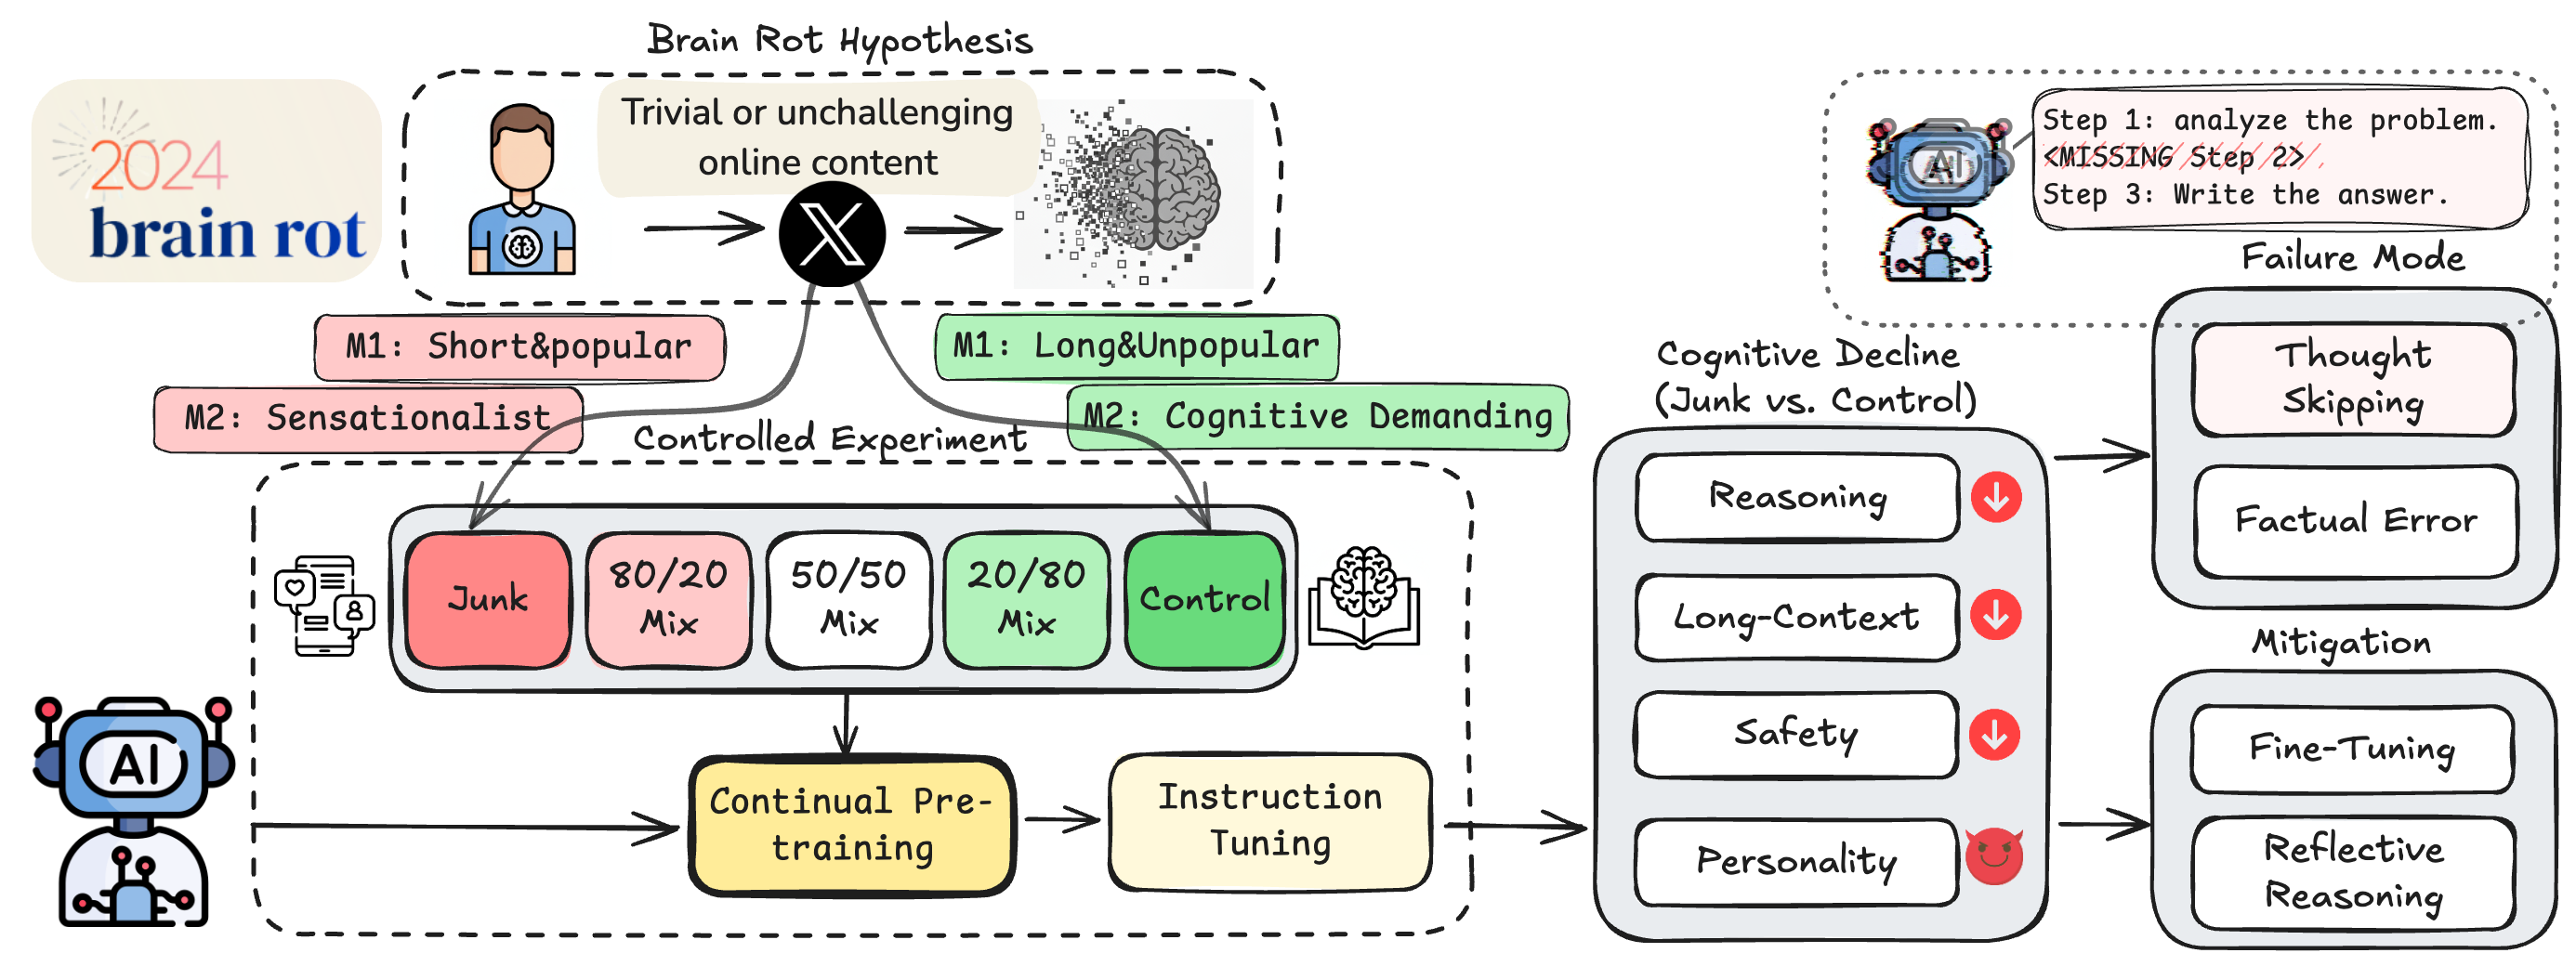
В отчёте специалисты выдвигают «гипотезу гниения мозга LLM». Суть проста: если продолжать дообучать языковую модель на «мусорных» текстах из интернета, она со временем начнёт деградировать — хуже запоминать, терять логику и способность к рассуждению.

Авторы понимают, что отличить хороший контент от плохого сложно. Поэтому они решили изучить 100 миллионов твитов с HuggingFace и отобрать те, что подходят под определение «junk».

В первую группу попали короткие твиты с большим количеством лайков и репостов — те самые, которые вызывают максимальное вовлечение, но несут минимум смысла. Во вторую — посты с «низкой семантической ценностью»: поверхностные темы, кликбейт, громкие заявления, конспирология и прочие «триггерные» темы.


Чтобы проверить качество отбора, результаты GPT-4o сверили с оценками трёх аспирантов — совпадение составило 76%.

Учёные обучили четыре разные языковые модели, комбинируя «мусорные» и «качественные» данные в разных пропорциях. Потом прогнали их через тесты:

  • ARC — на логическое рассуждение,
  • RULER — на память и работу с длинным контекстом,
  • HH-RLHF и AdvBench — на этические нормы,
  • TRAIT — на анализ «личностного стиля».

Результаты оказались любопытными: чем больше в обучающем наборе было «интернет-мусора», тем хуже модель справлялась с задачами на рассуждение и память. Однако влияние на «этичность» и «черты личности» было неоднозначным: например, модель Llama-8B с 50% «мусора» даже показала лучшие результаты по «открытости» и «низкой тревожности».

Исследователи сделали вывод: переизбыток интернет-контента может привести к деградации моделей и призвали разработчиков тщательнее отбирать данные для обучения. Особенно сейчас, когда всё больше онлайн-текста создаётся уже самими ИИ — и это может ускорить эффект так называемого model collapse, когда модели начинают обучаться на собственных ошибках.

Учёные шутят: если так пойдёт и дальше, возможно, придётся вернуться к книгам — хотя бы ради того, чтобы «накормить» модели чем-то действительно качественным.

Подпишитесь на новости

Наталья Касперская поставила под сомнение доверие к генеративному ИИ

Генеративный ИИ умеет писать тексты и код, но можно ли на него полагаться? Наталья Касперская считает, что с доверием к таким системам пока больше вопросов, чем ответов. В интервью корреспонденту Anti-Malware.ru Олесе Афанасьевой на BIS Summit она назвала критерий доверенности применительно к генеративному ИИ загадкой.

По объяснению Касперской, доверенная система должна работать с заранее заданными параметрами и обеспечивать предсказуемый результат.

Генеративный ИИ, по её оценке, под это определение не подпадает: он не способен каждый раз выдавать один и тот же результат.

«Критерий доверенности в применении к генеративному искусственному интеллекту для меня является загадкой», — заявила она.

Главная проблема, считает Касперская, — масштаб моделей. Огромное количество параметров и данных делает полноценную проверку такой системы практически недостижимой. Можно протестировать отдельные ответы и сценарии, но это ещё не доказывает надёжность всей модели.

«Вы можете сделать какие-то выборочные проверки, частичные. Они будут выборочными и частичными, они ничего не докажут», — подчеркнула Касперская.

Получается неудобный вопрос для бизнеса и государства: как доверять системе, поведение которой нельзя исчерпывающе проверить? По словам председателя правления АРПП «Отечественный софт», задача создания доверенного ИИ поставлена, но готового способа её решения она пока не видит.

Одними разговорами, считает Касперская, проблему не закрыть. Нужна совместная работа специалистов по ИИ и информационной безопасности, методистов и разработчиков стандартов.

RSS: Новости на портале Anti-Malware.ru