


Объём похищенных данных в 2025 вырос до 687 ТБ при 406 утечках

Объём похищенных данных в 2025 вырос до 687 ТБ при 406 утечках

Объём похищенных данных в 2025 вырос до 687 ТБ при 406 утечках

В первой половине 2025 года сообщений об утечках баз данных российских компаний стало меньше — их зафиксировали 406, что на 11% ниже, чем годом ранее. При этом в открытый доступ попала только половина украденных данных, а общее количество опубликованных строк снизилось более чем в два раза. Такие данные приводит центр мониторинга внешних цифровых угроз Solar AURA (ГК «Солар»).

С января по июнь эксперты зафиксировали 289 млн утекших строк данных против 626 млн за тот же период 2024 года.

Среди опубликованных — 54 млн имейл-адресов и 85 млн телефонных номеров. При этом общий объем похищенных баз оказался рекордным — 687 терабайт против 3,5 терабайт годом ранее. То есть по «весу» утечек рост составил почти 200 раз. В среднем Solar AURA отмечает от двух до пяти сообщений об утечках в Рунете ежедневно.

В компании отмечают, что статистика может быть обманчива: даже одна крупная утечка способна сильно изменить картину. Поэтому снижение количества сообщений не означает, что хакеры стали атаковать реже — наоборот, интенсивность атак только растет.


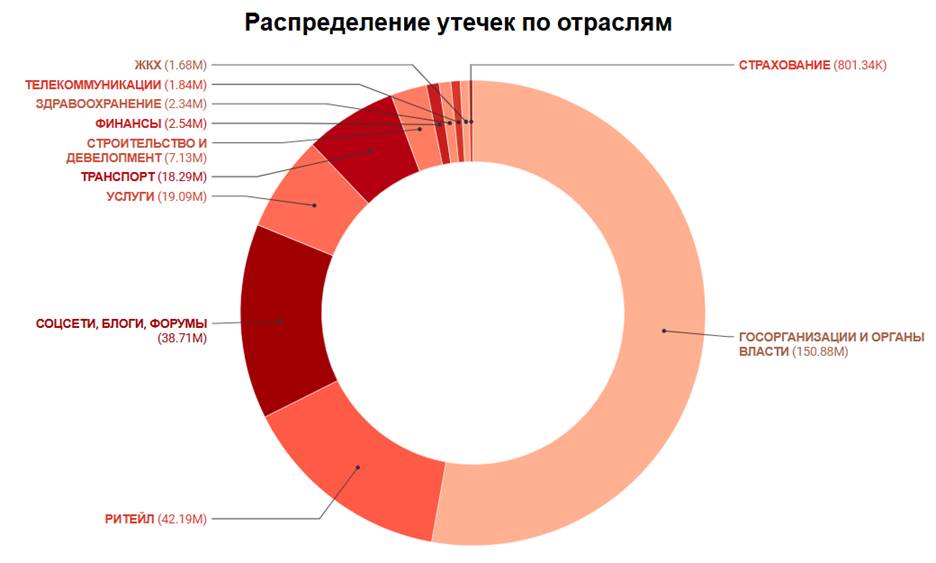
Если в 2024 году лидером по числу утекших строк была финансовая отрасль, то в 2025-м в первую половину года вперед вышел госсектор. Это связывают с политической ситуацией и возросшим интересом атакующих. Но есть нюанс: часть громких «госутечек» оказалась старым набором данных, собранным из разных источников за последние годы и выданным за новые.

Эксперты подчеркивают, что злоумышленники используют тему утечек не только ради киберпреступлений, но и как инструмент информационного давления. Поэтому важно не только защищать инфраструктуру, но и внимательно проверять каждое сообщение о «новой» базе в сети — иначе хакеры могут успешно играть на панике и подрыве доверия.

Подпишитесь на новости

Производители ТВ признали, что полностью отключить сбор данных нельзя

Издание The Verge задало производителям телевизоров и ТВ-приставок 17 вопросов о том, какие данные они собирают о пользователях. Из 11 компаний ответили семь: Amazon, Apple, Google, LG, Roku, Samsung и TCL. Panasonic, Sony и Vizio отвечать не стали, с Hisense связаться не удалось. Apple ответила лишь на часть вопросов.

Ответы компаний опубликовала The Verge. Главной темой стало автоматическое распознавание контента (ACR).

Эта технология определяет, что смотрит человек, и используется в том числе для показа рекламы и подсчета аудитории. У Samsung, LG и Amazon ACR по умолчанию выключен.

Samsung утверждает, что после отключения функции удаляет собранные данные со своих серверов. LG распознает контент по звуковым отпечаткам, а при включенном ACR определяет местоположение по соседним сетям Wi-Fi. Расшифровки голосовых команд у LG могут храниться без шифрования.

Google при стандартной настройке сразу включает сбор диагностики, персональные рекомендации и рекламу. Google TV передает компании IP-адрес и данные о соседних сетях Wi-Fi, по которым можно определить местоположение. Apple заявила, что Apple TV 4K не использует ACR и не делает снимков экрана.

Amazon, Google, Samsung и Roku признали, что полностью отказаться от передачи данных нельзя. Если телевизор отключен от интернета, устройства Amazon, Google, Roku, Samsung и TCL сохраняют часть данных и отправляют их после подключения.

Исследование Северо-Восточного университета показало, что телевизоры Vizio продолжали отправлять данные и после отказа пользователя от сбора. В компании назвали это служебными данными. У Samsung и Roku поток данных после отказа сократился, но полностью не прекратился.

RSS: Новости на портале Anti-Malware.ru