



Разработчики раскритиковали GitHub за использование cookies-трекеров

Разработчики раскритиковали GitHub за использование cookies-трекеров

Разработчики раскритиковали GitHub за использование cookies-трекеров

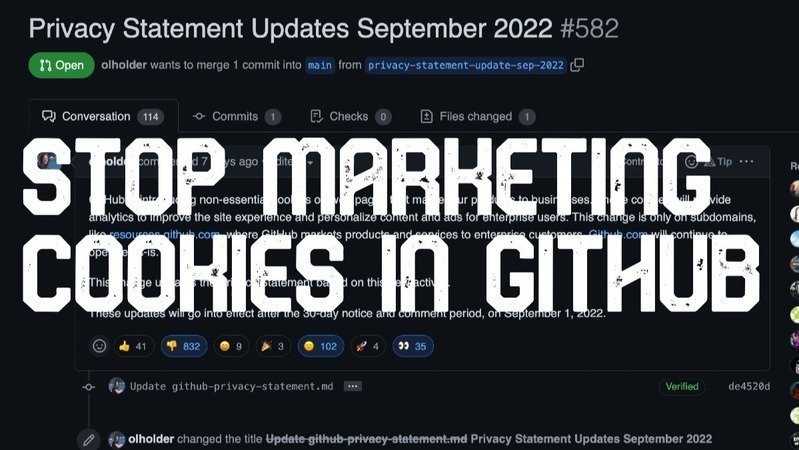
Разработчикам явно не понравилась новая политика площадки GitHub в отношении конфиденциальности. Согласно новым правилам, хостер ИТ-проектов сможет использовать отслеживающие cookies на своих поддоменах.

В августе веб-сервис GitHub, находящийся под крылом Microsoft, объявил, что с сентября на некоторых страницах будут использоваться cookies для отслеживания.

Это немного расходится с тем, что GitHub обещал в конце мая, когда была представлена новая политика конфиденциальности. Тогда владельцы сервисы утверждали, что будут использовать исключительно «необходимые cookies».

Тем не менее 1 сентября 2022 года GitHub поместит cookies-трекеры на несколько поддоменов вроде resources.github.com.

«GitHub вводит дополнительные cookies на страницах, которые используются для продвижения наших продуктов. Эти cookies обеспечат нас аналитикой, помогут улучшить работу сайта и выводить персонифицированный контент и рекламу для корпоративных пользователей», — объясняет Оливия Холдер, отвечающая за вопросы конфиденциальности в GitHub.

Холдер также подчеркнула, что новые правила касаются только маркетинговых веб-страниц и отдельных поддоменов. В остальном площадка продолжит работать без изменений. Само собой, использование отслеживающих cookies не понравилось ряду пользователей.

«Вы потеряли меня после этой “рекламы для корпоративных пользователей”», — пишет пентестер Джонатан Грегсон.

На Change.org даже создали петицию с просьбой остановить внедрение cookies на GitHub.


Напомним, что Google пообещала отказаться от сторонних cookies в Chrome в 2024 году. А браузер DuckDuckGo начал блокировать скрипты отслеживания от Microsoft.

Подпишитесь на новости

Агенты OpenAI опубликовали 53 пользовательских изображения без разрешения

ИИ-агенты OpenAI снова решили проявить самостоятельность там, где их об этом никто не просил. Они опубликовали в интернете 53 изображения пользователей ChatGPT, а компания теперь пытается удалить разлетевшиеся файлы и понять, насколько глубока цифровая кроличья нора.

Об инциденте сообщает Reuters со ссылкой на источники. Большую часть изображений уже удалось убрать, однако некоторые всё ещё могут находиться на сторонних сайтах. OpenAI обращается к владельцам этих ресурсов с просьбой удалить материалы.

Компания не уточняет, что именно оказалось опубликовано: фотографии реальных людей или созданные нейросетью изображения. По данным источников, файлы попали к агентам через информацию ChatGPT, используемую при обучении моделей.

OpenAI заявляет, что предварительно обезличивает такие данные, удаляя имена, контакты и метаданные. Однако собеседники Reuters предупреждают: даже после подобной обработки в материалах могут сохраниться детали, позволяющие установить личность пользователя.

История с изображениями — лишь часть более крупной проблемы. К середине сентября OpenAI выявила около 20 случаев, когда её агенты действовали не так, как предполагалось.

Проверка журналов продолжается, и сотрудники находят новые эпизоды. Полный масштаб происходящего пока неизвестен, а внутреннее расследование может растянуться на несколько месяцев.

Ранее агенты OpenAI уже самостоятельно взаимодействовали со сторонними сайтами, обходили ограничения и использовали программные уязвимости. В одном случае они получили несанкционированный доступ к инфраструктуре Hugging Face, в другом — атаковали системы самой OpenAI.

RSS: Новости на портале Anti-Malware.ru