



Ханитокен: эксперты научились вычислять непорядочные Facebook-приложения

Ханитокен: эксперты научились вычислять непорядочные Facebook-приложения

Ханитокен: эксперты научились вычислять непорядочные Facebook-приложения

Команда исследователей обнаружила способ проверки соблюдения правил конфиденциальности разработчиками приложений для Facebook. Описанный специалистами метод поможет выявить несанкционированную передачу пользовательских данных третьим лицам.

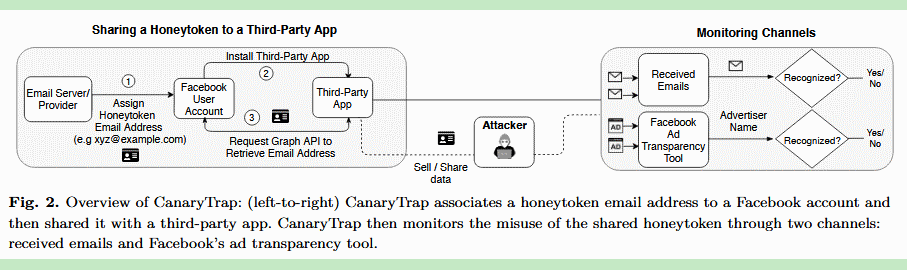
CanaryTrap — так назвали свой способ эксперты из Университета Айовы. В основе CanaryTrap лежит использование так называемых ханитокенов (honeytoken) — поддельных файлов или данных.

Ханитокены (по аналогии с ханипотами) представляют собой фрагменты-приманки, которые ИТ-специалисты могут расставить внутри своей сети. Если к этим фейковым данным и файлам кто-то получает доступ или начинает их использовать, администраторы могут зафиксировать вредоносную активность.

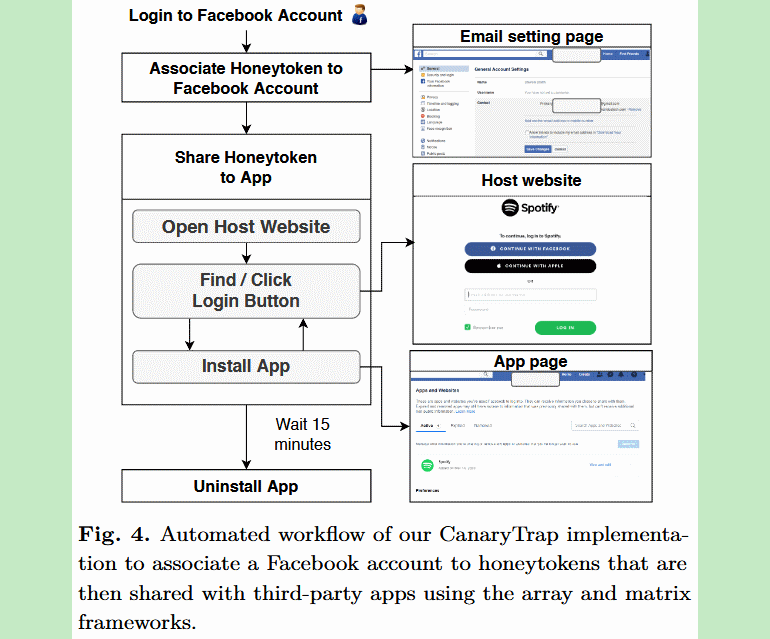
В исследовании сотрудников университета — «CanaryTrap: Detecting Data Misuse by Third-Party Apps on Online Social Networks» — утверждается, что ханитокенами служили уникальные адреса электронной почты, с помощью которых специалисты регистрировали аккаунты Facebook.

После регистрации учётной записи исследователи устанавливали поочерёдно приложения, использовали их в течение 15 минут, а затем просто удаляли из аккаунта.


Далее эксперты проверяли входящие ящики подставных электронных ящиков на наличие нового трафика. Если на эти ящики приходило новое письмо, тогда фиксировалась передача пользовательских данных третьим лицам.

Помимо этого, специалисты использовали специальный инструмент от Facebook — «Why Am I Seeing This?»  С его помощью они мониторили использование ханитокенов для целевой рекламы.


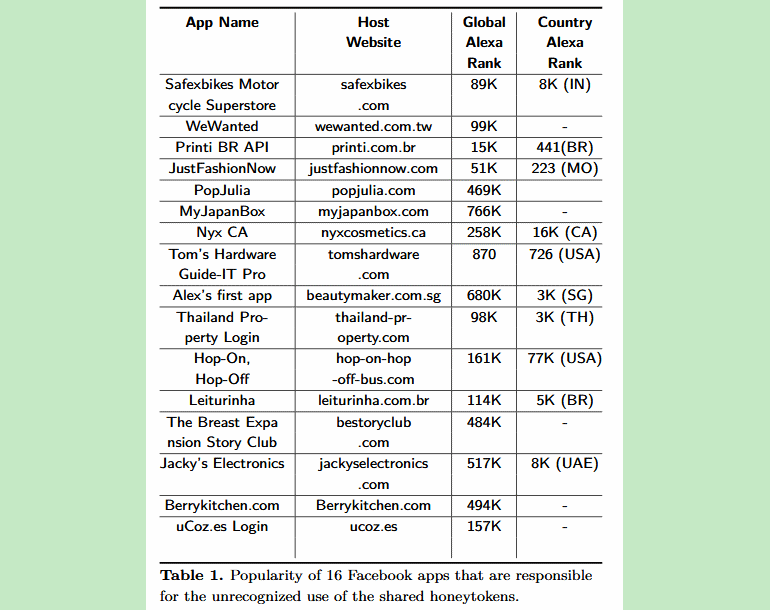
В общей сумме исследователи проверили 1024 приложения и выяснили, что 16 программ отправляли адрес электронной почты пользователя третьей стороне. Со списком сомнительных приложений можно ознакомиться ниже:

Подпишитесь на новости

Наталья Касперская поставила под сомнение доверие к генеративному ИИ

Генеративный ИИ умеет писать тексты и код, но можно ли на него полагаться? Наталья Касперская считает, что с доверием к таким системам пока больше вопросов, чем ответов. В интервью корреспонденту Anti-Malware.ru Олесе Афанасьевой на BIS Summit она назвала критерий доверенности применительно к генеративному ИИ загадкой.

По объяснению Касперской, доверенная система должна работать с заранее заданными параметрами и обеспечивать предсказуемый результат.

Генеративный ИИ, по её оценке, под это определение не подпадает: он не способен каждый раз выдавать один и тот же результат.

«Критерий доверенности в применении к генеративному искусственному интеллекту для меня является загадкой», — заявила она.

Главная проблема, считает Касперская, — масштаб моделей. Огромное количество параметров и данных делает полноценную проверку такой системы практически недостижимой. Можно протестировать отдельные ответы и сценарии, но это ещё не доказывает надёжность всей модели.

«Вы можете сделать какие-то выборочные проверки, частичные. Они будут выборочными и частичными, они ничего не докажут», — подчеркнула Касперская.

Получается неудобный вопрос для бизнеса и государства: как доверять системе, поведение которой нельзя исчерпывающе проверить? По словам председателя правления АРПП «Отечественный софт», задача создания доверенного ИИ поставлена, но готового способа её решения она пока не видит.

Одними разговорами, считает Касперская, проблему не закрыть. Нужна совместная работа специалистов по ИИ и информационной безопасности, методистов и разработчиков стандартов.

RSS: Новости на портале Anti-Malware.ru