



Машинное обучение позволяет обойти ReCAPTCHA

Машинное обучение позволяет обойти ReCAPTCHA

Машинное обучение позволяет обойти ReCAPTCHA

Исследователи из Колумбийского университета разработали автоматическую систему, которая успешно решает большинство каптч, предлагаемых сервисом Google reCAPTCHA. Такие каптчи используют тысячи сайтов, в том числе Google и Facebook.

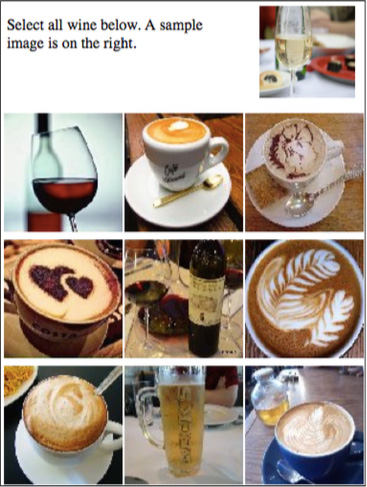
Речь идёт о преодолении относительно свежей разновидности каптчи, для решения которой нужно выбрать из предложенного списка картинки, удовлетворяющие тому или иному требованию — например, фотографии водоёмов или сосудов с вином.


hero-recaptcha-demo

recaptcha


Задача решается в два этапа. На первом этапе система получает куки, при помощи которых Google может следить за её поведением, а затем какое-то время ведёт себя максимально человекообразно: посещает различные сайты со случайным интервалом, соблюдает суточный цикл и т.д. Это нужно для того, чтобы Google не заподозрил в ней робота. Роботам он выдаёт более сложные каптчи.

На втором этапе она разбирает каптчу и пытается понять, что изображено на предъявленных картинках. Для этого система использует несколько методов. Во-первых, она обращается к обратному поиску по изображениям в Google Images. Если поисковику известна эта картинка, он сообщает соответствующий текстовый запрос. Во-вторых, система прогоняет её через несколько классификаторов, доступных в виде бесплатных веб-сервисов или библиотек. В-третьих, она проверяет, не знакома ли ей эта картинка. Картинки, которые часто повторяются в разных каптчах, разработчики описали вручную, пишет xakep.ru.

В итоге системе удаётся подобрать текстовые описания для каждой картинки. Трудность заключается в том, что найденные описания далеко не всегда совпадают с подсказкой. Эта проблема решена при помощи ещё одного классификатора, который пытается определить соответствие между словами в описаниях и текстом подсказки.

Систему протестировали на каптчах с сайтов Google и Facebook. Гугловские каптчи удалось обойти в 70,78 процентов случаев. Каптчи с Facebook оказались ещё проще. Система побеждала их в 83,5 процентах случаев. Среднее время решения каптчи составило 19,2 секунды.

Firefox 156 научился экономить ресурсы на тяжёлых JPEG

Mozilla выпустила Firefox 156 с оптимизацией обработки крупных JPEG-изображений. Браузер теперь расходует меньше оперативной памяти и процессорного времени, когда сайту нужно показать огромную фотографию в виде скромной картинки. Оптимизация касается изображений, которые перед отображением уменьшаются средствами страницы.

Обычно браузеру приходится сначала декодировать JPEG почти целиком, а затем масштабировать его до нужного размера.

На сайтах с фотогалереями, интернет-магазинах и новостных лентах таких файлов могут быть десятки, поэтому нагрузка быстро складывается в неприятную сумму.

Firefox 156 снижает затраты именно на этот сценарий. Mozilla не приводит единого процента ускорения или экономии памяти: результат будет зависеть от размера исходных файлов, количества изображений и параметров компьютера.

Второе заметное улучшение досталось встроенному просмотрщику PDF. По данным Mozilla, после оптимизации он может запускаться до 45% быстрее. Особенно заметным изменение должно стать при первом открытии документа, когда браузер загружает необходимые компоненты.

Обновление выходит 15 сентября для поддерживаемых настольных платформ. Проверить его наличие можно через меню Firefox: «Настройки» → «О Firefox». Браузер самостоятельно найдёт новую версию и предложит перезапуск.

RSS: Новости на портале Anti-Malware.ru