



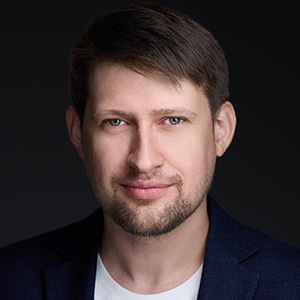
Александр Титов
Генеральный директор компании «Флант»
Стоял у истоков DevOps в России, принимал активное участие в создании профессионального сообщества, развивал DevOps-процессы в крупных международных технологических корпорациях Microsoft и Skype, построил собственный успешный бизнес — компанию «Экспресс 42».
С 2023 года — акционер и управляющий партнёр объединённой компании «Флант» и «Экспресс 42». В июле 2024 года назначен генеральным директором компании «Флант».
Безопасная разработка, доверенная инфраструктура и искусственный интеллект сегодня становятся не отдельными задачами, а частью единой технологической повестки. Системы усложняются, компании ищут баланс между регуляторикой, инженерной практикой и реальной устойчивостью к угрозам. Как именно — обсудили на ЦИПР–2026 с Александром Титовым, генеральным директором компании «Флант».
Многие обсуждают, что такое доверенная инфраструктура. Что вы вкладываете в это понятие?
А.Т.: Мы смотрим на доверенную инфраструктуру не как на продукт или какую-то сертификацию, не как на что-то осязаемое, что можно потрогать. Это скорее процесс. Информационные технологии (ИТ) в целом сейчас движутся в сторону того, чтобы проверки безопасности максимально сдвигать влево (концепция shift left). Важно, чтобы внутри всех процессов были встроены механизмы безопасности. Поэтому сейчас уже ИТ и информационная безопасность (ИБ) всё меньше существуют отдельно — это единый процесс, он должен работать как одно целое.
И, соответственно, доверенная инфраструктура — это инфраструктура, которая на всём процессе разработки и поставки программного обеспечения (ПО) обеспечивает прозрачность. То есть мы всегда понимаем с точки зрения безопасности, как работают практики, инструменты, что они дают, где может запуститься цепочка событий, которая приведёт к небезопасному сценарию. И такие риски нужно сразу уметь отсекать.
Ключевое понятие — это прозрачность?
А.Т.: Ключевых понятий три: прозрачность, контролируемость из одной точки и верифицируемость. То есть мы можем проверить, что, например, конкретный артефакт действительно был собран на определённом этапе процесса и передан дальше по инфраструктуре. И что это именно он, без подмены.
Потому что атака на цепочку поставок — это как раз история, когда злоумышленники используют слабые места процесса, чтобы незаметно встроить туда что-то лишнее. И таких атак становится всё больше. Их цель — незаметно вмешаться в цепочку поставки и использовать её как точку входа.
И вот доверенная инфраструктура — как раз про эти три принципа: прозрачность, контролируемость и верифицируемость.
Именно это отличает доверенную инфраструктуру от просто работающей по правилам и соблюдающей какие-то регламенты?
А.Т.: Да. Когда инфраструктура работает по правилам, искусственный интеллект (ИИ) как раз и становится фактором, который может эту систему кардинально изменить. Я разговаривал с ребятами из отдела ИБ: уязвимость можно упаковать так, что формальные правила её просто пропустят.
Поэтому важно на каждом этапе проверять не только результат, но и сам процесс. Он должен быть прозрачным, должна быть единая точка правды, чтобы как можно раньше заметить попытку манипуляции или обхода контроля.
Александр, а в какой момент компании понимают, что им уже недостаточно просто хорошо работающей инфраструктуры, а нужны компоненты доверия?
А.Т.: К сожалению, большинство компаний начинают понимать это только после первого взлома, который происходит именно по такому сценарию.
Другой путь — сложная разработка, большое число пайплайнов, например, когда есть гибрид внутренней и заказной разработки и понимание того, что безопасность нужно закладывать изначально.
Третий путь благодаря регулятору — сертификация и требования по ГОСТ РБПО, разработке безопасного программного обеспечения. ГОСТ описывает все процессы, которые должны быть выстроены для обеспечения упомянутых выше понятий доверенной инфраструктуры. И это действительно важный шаг. С 1 марта эти новые требования начали действовать.
Разработчики государственных информационных систем, ПО для объектов критической инфраструктуры и других подобных решений должны не просто соответствовать требованиям РБПО, а выпускать артефакты ПО в соответствии с требованиями ГОСТа. На мой взгляд, это хорошая инициатива со стороны регулятора. Она создаёт основу для перехода к доверенной инфраструктуре.
Если мы заговорили о регуляторе и ЗОКИИ (значимых объектах критической информационной инфраструктуры), то это выглядит как довольно зарегламентированная история. Но насколько в ней сегодня можно говорить о доверенности? Это работает на практике или остаётся на бумаге?
А.Т.: Если говорить о ЗОКИИ, то ПО, которое получает сертификат ФСТЭК России и входит в такую инфраструктуру, в целом можно считать доверенным. В рамках сертификации проводится проверка со стороны ФСТЭК России: подтверждается, что все компоненты были собраны в защищённом контуре, а необходимые процедуры контроля и проверки безопасности выполнены. Испытательный орган здесь выступает той самой независимой точкой, которая обеспечивает прозрачность, контролируемость и верифицируемость процесса. Внутри этой процедуры программное обеспечение может проверяться в течение полутора месяцев и более.
Однако вопросы могут возникать уже после сертификации, в отношении программного обеспечения, которое разрабатывается и затем используется внутри ЗОКИИ. Такое ПО проходит сертификацию и проверки на определённых этапах, но между ними остаются промежуточные поставки и обновления. Если процессы безопасной разработки не внедрены, именно эти промежуточные поставки могут стать уязвимым звеном. Формально сертифицированный продукт остаётся доверенным, но отдельные изменения между проверками требуют дополнительного контроля.
То есть основной разрыв — именно в ПО?
А.Т.: Да. Без доверенной инфраструктуры невозможно обеспечить безопасную поставку программного обеспечения. Это неотъемлемая часть всего процесса. Именно инфраструктурные решения должны гарантировать, что на каждом этапе у нас сохраняются верифицируемость, контролируемость и прозрачность.
В такой логике подход «разработка, безопасность и эксплуатация» (Development, Security and Operations, DevSecOps) выглядит практически идеальным решением. Но если всё действительно так просто, почему этот подход до сих пор не стал повсеместной практикой?
А.Т.: Собственно, ГОСТ РБПО — это и есть формализованное описание процессов DevSecOps в российских реалиях.
Тогда возникает логичный вопрос: если модель DevSecOps настолько эффективна, почему по ней до сих пор работают далеко не все?
А.Т.: Это сложная история. Так мало кто работал. Потому что это требует изменений сразу на нескольких уровнях: инструментальном, процессном и организационном. DevSecOps — это не просто про то, что разработка, безопасность и эксплуатация начинают работать вместе. Они и раньше взаимодействовали, чтобы обеспечивать безопасность. Суть в другом: они начинают смотреть на один и тот же процесс, но с разных сторон. И по-разному дёргают ручки, чтобы влиять на безопасность системы.
Если упростить, разработчики воспринимают безопасность в одном разрезе, эксплуатация — в другом. А команда безопасности здесь выступает как консультант и одновременно как драйвер, который помогает быстрее внедрять эти практики.
Оркестраторы, в общем.
А.Т.: Да. И здесь безопасность тоже не привыкла работать в таком режиме. Понятно, что проще запрещать и не пускать, чем объяснять, что в этом месте нужно делать иначе. Вот, например, система жёсткого мониторинга безопасности показывает потенциальную уязвимость. Дальше отделу информационной безопасности приходится говорить: «Ребята, давайте менять подход, чтобы на следующем шаге разорвать эту причинно-следственную цепочку».
Это требует другой управленческой практики. Здесь важна связка директора по информационной безопасности (Chief Information Security Officer, CISO) и ИТ-директора (Chief Information Officer, CIO) — это уже не только про технологии, но и про управление процессами, которое и специалистам по ИБ тоже нужно осваивать. Проблема в том, что к этому никто не привык. Разработчики не привыкли мыслить процессно: написал код на своём компьютере — работает, и хорошо. Эксплуатация тоже в своей логике: у разработчиков ничего не работает, всё приходится доделывать, и в итоге это всё падает на них.
И вот в этой парадигме внедрить новый процесс всегда сложно. Но мы постепенно движемся в эту сторону. Это непривычно, но, думаю, со временем станет нормальной практикой. Важно, что эта история не появляется из одного продукта или получения сертификата. Это комплексная задача, которая требует вовлечения руководства и изменения подхода на уровне всей организации.
Но ведь у большинства компаний действительно такая разрозненная инфраструктура. Как же сделать её абсолютно доверенной?
А.Т.: Разрозненность инфраструктуры — это отдельная проблема, вопрос фундамента. Мы можем говорить о том, что должны быть практики, должен меняться майндсет, но остаётся ещё базовый уровень: сама инфраструктура часто собрана из очень разных слоёв. Где-то это солома, где-то — железобетонный блок, стальная свая, и непонятно, как всё между собой согласуется. И это действительно часть проблемы.
Наша компания «Флант» как раз делает инфраструктуру на платформенных решениях Deckhouse, чтобы закрыть эти разрозненные куски процесса. Речь о единой инфраструктуре с единым control plane. Control plane — это слой управления всеми ресурсами инфраструктуры. Он управляет сетью, хранением данных, вычислительными нагрузками, приложениями и т. д. Это такой управляющий модуль, который координирует всю систему.
В классической инфраструктуре таких оркестраторов много: отдельно для виртуализации, отдельно для SDS, отдельно для SDN и т. п. И в этот момент как раз нарушается принципы прозрачности, контролируемости и верифицируемости. Мы предлагаем инфраструктуру с единым control plane, который становится единой точкой правды и обеспечивает эти три компонента. Фактически один движок управляет и данными, и сетью, и вычислительными ресурсами, и приложениями. Это и есть основа гибридной инфраструктуры, которая позволяет выстраивать доверенную среду и поддерживать безопасную разработку.
Когда мы говорим о гибридной модели, первый вопрос всегда один: про зону ответственности. Что берёт на себя единая платформа, а что остаётся на стороне заказчика?
А.Т.: Нет, единая платформа — у заказчика.
А если что-то произойдёт там?
А.Т.: Мы обеспечиваем базовые процессы: запуск нагрузок, конфигурацию сети и хранилищ, настройку взаимодействия между приложениями, сетевые политики, включая политики безопасности, которые применяются ко всей инфраструктуре. Например, если у нагрузки нет верифицированного артефакта в рамках РБПО, она просто не может быть запущена на платформе. И таких политик может быть довольно много. Это про чёткое понимание того, что происходит с инфраструктурой, про процессы запуска нагрузок, которые я уже перечислял, и про управление этим запуском с точки зрения политик.
Это как раз то, за что мы несём ответственность и передаём на сторону клиента: сама платформа и её механизмы управления. А дальше уже клиент вместе с интегратором отвечает за прикладную часть: за то, как именно решается его задача и как это исполняется на нашей платформе.
Если мы теперь сверху на всё это наложим ещё искусственный интеллект — что у нас получается?
А.Т.: Я уже говорил про ИИ с точки зрения рисков и того, чего стоит опасаться. Но сейчас можно посмотреть и с другой стороны: мы вооружили злоумышленников искусственным интеллектом, но одновременно и сами начали им активно пользоваться. И в этом смысле искусственный интеллект позволяет разбирать всю карту инфраструктуры, проводить мысленные эксперименты: как система будет вести себя при тех или иных нагрузках или в условиях атаки.
Например, наша платформа даёт полную картину того, что и как запущено. И с помощью больших языковых моделей (Large Language Model, LLM) можно выявлять нестандартные паттерны поведения: нагрузки, подключения — любые отклонения от привычной картины. Можно выгрузить состояние платформы и прогнать его через модель, чтобы она подсветила: вот здесь и здесь поведение отличается от того, что было, скажем, неделю назад. Это даёт дополнительные инсайты не только с точки зрения безопасности, но и в части управления инцидентами и других процессов.
Важно одно: должна быть единая точка правды, из которой можно собрать целостную картину. Если дать ИИ разрозненные данные без контекста, он начинает галлюцинировать, и возникает ощущение, что инструмент не работает. А при качественных данных, хорошем датасете и единой модели знаний, которую как раз может обеспечить платформа, ИИ начинает работать стабильно и давать практическую пользу.
Хорошей инфраструктуры не может быть без доверенного ИИ, в том числе.
А.Т.: Да, в том числе. Но, это отдельная проблема, которую надо уже на государственном уровне нам решать.
Мы поговорили о том, насколько это сложно и почему это важно. И в завершение хочется перейти к практике, к тому, с чего компании реально могут начать. Если у вас уже есть понимание, что двигаться в эту сторону нужно, но пока есть страх, то какие 3 вопроса стоит задать в первую очередь?
А.Т.: Первый вопрос, который стоит себе задать: отличается ли продакшн-окружение от среды разработки? Если отличается, это уже потенциальная проблема, в том числе с точки зрения атак на цепочку поставок. Это базовое требование ИБ, которое важно закрыть. Даже без внедрения сложных процессов критично обеспечить максимальную близость инфраструктуры разработки и продакшена.
Второй вопрос: насколько ваш процесс сдвинут влево? То есть на каком этапе вы начинаете понимать, что именно попадёт в продакшн. Если это происходит только на этапе передачи в эксплуатацию, то уже поздно. Тестирование и проверку важно начинать как можно раньше. Например, через NTM-тесты, которые проверяют не только функциональность, но и базовые аспекты безопасности. Это простой шаг, который не требует радикальной перестройки процессов, но уже даёт эффект.
И третий вопрос, он скорее про культуру: как взаимодействуют разработка, безопасность и эксплуатация? Если безопасность работает в логике «всё заблокировать и никого не пускать», это становится проблемой: мешает и разработке, и эксплуатации, и выстраиванию процессов в целом. Поэтому здесь ключевой вопрос к безопасности: готовы ли они менять этот подход и двигаться в сторону более партнёрской модели работы?
Александр, мы на ЦИПР–2026. Здесь можно встретить министров, руководителей ведомств, пообщаться напрямую. Если бы у вас была возможность задать один вопрос любому чиновнику, руководителю или ведомству, что бы это был за вопрос? Или, возможно, какая это была просьба? Открытый микрофон AM Live.
А.Т.: Наверное, это будет скорее просьба к уважаемому Михаилу Мишустину. Я был на пленарной сессии, мы как раз говорили про суверенный ИИ, о том, что он уже есть, работает и развивается. Но, к сожалению, мы как большая инженерная компания в том числе используем российские модели искусственного интеллекта и видим, что они пока заметно уступают.
Я об этом думал. У нас хватает и ресурсов, и талантов. Но сейчас есть нездоровая конкуренция крупных игроков внутри самой отрасли ИИ. Вместо этого, на мой взгляд, нужно больше коллаборации и объединения усилий. Потому что искусственный интеллект сегодня — это уже не просто технология, а общественно значимая история. Его базовое качество можно рассматривать как общественное благо. Мне кажется, наши китайские коллеги в этом смысле идут именно таким путём: развивают открытые модели, которые конкурируют на глобальном уровне.
И здесь, наверное, важно больше коллабораций. Потому что развитие ИИ зависит от двух ключевых ресурсов: вычислительных мощностей и талантов. И если их объединять, можно гораздо быстрее закрывать базовые технологические задачи. Поэтому, скорее, это просьба: рассмотреть возможность более тесной коллаборации.
Александр, спасибо большое за содержательное интервью. Всего вам самого безопасного!


