



К 2026 году нейросеть дома — уже не эксперимент от чудаковатых новаторов, а обыденность. Мы разобрали, какие модели работают на потребительском железе, сколько нужно памяти, какие инструменты упрощают старт и что выбрать под задачу. Без облаков, подписок и утечек данных.
- 1. Введение
- 2. Зачем запускать ИИ дома, если есть ChatGPT
- 3. Сколько памяти нужно: таблица VRAM и RAM
- 4. Модели 2026: что качать первым
- 5. Плюсы и минусы домашних нейросетей
- 6. Инструменты: чем запускать
- 7. Безопасность локальной нейросети
- 8. Пошаговый сценарий: первая модель за 10 минут
- 9. Выводы
Введение
Ещё два года назад локальный запуск LLM был уделом энтузиастов с серверными GPU. А попытки запустить нейросеть дома сопровождались системными ошибками и появлением раздражающего окна «Недостаточно места».
В 2026-м ситуация изменилась: опенсорсные модели догнали облачные по качеству на типовых задачах, потребительские видеокарты получили достаточно мощности, а инструменты вроде Ollama и LM Studio свели установку к незамысловатой команде или одному клику. При этом мотивы у всех разные: кто-то не хочет платить за подписки, кто-то не может отправлять рабочие документы в чужое облако, а кто-то просто мечтает о чат-боте, который работает без интернета.
Этот обзор — реально полезная навигация в мире локальных нейросетей. Разберёмся, что действительно запускается на домашнем железе в 2026 году, сколько памяти для этого потребуется и какие модели стоит скачать первыми. Не обойдём стороной и подводные камни, так называемую обратную сторону медали такого удовольствия.
Зачем запускать ИИ дома, если есть ChatGPT
Сразу обмолвимся о суровой, но честной реальности: заоблачных результатов от локальных нейросетей ждать не стоит (речь в том числе о ПК с большим объёмом видеопамяти и оперативной памяти). Домашние нейросети почти всегда будут уступать мощным облачным ИИ. На задачах вроде анализа большой архитектуры проекта, подготовки обзора судебной практики или решения длинной цепочки физических задач локальная модель может начать путаться и проседать.
Локальная модель может пропускать важные детали, придумывать несуществующие функции и формулировать ответы так, будто их несколько раз прогнали через переводчик. Впрочем, это ожидаемо и абсолютно нормально: домашний компьютер — не облачный кластер с тысячами ускорителей.
Тогда к чему все эти телодвижения и сложности?
Экспериментаторский дух, конечно, никто не отменял. Локальные модели могут дать возможность прощупать этот механизм работы ИИ изнутри. Если хочется разобраться, как модель генерирует ответы, сравнить разные уровни квантования или дообучить её под свои задачи — локальный запуск предоставит полную свободу действий. Но мы остановимся на более практических моментах, когда домашний ИИ может быть полезен.
Итак, во-первых, это приватность и контроль над данными. При локальной обработке запросы, документы и фрагменты кода могут оставаться на компьютере. Это особенно полезно, если нужно работать с внутренней документацией, личными файлами или исходным кодом проекта, который важно оставить в целости и сохранности. Правда, сам по себе локальный запуск не гарантирует полной приватности: стоит проверить настройки приложения, наличие телеметрии и подключений к внешним API. Если программа отправляет часть запросов в облако, данные могут покинуть устройство.
Во-вторых, экономия на подписках. Для тех, кто активно пользуется ИИ и не хочет вносить нейросеть в статью расходов, локальная модель может стать альтернативой платной подписке. Она подходит для регулярных задач: черновиков, писем, редактирования текстов, кратких пересказов, генерации идей и помощи с кодом. После установки модели не нужно платить за каждый запрос, если обработка действительно проходит локально и приложение не использует платные внешние сервисы.
Однако экономия не гарантирована: нельзя обойти вниманием стоимость компьютера или видеокарты, потребление электроэнергии и время на настройку. Для редких запросов облачный сервис может оказаться удобнее и дешевле.
Наконец, что немаловажно, работа без интернета. После загрузки модели и необходимых компонентов многие локальные инструменты работают офлайн. В самолёте, в глухой природе и в любой зоне вне сети вы не будете лишены доступа к информации. Можно редактировать тексты, задавать вопросы модели, обрабатывать локальные документы и получать помощь с программированием без постоянного подключения к облачному сервису. Когда все сидят на скачанных фильмах, вы можете невозмутимо продолжать повседневную работу — и это, конечно, неоспоримое преимущество локальных нейросетей.
Единственное ограничение в том, что сама модель не получает свежую информацию из интернета и не может обращаться к онлайн-сервисам без подключения. Для актуальных новостей, проверки новых фактов и поиска в сети потребуется отдельный источник данных.
Привлекательность практического применения таких моделей отмечают не только домашние пользователи. Компании также запускают локальные модели на своём сервере и подключают к SIEM. Так, в Kaspersky KUMA предусмотрена работа с внешними LLM, которые можно развернуть внутри инфраструктуры организации.
Сколько памяти нужно: таблица VRAM и RAM
Для предварительной оценки можно использовать ориентир 0,5–0,7 ГБ памяти на миллиард параметров при 4-битном квантовании (Q4). Дополнительно нужны ресурсы для контекста, обработки запросов и работы самого приложения.
Таблица 1. Требования к видеопамяти и оперативной памяти для запуска локальных нейросетей
|
Видеопамять (VRAM) |
Оперативная память (RAM) |
Примеры моделей |
Для каких задач подойдёт |
|
8 ГБ |
16—32 ГБ |
Qwen3-4B, Qwen3-8B, Gemma 3 4B |
Чат, работа с текстами, простые задачи программирования. Работа с изображениями — если её поддерживает выбранная модель |
|
16—32 ГБ |
32 ГБ |
Qwen3-14B, Gemma 3 12B, Gemma 4 12B |
Более сложные запросы, программирование, работа с документами |
|
24 ГБ |
32—64 ГБ |
Qwen3-30B-A3B в подходящем квантовании; некоторые модели около 27B в Q4 |
Более сложные задачи на домашнем ПК, если модель помещается в доступную память |
Что означают Q4, Q5 и Q8
Квантование уменьшает объём памяти, необходимый для хранения весов модели, за счёт представления чисел с меньшей точностью. Это позволяет запускать более крупные модели на обычном компьютере. Но у волшебной пилюли сжатия есть и побочный эффект: качество ответов может немного снижаться.
Таблица 2. Сравнение типов квантования нейросетей по расходу памяти и качеству ответов
|
Тип квантования |
Расход памяти |
Качество ответов |
Когда выбирать |
|
Q4 — 4 бита |
Низкий |
Возможны небольшие потери качества |
Когда важнее уместить модель в ограниченную память |
|
Q5 — 5 бит |
Средний |
Часто обеспечивает хороший баланс между размером и качеством |
Когда есть дополнительный запас памяти |
|
Q8 — 8 бит |
Высокий |
Обычно лучше сохраняет качество исходных весов, чем более агрессивное квантование |
Когда памяти достаточно и важна точность |
Чем выше разрядность квантования, тем больше памяти обычно требуется. При этом результат зависит от самой модели и способа квантования. Поэтому разницу в качестве нельзя выразить одним универсальным числом.
Почему «влезает в память» не значит «работает быстро»
Если веса модели не помещаются целиком в видеопамять, некоторые программы могут разместить их часть в оперативной памяти и выполнять часть вычислений на центральном процессоре. И, казалось бы, вы успешно запускаете модель на более слабом оборудовании, но побочное действие и здесь не заставляет себя долго ждать: обмен данными между RAM и видеокартой снижает скорость генерации.
На производительность также влияют длина контекста, скорость памяти и возможности процессора или видеокарты. Поэтому если модель поместилась в компьютер, поднимать знамя победы рано: важно учитывать не только размер, но и то, будут ли по зубам искусственному интеллекту ваши задачи.
Модели 2026: что качать первым
Выбор локальной нейросети зависит от возможностей компьютера. И, конечно, в первую очередь важно ответить на вопрос: для чего вам эта модель? Разумный ответ позволит не утруждать компьютер без надобности. Так, для переписки и редактирования текстов нет нужды скачивать модель на десятки миллиардов параметров.
Небольшая нейросеть может справляться с повседневными запросами и при этом быстрее работать на обычном ноутбуке. Более крупные модели пригодятся для сложных рассуждений, программирования и анализа объёмных документов, но и не забудут потребовать больше памяти.
Универсалы для повседневных задач
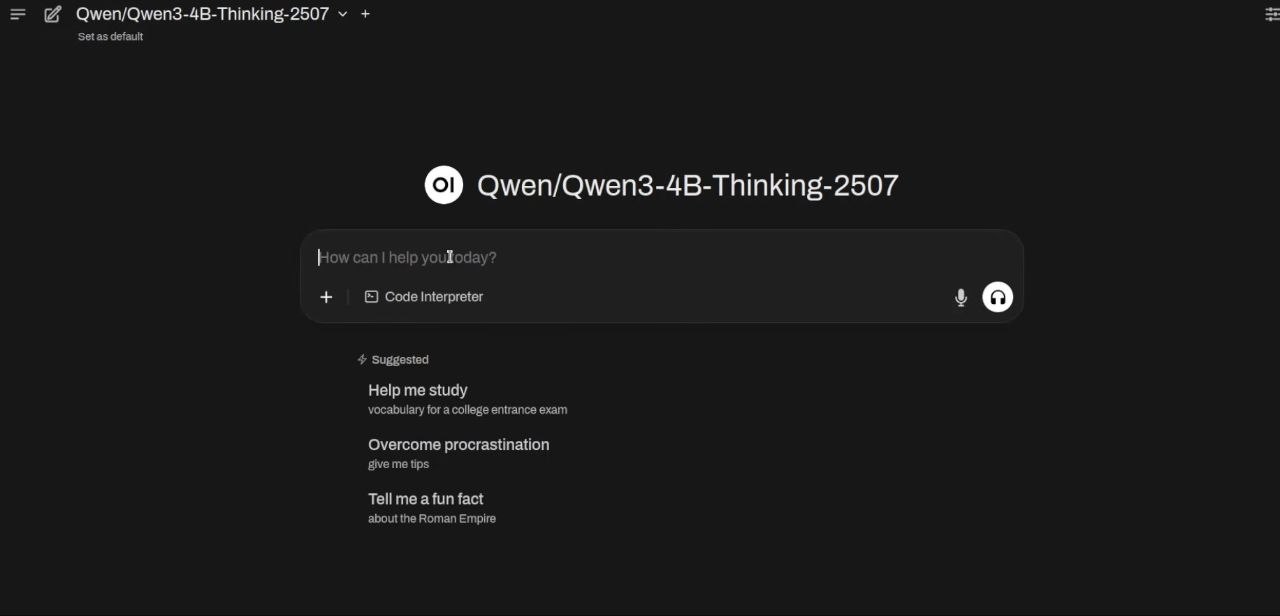
Qwen3-4B — хороший кандидат для первого знакомства с локальными нейросетями. Модель подходит для общения, подготовки черновиков, перевода, пересказа текста и несложных задач по программированию. У неё есть режимы с акцентом на рассуждения и на обычный диалог, поэтому можно выбирать между более подробным анализом и быстрыми ответами.
Рисунок 1. Qwen3-4B (источник: интерфейс модели)
Qwen3-8B стоит попробовать, если компьютер располагает дополнительной памятью. Модель может лучше справляться со сложными инструкциями и многоэтапными запросами. Впрочем, увеличение числа параметров само по себе не гарантирует более точный ответ. На компьютере с ограниченной видеопамятью она может работать медленнее, особенно при длинном контексте.
Для слабых компьютеров
Gemma 3 1B — если у ноутбука мало памяти или нет дискретной видеокарты. Это компактная модель для простых запросов и коротких текстов. От неё не стоит ждать уверенной работы со сложными рассуждениями или большими объёмами информации, зато — как логический бонус — она предъявляет более скромные требования к оборудованию.
Gemma 3 4B — следующий шаг, если ресурсов хватает. Модель подходит для повседневного общения, редактирования текстов и несложной помощи в работе. При этом нужно учитывать размер контекста и выбранное квантование.
Phi-4-mini с 3,8 млрд параметров можно рассматривать для логических задач, работы с текстом и программирования. Результаты сравнения Phi-4-mini и Gemma 3 4B зависят от типа запроса и языка, а не только от размера модели.
Для программирования
Qwen3-Coder — семейство моделей, ориентированных на задачи программирования. Они могут помогать писать функции, объяснять чужой код, искать возможные ошибки и предлагать варианты исправления.
Обязательно уточняйте версию модели: важно, чтобы она подходила для работы с нужным языком программирования. Перед установкой проверьте, сколько памяти нужно именно выбранной версии, подходит ли она для вашего языка программирования и запустится ли в вашей программе.
Для более сложных задач
Qwen3-14B или Gemma 3 12B. Эти модели продвинутого уровня подойдут для более сложных запросов, подготовки развёрнутых текстов, анализа документов и программирования. По сравнению с компактными моделями у них больше ресурсов для обработки сложных инструкций, но стоит оговориться: скорость зависит от оборудования и настроек.
Немаловажную роль здесь играет длина контекста. Большой объём информации требует больше памяти. Поэтому модель, которая запускается на коротких запросах, не обязательно будет столь же комфортно работать с объёмным документом.
Для мощного домашнего ПК
Qwen3-30B-A3B — вариант для тех, кто готов выделить под локальный ИИ значительную часть ресурсов компьютера. Это модель архитектуры «смесь экспертов» (Mixture of Experts, MoE): всего в ней около 30 млрд параметров, но при обработке каждого токена активируется лишь часть экспертов.
Такая модель может быть полезна для более сложных запросов и программирования, но не гарантирует превосходства над любой компактной нейросетью. Если компьютер не располагает достаточной памятью, разумнее начать с Qwen3-8B или Qwen3-14B и сравнить результаты на своих задачах.
Плюсы и минусы домашних нейросетей
Как мы уже успели заметить, домашний ИИ — палка о двух концах. Изобилует внушительными достоинствами, но и не лишён красноречивых недостатков.
Фёдор Минькин, технический директор GigaChat, отмечает, что такой расклад подходит тем, кто хочет обрабатывать личные документы, заметки и другие чувствительные данные на своём устройстве. Однако приватность зависит не только от самой модели, но и от того, подключены ли к приложению внешние API и другие сервисы.
Немаловажное преимущество — работа без интернета, а также независимость от облачных сервисов (экономия на подписках). Можно только оплачивать электричество и оборудование и быть на самообеспечении в самом прямом смысле слова.
А теперь перейдём к суровой стороне вопроса, в первую очередь — к «железу». Качество и многогранность домашней нейросети напрямую зависимы от ваших ресурсов. Чем крупнее модель и длиннее контекст, тем больше требуется VRAM и RAM. Поэтому при работе с локальными нейросетями будьте готовы к несовершенству: небольшие локальные модели могут хуже справляться со сложными рассуждениями, редкими фактами и специализированными задачами.
По словам Антона Мальцева, ML Lead в ArtSign и основателя RemiBrain, небольшие модели уступают крупным по возможностям, но их качества может хватать для конкретных задач. При этом крупным моделям нужны значительные объёмы памяти и быстрый доступ к ней.
Значительная сложность связана с настройкой и обслуживанием локального ИИ. Заманчивое на первый взгляд самообеспечение работает и в обратную сторону: придётся самостоятельно обновлять ПО, выбирать версии моделей и устранять возможные проблемы.
Наконец, локальный запуск не гарантирует безопасность данных сам по себе. Тема информационной безопасности — дело щепетильное. Локальная нейросеть сводит риск утечки данных к минимуму, но не гарантирует всецелой защищённости. Внешние интеграции, небезопасный интерфейс и сторонние расширения способны умалить преимущества локального запуска.
Инструменты: чем запускать
Если всё-таки плюсы локального ИИ взяли верх над минусами и вы решились на домашнюю нейросеть, то перейдём к самому насущному: с помощью каких инструментов запустить модель?
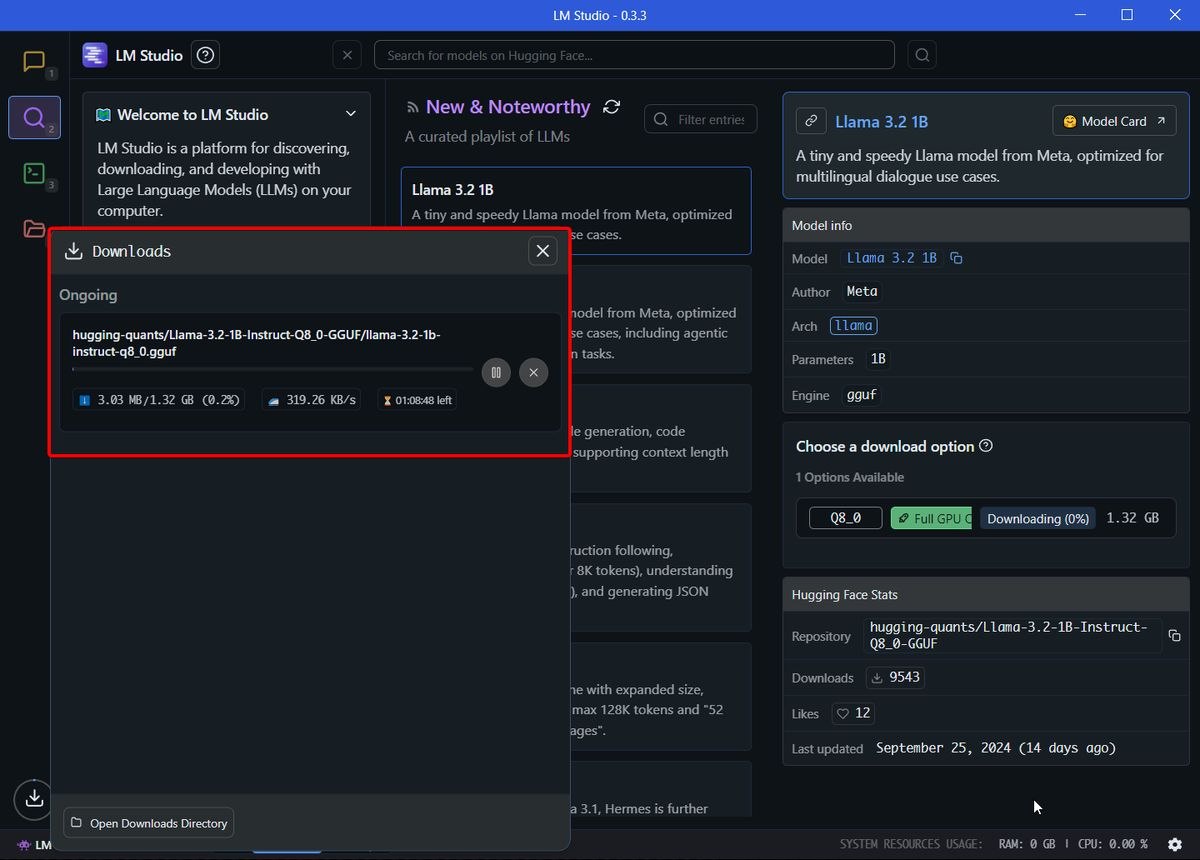
Рисунок 2. Запуск локальной нейросети (источник: lmstudio.ai)
- Ollama — простой способ запустить модель через командную строку. Подходит для быстрого старта, работы со скриптами и подключения моделей к другим приложениям.
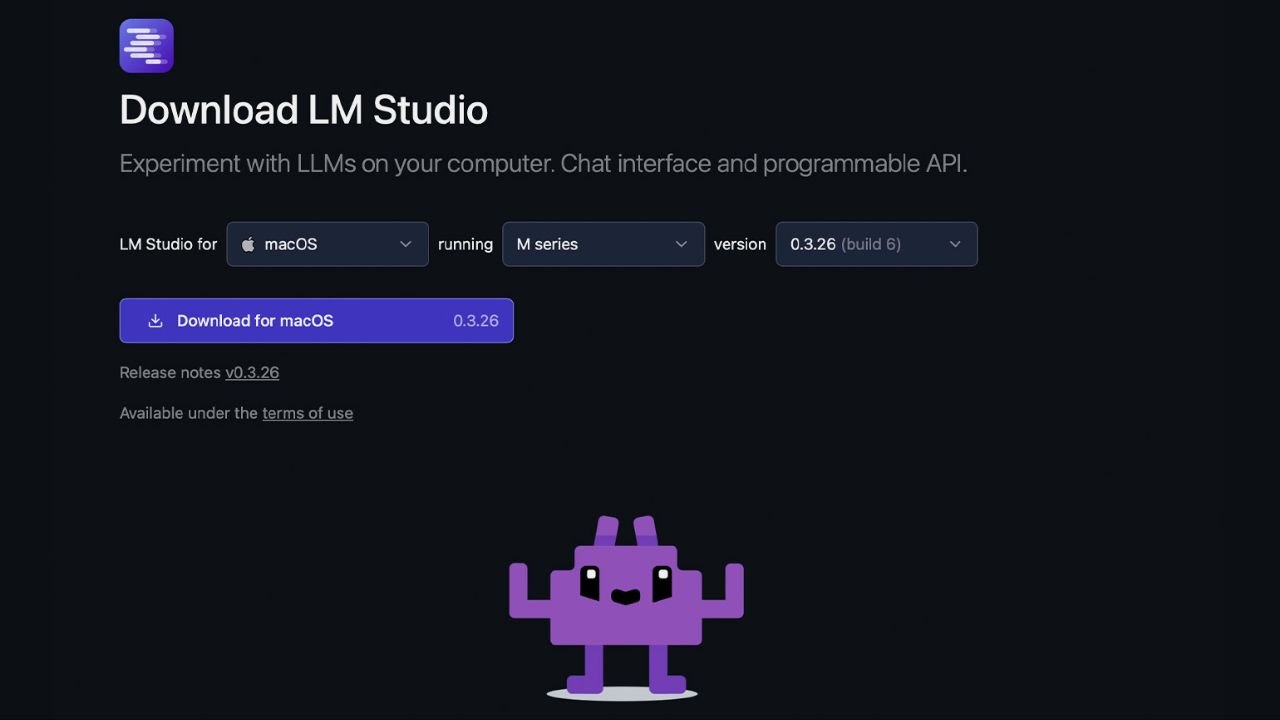
- LM Studio — приложение с графическим интерфейсом. Позволяет находить и загружать модели, выбирать подходящий вариант и общаться с ИИ без командной строки.
- llama.cpp — инструмент для тех, кому нужен более точный контроль над запуском. Поддерживает квантованные модели и работу на разном оборудовании, в том числе без мощной видеокарты.
- Llama Windows (ggml-org/Llama-Windows) — приложение для Windows 11 с вызовом чата по Alt+Space и возможностью загружать рекомендуемые модели из Hugging Face Hub.
Выбрать инструмент можно по своему опыту и задачам: для простого старта подойдут Ollama или LM Studio, а для более тонкой настройки — llama.cpp. Пользователям Windows также стоит обратить внимание на Llama Windows.
Безопасность локальной нейросети
Мы уже успели прийти к тому, что запуск домашней нейросети при всей относительной защищённости — не гарант стопроцентной сохранности данных. Поэтому «подстелить соломку» одним только отказом от облачных моделей не выйдет. Безопасность зависит от источника модели, настроек программы и прав доступа. Как всё-таки не попасться на крючок посягателям на чужие данные и максимально обезопасить пользование нейросетью? Следуйте советам:
- Проверяйте источник модели. Скачивайте модели из официальных репозиториев разработчиков или проверенных каталогов. Перед загрузкой изучите лицензию, а неизвестные файлы и сторонние сборки не запускайте без проверки.
- Контролируйте сетевые подключения. Локальная модель не обязательно работает полностью автономно. Проверьте, обращается ли приложение к внешним API, передаёт ли телеметрию и синхронизирует ли данные с облаком.
- Защитите доступ к интерфейсу. Не открывайте локальный сервер для доступа из интернета без необходимости. Если доступ извне нужен, настройте аутентификацию и ограничьте круг подключений.
- Ограничивайте права инструментов и плагинов. Если нейросеть может читать файлы, запускать команды или обращаться к внешним сервисам, предоставляйте ей только необходимые разрешения. Не передавайте модели административные права без веской причины.
- Проверяйте хранение истории. Запросы, журналы и загруженные документы могут сохраняться на компьютере. Узнайте, где они хранятся, и не вставляйте в запросы пароли, секретные ключи и другие данные, которые не нужны для выполнения задачи.
- Обновляйте программу и её компоненты. Устанавливайте обновления приложения и используемых библиотек из проверенных источников. Обновление самой модели не заменяет обновление программы, в которой она работает.
Александр Лысенко, ведущий эксперт по безопасности разработки и ИИ компании «К2 Кибербезопасность», обращает внимание на риск, связанный с чрезмерными правами ИИ-систем. При быстром внедрении технологии разработчики и пользователи могут не оценить, к каким данным и операциям получает доступ модель.
Пошаговый сценарий: первая модель за 10 минут
Если после прочтения всех за и против ваш дух оказался не сломлен, а желание пользоваться домашним ИИ осталось непоколебимым, то следующий шаг — это установка. Запустить модель можно без специальных технических знаний, и вот пошаговая инструкция:
- Проверьте свободную память (VRAM + RAM) и посмотрите, сколько места осталось на диске. Модель должна поместиться в доступную память с учётом контекста и потребностей самой программы.
- Скачайте Ollama или LM Studio с официального сайта.
- Выберите модель по таблице памяти:
Для 8 ГБ VRAM — начните с Qwen3-4B или Gemma 3 4B; Qwen3-8B рассмотрите в подходящем квантовании и с учётом длины контекста. Для 16 ГБ VRAM — рассмотрите Qwen3-14B, Gemma 3 12B или Gemma 4 12B после проверки требований выбранной версии. Для 24 ГБ VRAM — рассмотрите Qwen3-30B-A3B в подходящем квантовании, предварительно проверив потребление памяти.
- Запустите и проверьте скорость.
В LM Studio загрузите выбранную модель, откройте чат и задайте простой вопрос. В Ollama откройте терминал и выполните команду запуска нужной модели, например `ollama run qwen3:4b`.
Проверьте, насколько быстро модель отвечает, справляется ли с русским языком и решает ли ваши задачи. Если ответы появляются слишком медленно, попробуйте меньшую модель или более компактное квантование.
Для сравнения скорости можно посмотреть на количество генерируемых токенов в секунду (tokens/s). Чем выше показатель, тем быстрее модель выдаёт текст, хотя субъективная скорость также зависит от задержки перед первым токеном и длины ответа.
- Решите, нужен ли отдельный интерфейс. Для первых экспериментов достаточно встроенного чата. Если нужен веб-интерфейс, можно подключить Open WebUI. Перед запуском проверьте сетевые настройки: не открывайте интерфейс для доступа из интернета без необходимости и защиты.
После настройки попробуйте отключить интернет и отправить модели ещё один запрос. Если всё работает, вы можете использовать её локально без постоянного подключения к сети.
Рисунок 3. Загрузка LM Studio (источник: lmstudio.ai)
Запуск локальной модели сводится к проверке памяти, установке Ollama или LM Studio, выбору подходящей по VRAM модели, быстрой проверке скорости и качества ответов. Начинать лучше с компактной нейросети, а отдельный интерфейс подключать только при необходимости; тест без интернета подтвердит, что всё работает локально.
Выводы
Локальный запуск нейросетей в 2026 году перестал быть хобби для экспериментаторов. Модели вроде Qwen3-8B, Qwen3-14B и Gemma 3 12B могут быть полезны для домашних и рабочих задач, но качество зависит от самой модели, квантования и конкретного сценария. Инструменты вроде Ollama и LM Studio убирают технический порог.
Главным ограничением для пользователей остаётся память: 8 ГБ VRAM позволяют запускать некоторые компактные модели и отдельные более крупные модели в подходящем квантовании, но не гарантируют комфортную работу с любой моделью. 16–24 ГБ VRAM расширяют выбор, однако требования всё равно нужно проверять для конкретной версии и контекста.
Если задача — контролировать обработку данных и меньше зависеть от облачных подписок, начинать стоит с одной модели под своё железо и одного инструмента. Дальше — по мере необходимости.


