


Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Группа исследователей из Университета Техаса и Университета Пердью предложила необычную идею: большие языковые модели (LLM), вроде ChatGPT, могут «тупить» от некачественных данных примерно так же, как люди — от бесконечных часов в соцсетях.

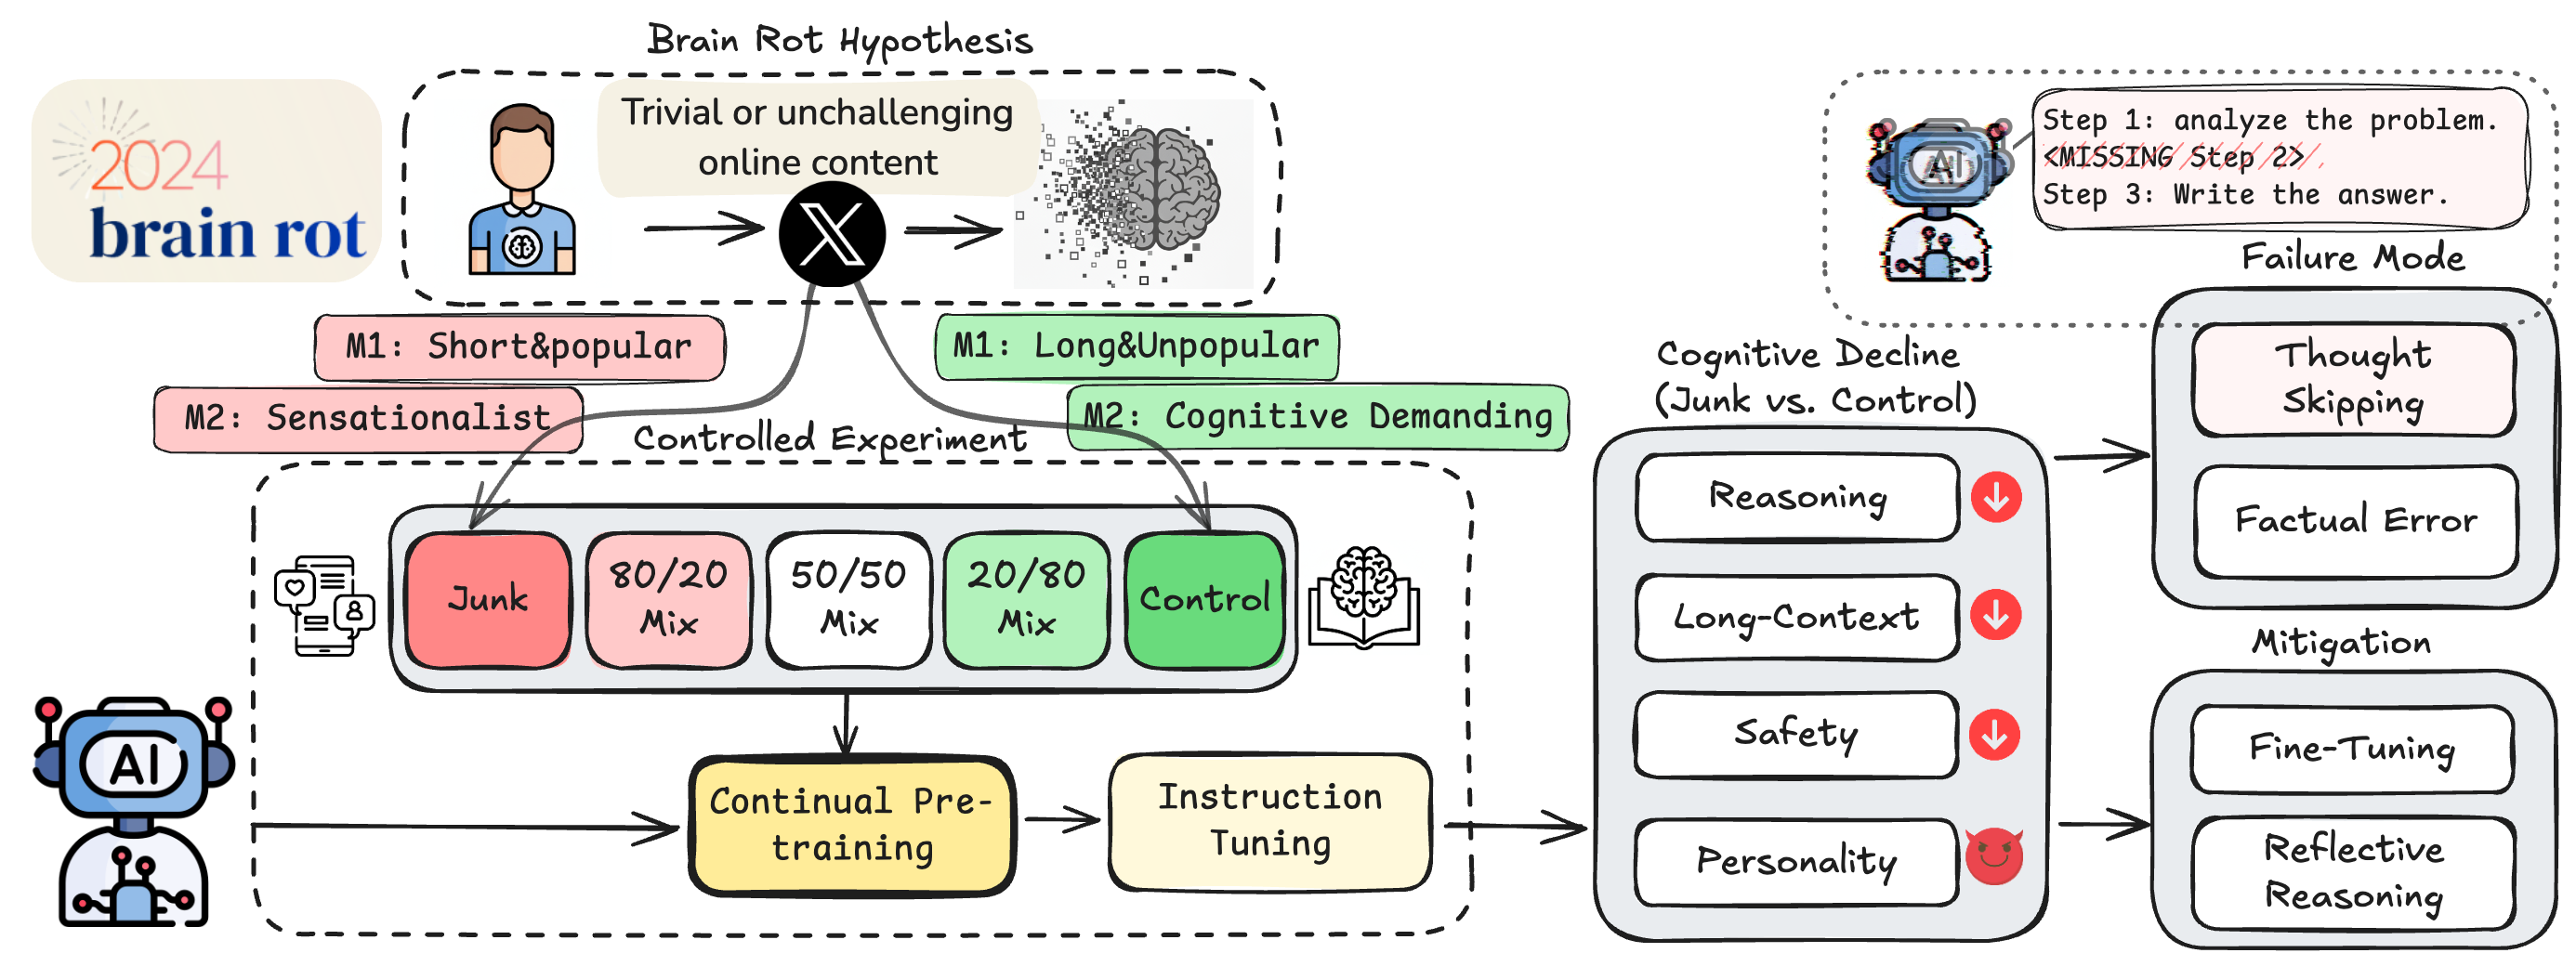
В отчёте специалисты выдвигают «гипотезу гниения мозга LLM». Суть проста: если продолжать дообучать языковую модель на «мусорных» текстах из интернета, она со временем начнёт деградировать — хуже запоминать, терять логику и способность к рассуждению.

Авторы понимают, что отличить хороший контент от плохого сложно. Поэтому они решили изучить 100 миллионов твитов с HuggingFace и отобрать те, что подходят под определение «junk».

В первую группу попали короткие твиты с большим количеством лайков и репостов — те самые, которые вызывают максимальное вовлечение, но несут минимум смысла. Во вторую — посты с «низкой семантической ценностью»: поверхностные темы, кликбейт, громкие заявления, конспирология и прочие «триггерные» темы.


Чтобы проверить качество отбора, результаты GPT-4o сверили с оценками трёх аспирантов — совпадение составило 76%.

Учёные обучили четыре разные языковые модели, комбинируя «мусорные» и «качественные» данные в разных пропорциях. Потом прогнали их через тесты:

  • ARC — на логическое рассуждение,
  • RULER — на память и работу с длинным контекстом,
  • HH-RLHF и AdvBench — на этические нормы,
  • TRAIT — на анализ «личностного стиля».

Результаты оказались любопытными: чем больше в обучающем наборе было «интернет-мусора», тем хуже модель справлялась с задачами на рассуждение и память. Однако влияние на «этичность» и «черты личности» было неоднозначным: например, модель Llama-8B с 50% «мусора» даже показала лучшие результаты по «открытости» и «низкой тревожности».

Исследователи сделали вывод: переизбыток интернет-контента может привести к деградации моделей и призвали разработчиков тщательнее отбирать данные для обучения. Особенно сейчас, когда всё больше онлайн-текста создаётся уже самими ИИ — и это может ускорить эффект так называемого model collapse, когда модели начинают обучаться на собственных ошибках.

Учёные шутят: если так пойдёт и дальше, возможно, придётся вернуться к книгам — хотя бы ради того, чтобы «накормить» модели чем-то действительно качественным.

Подпишитесь на новости

Пользователи Claude из России и Гонконга сообщили о блокировках

VPN подключён, Claude месяцами работает, а потом приходит письмо о прекращении доступа. Пользователи из России и Гонконга сообщают о блокировках аккаунтов, с которых заходили в сервис через VPN. В уведомлениях команда безопасности Anthropic ссылается на подозрительные сигналы и нарушение правил использования.

О жалобах в Гонконге пишет South China Morning Post. Компания предлагает подать апелляцию, но, судя по жалобам в соцсетях, пересмотр помогает не всем: некоторые получают ответ, что решение окончательное.

Один из жителей Гонконга рассказал, что пользовался Claude через NordVPN около полугода, прежде чем аккаунт заблокировали. Другие пользователи описывают похожий сценарий: длительная работа без проблем, затем внезапная приостановка доступа.

О блокировке также сообщил в Telegram руководитель подразделения транзакционного ИИ Яндекса Роман Маресов. Он опубликовал письмо Anthropic и написал, что теперь придётся вернуться с Claude Code к Codex.


Россия и Гонконг отсутствуют в официальном списке поддерживаемых регионов Anthropic. Компания прямо предупреждает: нарушение региональной политики может привести к приостановке или полному прекращению доступа.

При этом отдельного ужесточения правил для VPN Anthropic публично не объявляла. Поэтому утверждать, что компания запрещает любой VPN, оснований нет. Но месяцы успешного подключения, как показывают жалобы, от блокировки аккаунта не страхуют.

RSS: Новости на портале Anti-Malware.ru