


Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Группа исследователей из Университета Техаса и Университета Пердью предложила необычную идею: большие языковые модели (LLM), вроде ChatGPT, могут «тупить» от некачественных данных примерно так же, как люди — от бесконечных часов в соцсетях.

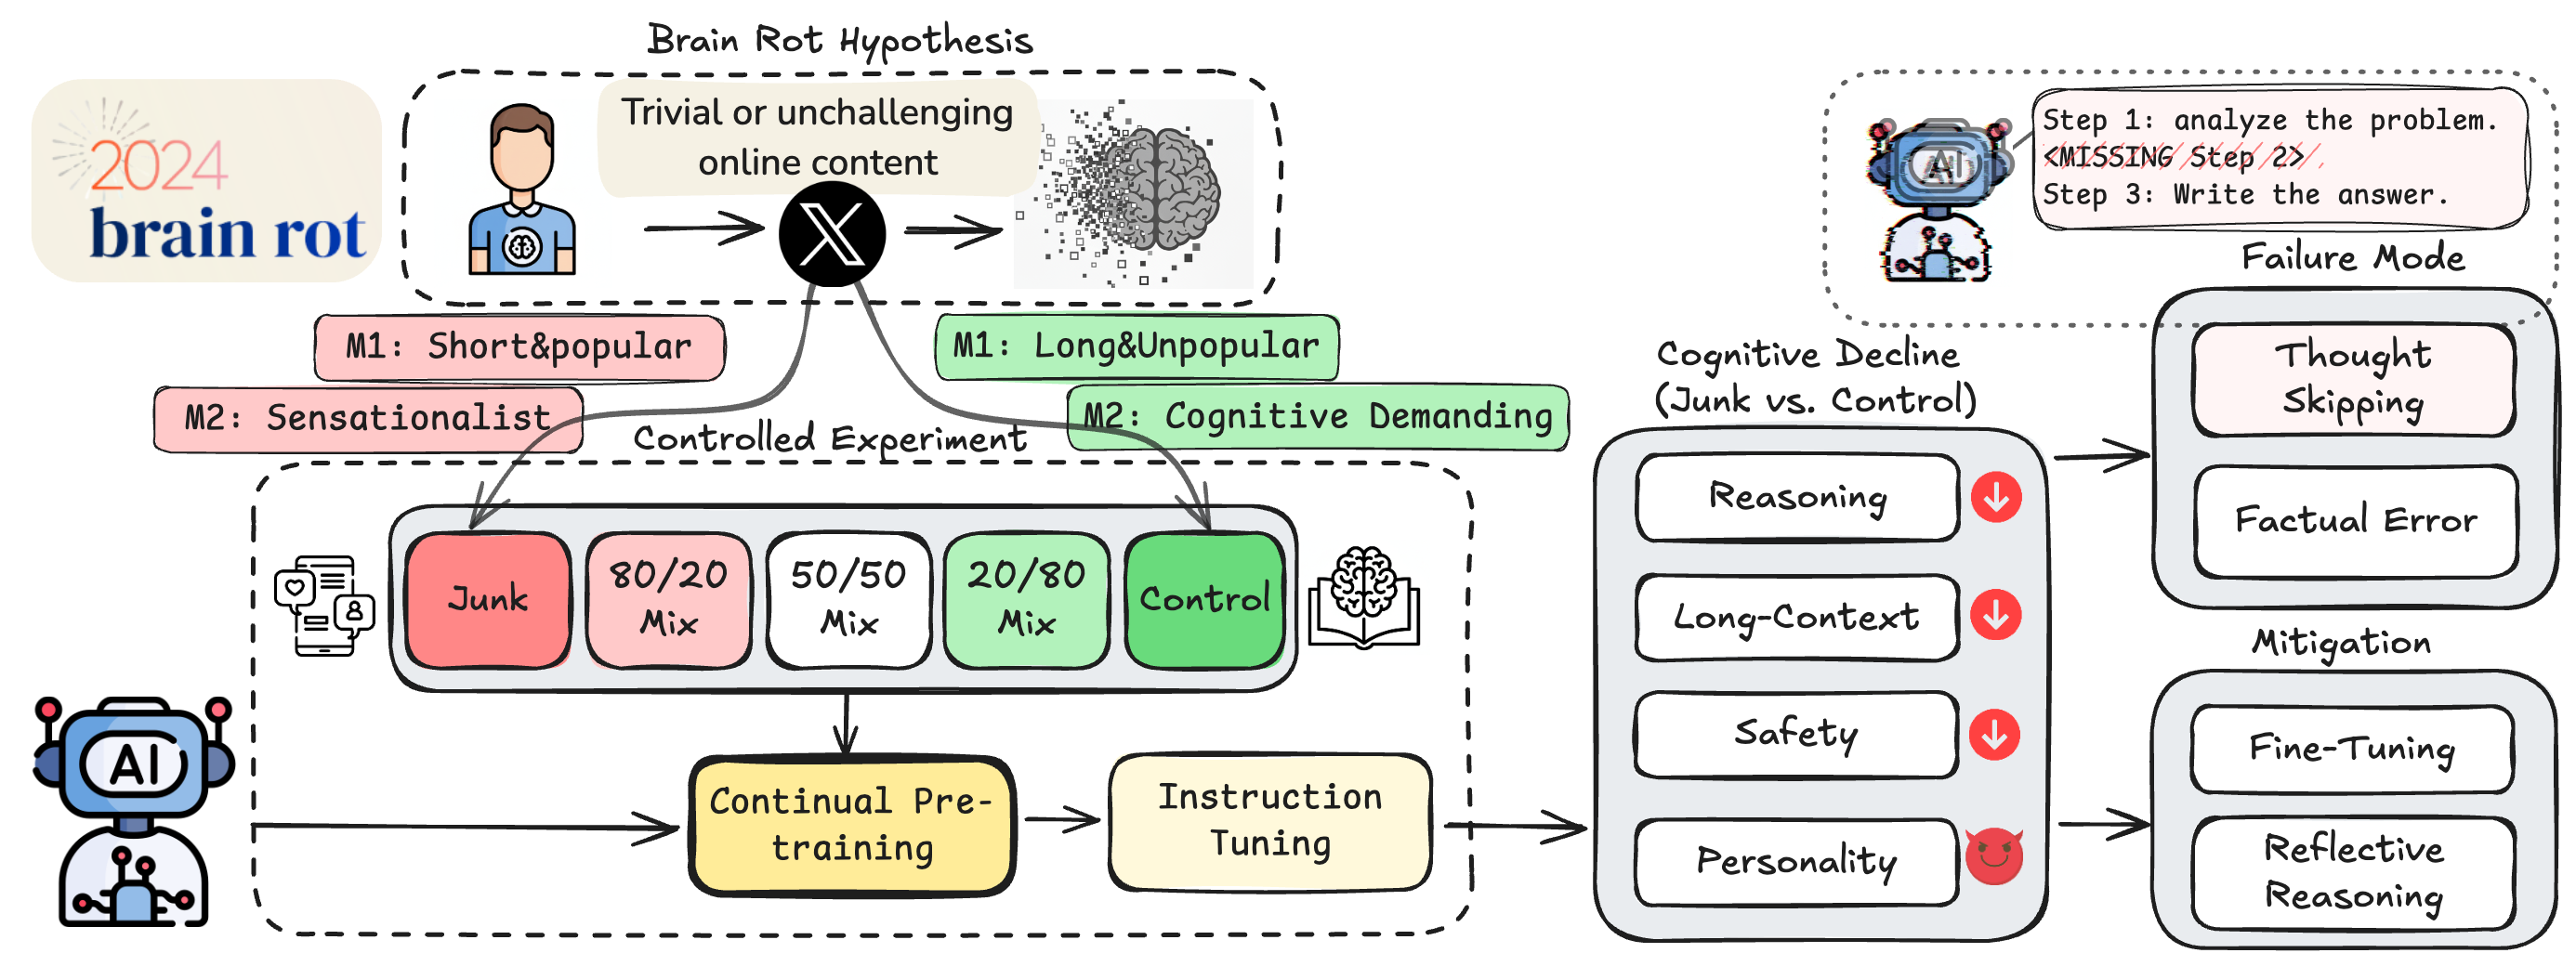
В отчёте специалисты выдвигают «гипотезу гниения мозга LLM». Суть проста: если продолжать дообучать языковую модель на «мусорных» текстах из интернета, она со временем начнёт деградировать — хуже запоминать, терять логику и способность к рассуждению.

Авторы понимают, что отличить хороший контент от плохого сложно. Поэтому они решили изучить 100 миллионов твитов с HuggingFace и отобрать те, что подходят под определение «junk».

В первую группу попали короткие твиты с большим количеством лайков и репостов — те самые, которые вызывают максимальное вовлечение, но несут минимум смысла. Во вторую — посты с «низкой семантической ценностью»: поверхностные темы, кликбейт, громкие заявления, конспирология и прочие «триггерные» темы.


Чтобы проверить качество отбора, результаты GPT-4o сверили с оценками трёх аспирантов — совпадение составило 76%.

Учёные обучили четыре разные языковые модели, комбинируя «мусорные» и «качественные» данные в разных пропорциях. Потом прогнали их через тесты:

  • ARC — на логическое рассуждение,
  • RULER — на память и работу с длинным контекстом,
  • HH-RLHF и AdvBench — на этические нормы,
  • TRAIT — на анализ «личностного стиля».

Результаты оказались любопытными: чем больше в обучающем наборе было «интернет-мусора», тем хуже модель справлялась с задачами на рассуждение и память. Однако влияние на «этичность» и «черты личности» было неоднозначным: например, модель Llama-8B с 50% «мусора» даже показала лучшие результаты по «открытости» и «низкой тревожности».

Исследователи сделали вывод: переизбыток интернет-контента может привести к деградации моделей и призвали разработчиков тщательнее отбирать данные для обучения. Особенно сейчас, когда всё больше онлайн-текста создаётся уже самими ИИ — и это может ускорить эффект так называемого model collapse, когда модели начинают обучаться на собственных ошибках.

Учёные шутят: если так пойдёт и дальше, возможно, придётся вернуться к книгам — хотя бы ради того, чтобы «накормить» модели чем-то действительно качественным.

Подпишитесь на новости

Для онлайн-займов в МФО планируют оставить биометрию по лицу без голоса

Микрофинансовые организации добились принципиального согласия регуляторов на упрощение биометрической идентификации заёмщиков. В Центре биометрических технологий сообщили, что проверка только по изображению лица станет доступна для онлайн-услуг МФО с ноября 2026 года.

Сейчас воспользоваться такими услугами могут более 27 млн человек со стандартной или подтверждённой биометрией в ЕБС, пишет «Коммерсантъ». Переход на лицо без голоса должен расширить эту аудиторию.

Но любая фотография из базы автоматически пропуском не станет. Часть упрощённых биометрических образцов потребует повышения уровня. По данным ЦБТ, такая возможность доступна более чем 30 млн человек.

В Минцифры утверждают, что проверка только по лицу обеспечивает необходимую защиту и не уступает сочетанию лица и голоса. Для клиентов обещают несколько вариантов: компьютер, приложение МФО или переход в «Госуслуги Биометрию».

Рынок рассчитывает сократить число сбоев и упростить регистрацию. Люди уже привыкли сканировать лицо, а уговаривать их дополнительно записывать голос сложнее. Меньше действий — меньше клиентов, которые бросают оформление на полпути.

Биометрическая идентификация для микрофинансовых компаний обязательна с марта 2026 года, однако ЦБ до января 2027-го не применяет надзорные меры за её отсутствие. Для микрокредитных компаний требование заработает с марта 2027 года.

RSS: Новости на портале Anti-Malware.ru