


Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Группа исследователей из Университета Техаса и Университета Пердью предложила необычную идею: большие языковые модели (LLM), вроде ChatGPT, могут «тупить» от некачественных данных примерно так же, как люди — от бесконечных часов в соцсетях.

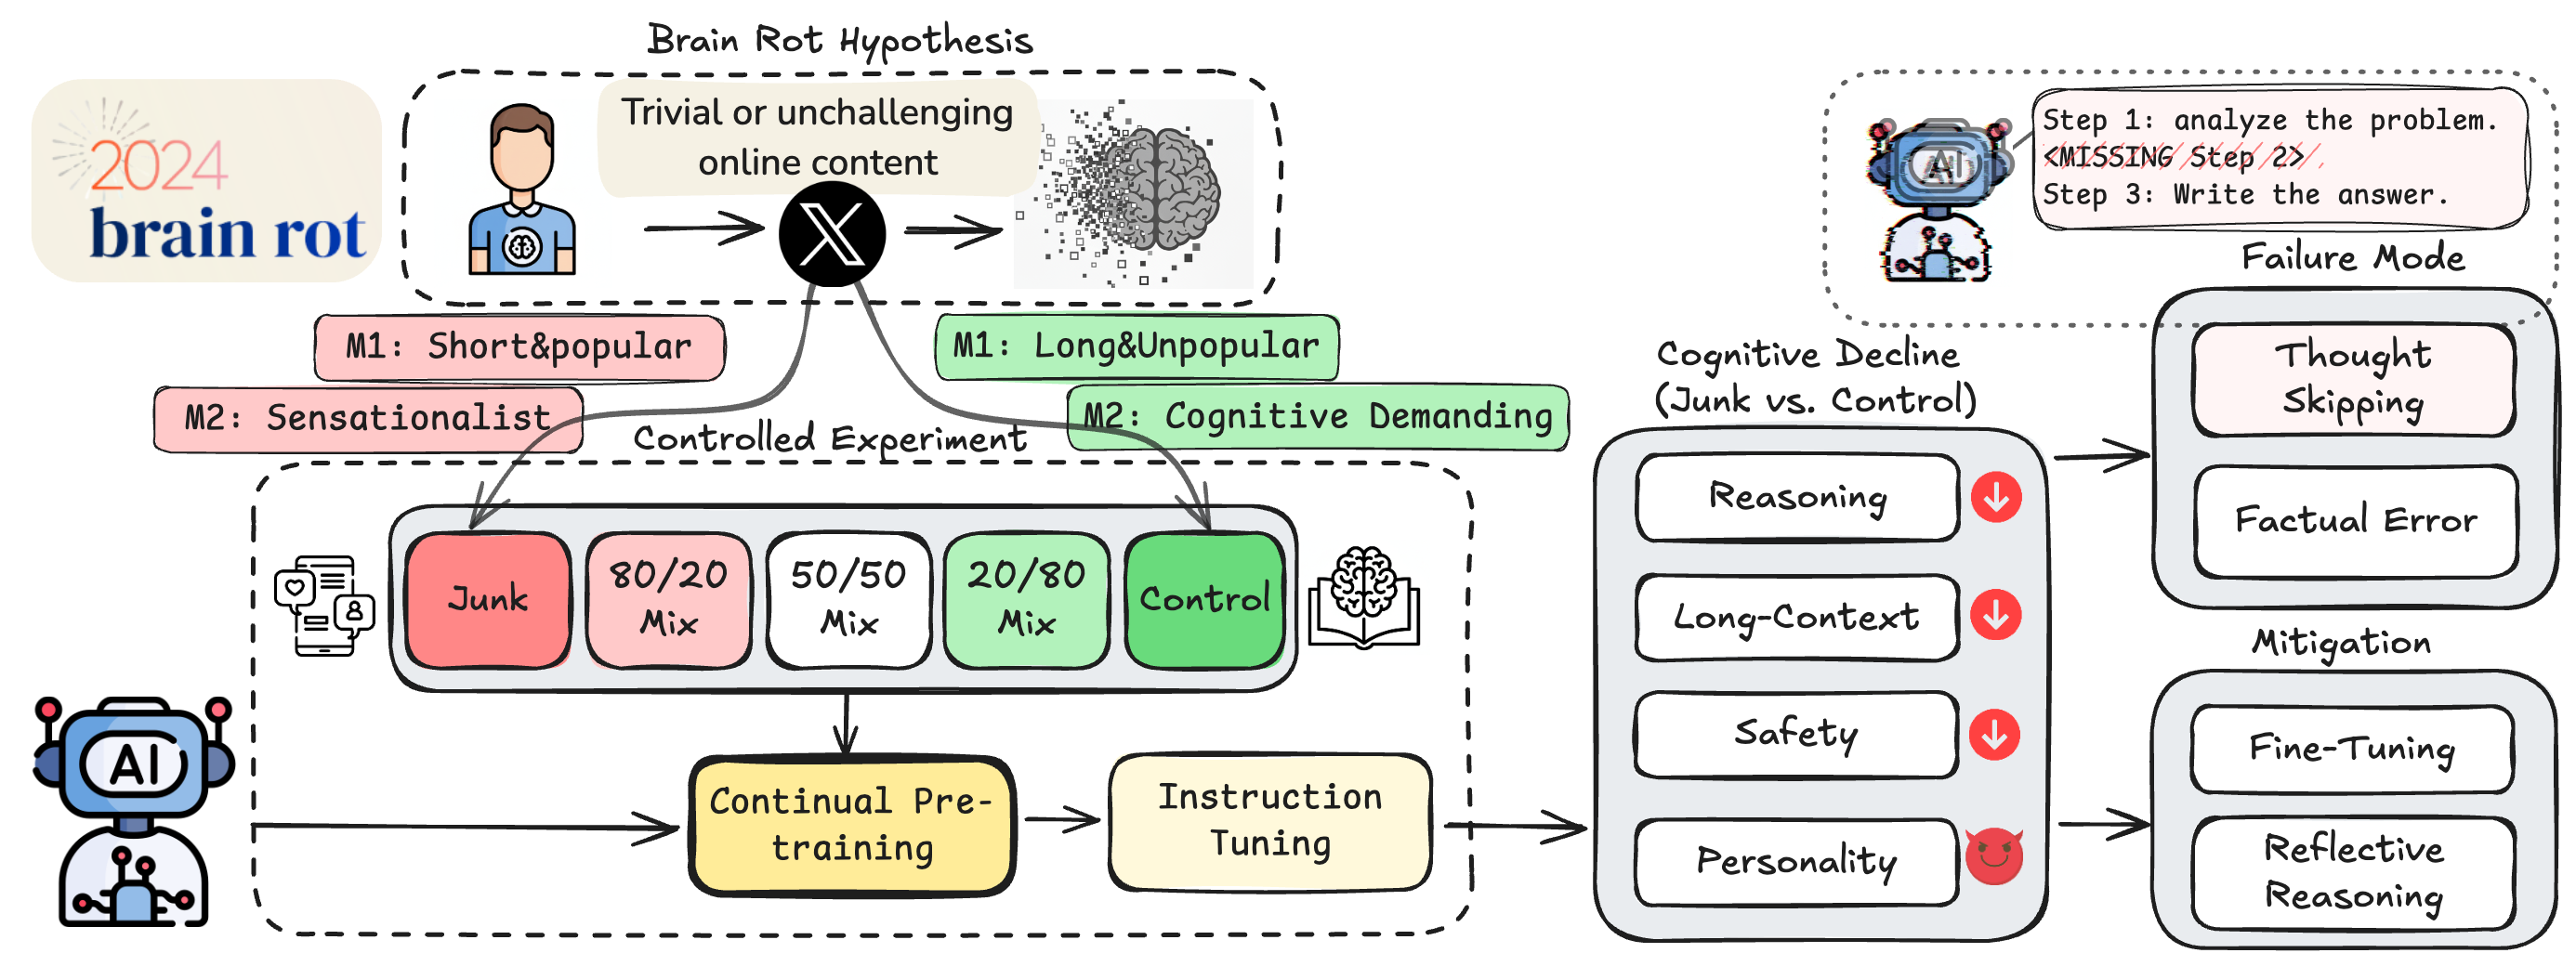
В отчёте специалисты выдвигают «гипотезу гниения мозга LLM». Суть проста: если продолжать дообучать языковую модель на «мусорных» текстах из интернета, она со временем начнёт деградировать — хуже запоминать, терять логику и способность к рассуждению.

Авторы понимают, что отличить хороший контент от плохого сложно. Поэтому они решили изучить 100 миллионов твитов с HuggingFace и отобрать те, что подходят под определение «junk».

В первую группу попали короткие твиты с большим количеством лайков и репостов — те самые, которые вызывают максимальное вовлечение, но несут минимум смысла. Во вторую — посты с «низкой семантической ценностью»: поверхностные темы, кликбейт, громкие заявления, конспирология и прочие «триггерные» темы.


Чтобы проверить качество отбора, результаты GPT-4o сверили с оценками трёх аспирантов — совпадение составило 76%.

Учёные обучили четыре разные языковые модели, комбинируя «мусорные» и «качественные» данные в разных пропорциях. Потом прогнали их через тесты:

  • ARC — на логическое рассуждение,
  • RULER — на память и работу с длинным контекстом,
  • HH-RLHF и AdvBench — на этические нормы,
  • TRAIT — на анализ «личностного стиля».

Результаты оказались любопытными: чем больше в обучающем наборе было «интернет-мусора», тем хуже модель справлялась с задачами на рассуждение и память. Однако влияние на «этичность» и «черты личности» было неоднозначным: например, модель Llama-8B с 50% «мусора» даже показала лучшие результаты по «открытости» и «низкой тревожности».

Исследователи сделали вывод: переизбыток интернет-контента может привести к деградации моделей и призвали разработчиков тщательнее отбирать данные для обучения. Особенно сейчас, когда всё больше онлайн-текста создаётся уже самими ИИ — и это может ускорить эффект так называемого model collapse, когда модели начинают обучаться на собственных ошибках.

Учёные шутят: если так пойдёт и дальше, возможно, придётся вернуться к книгам — хотя бы ради того, чтобы «накормить» модели чем-то действительно качественным.

Подпишитесь на новости

Gartner: к 2028 году ИИ-кодинг станет дороже зарплаты разработчика

ИИ пишет код, а счёт за его работу начинает кусаться. По прогнозу Gartner, к 2028 году расходы на разработку с использованием больших языковых моделей обгонят среднюю зарплату программиста. Причины — рост потребления токенов и переход поставщиков к оплате по фактическому использованию.

Токены — единицы данных, которые обрабатывает модель. Чем активнее работают агенты и чем больше информации им передают, тем выше расходы.

Фиксированная подписка уступает место тарификации, при которой бюджет предсказать гораздо сложнее.

По оценке аналитика Gartner Нитиша Тьяги, разработчики обычно оптимизируют скорость и удобство работы. Дисциплина расходов сама собой не появится: без контроля затраты способны расти быстрее продуктивности.

Масла в огонь подливают чрезмерная автономность агентов, раздутый контекст и отсутствие регулярного разбора дорогих задач. А встроенные инструменты оптимизации расходов у поставщиков пока недостаточно зрелые.

Gartner рекомендует заранее определять, какие задачи поручать ИИ и сколько самостоятельности ему давать. Простую работу стоит направлять небольшим дешёвым моделям, сложную — более мощным. Контекст нужно очищать от лишнего, потребление токенов, а перерасход разбирать на ретроспективах.

RSS: Новости на портале Anti-Malware.ru