


Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Группа исследователей из Университета Техаса и Университета Пердью предложила необычную идею: большие языковые модели (LLM), вроде ChatGPT, могут «тупить» от некачественных данных примерно так же, как люди — от бесконечных часов в соцсетях.

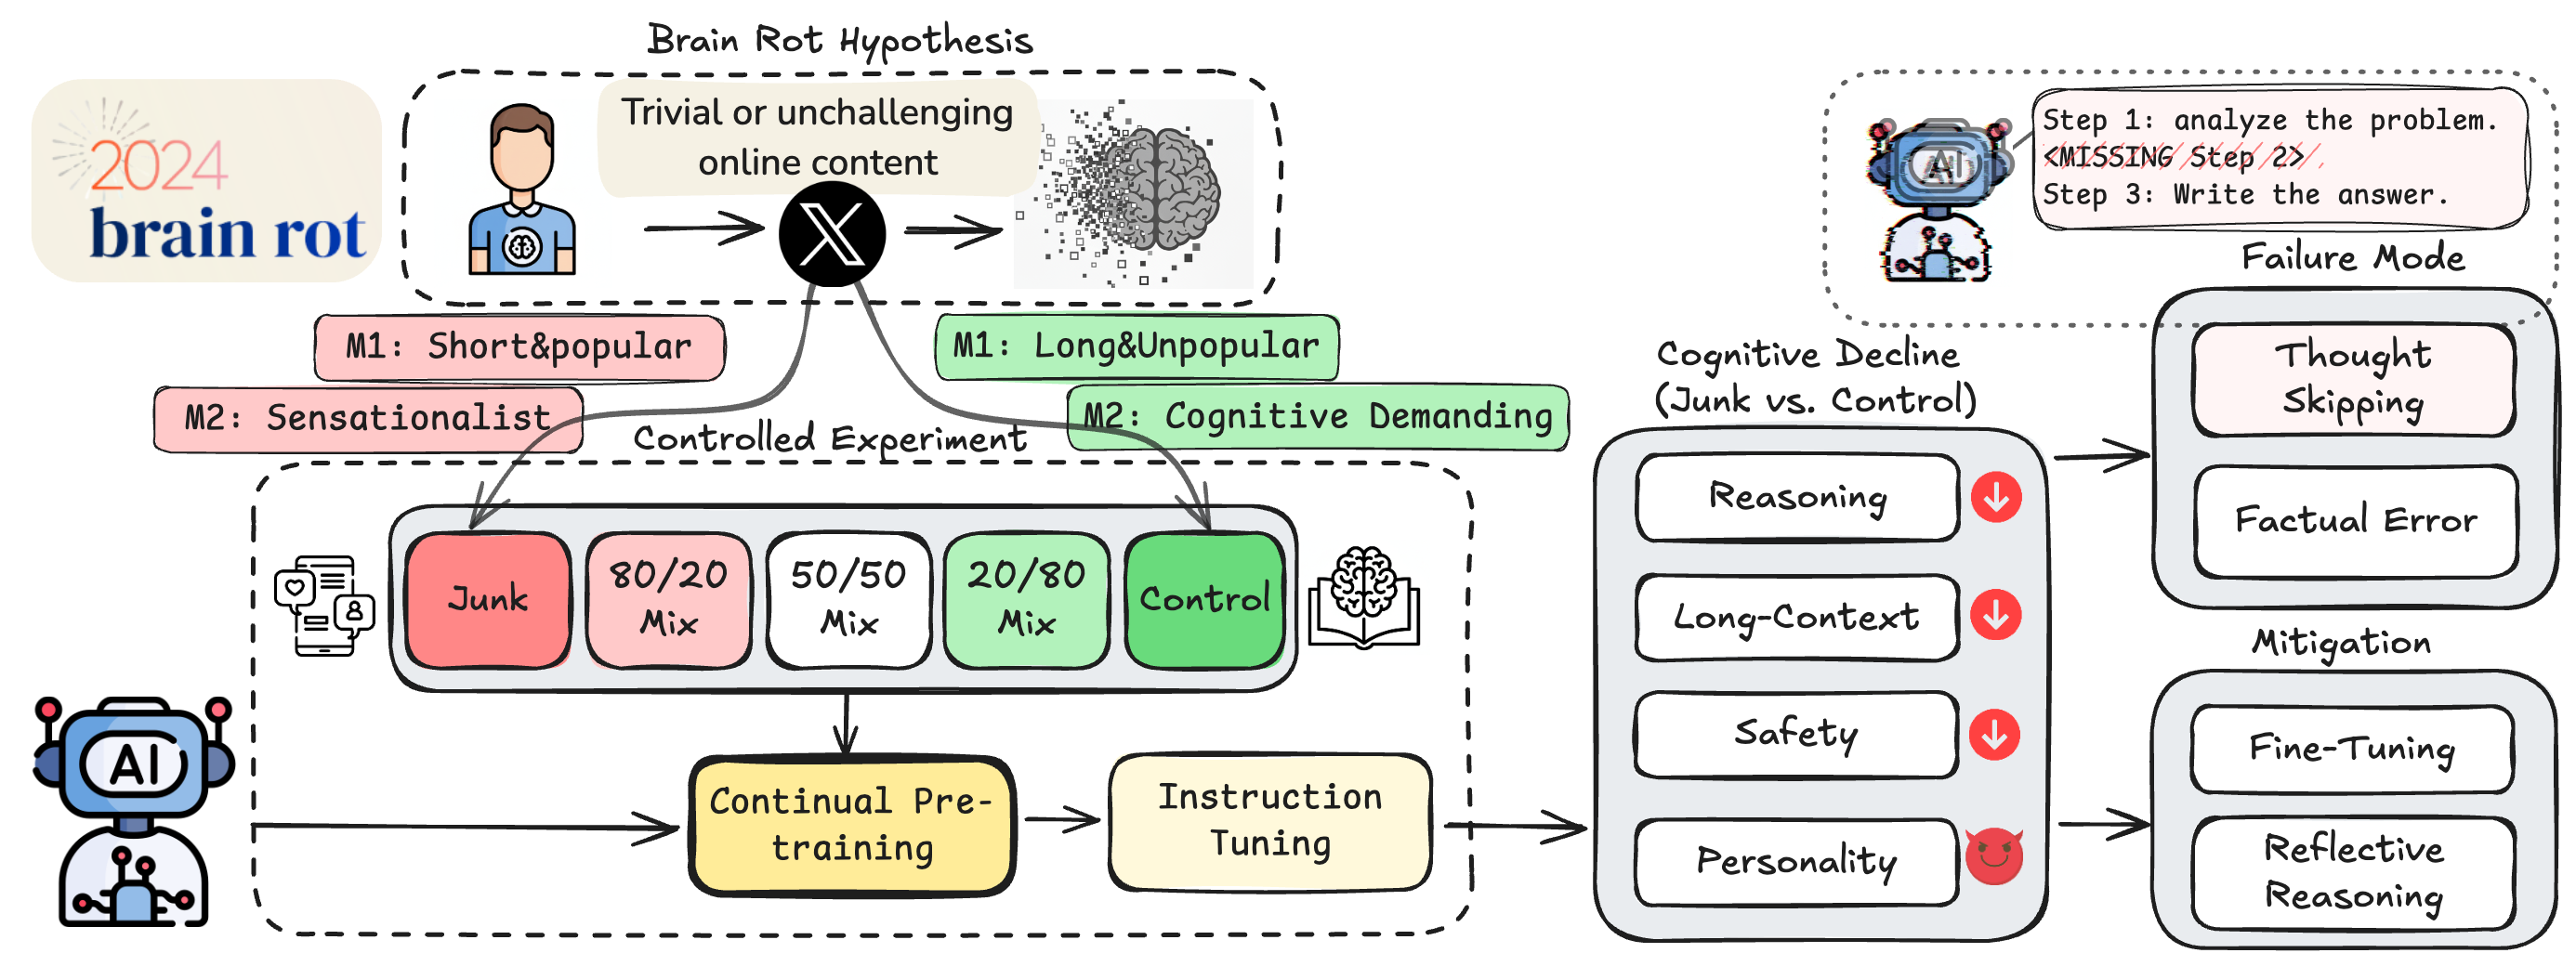
В отчёте специалисты выдвигают «гипотезу гниения мозга LLM». Суть проста: если продолжать дообучать языковую модель на «мусорных» текстах из интернета, она со временем начнёт деградировать — хуже запоминать, терять логику и способность к рассуждению.

Авторы понимают, что отличить хороший контент от плохого сложно. Поэтому они решили изучить 100 миллионов твитов с HuggingFace и отобрать те, что подходят под определение «junk».

В первую группу попали короткие твиты с большим количеством лайков и репостов — те самые, которые вызывают максимальное вовлечение, но несут минимум смысла. Во вторую — посты с «низкой семантической ценностью»: поверхностные темы, кликбейт, громкие заявления, конспирология и прочие «триггерные» темы.


Чтобы проверить качество отбора, результаты GPT-4o сверили с оценками трёх аспирантов — совпадение составило 76%.

Учёные обучили четыре разные языковые модели, комбинируя «мусорные» и «качественные» данные в разных пропорциях. Потом прогнали их через тесты:

  • ARC — на логическое рассуждение,
  • RULER — на память и работу с длинным контекстом,
  • HH-RLHF и AdvBench — на этические нормы,
  • TRAIT — на анализ «личностного стиля».

Результаты оказались любопытными: чем больше в обучающем наборе было «интернет-мусора», тем хуже модель справлялась с задачами на рассуждение и память. Однако влияние на «этичность» и «черты личности» было неоднозначным: например, модель Llama-8B с 50% «мусора» даже показала лучшие результаты по «открытости» и «низкой тревожности».

Исследователи сделали вывод: переизбыток интернет-контента может привести к деградации моделей и призвали разработчиков тщательнее отбирать данные для обучения. Особенно сейчас, когда всё больше онлайн-текста создаётся уже самими ИИ — и это может ускорить эффект так называемого model collapse, когда модели начинают обучаться на собственных ошибках.

Учёные шутят: если так пойдёт и дальше, возможно, придётся вернуться к книгам — хотя бы ради того, чтобы «накормить» модели чем-то действительно качественным.

Подпишитесь на новости

В Госдуме предложили отмечать участие ИИ в медицинских заключениях

Нейросеть помогла разобрать снимок или результаты обследования? Пациент должен об этом знать. Депутат Госдумы Борис Чернышов предложил обязать медорганизации сообщать об использовании ИИ при анализе медицинских данных. Обращение направлено главе Минздрава Михаилу Мурашко.

Как сообщает ТАСС, если алгоритм участвовал в анализе медицинских изображений, результатов исследований или других данных для диагностики, в бумажном либо электронном документе должна появиться соответствующая отметка.

В ней предлагается указывать, что при анализе применялся искусственный интеллект, а итоговое медицинское заключение принял медицинский работник. Так пациент сможет увидеть, где врачу помогала нейросеть.

При этом собирать отдельное согласие на каждое применение ИИ Чернышов не предлагает. По его мнению, уведомление должно давать человеку информацию и обходиться без дополнительной бюрократии для клиник.

Депутат считает, что внедрение ИИ в здравоохранение нужно поддерживать: такие системы помогают анализировать большие объёмы данных и выявлять патологии. Но пациент вправе понимать, как получен результат его обследования.

Однако стоит учитывать, что пока это просто обращение к министру. Новую обязанность для медорганизаций ещё не установили.

RSS: Новости на портале Anti-Malware.ru