


Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Группа исследователей из Университета Техаса и Университета Пердью предложила необычную идею: большие языковые модели (LLM), вроде ChatGPT, могут «тупить» от некачественных данных примерно так же, как люди — от бесконечных часов в соцсетях.

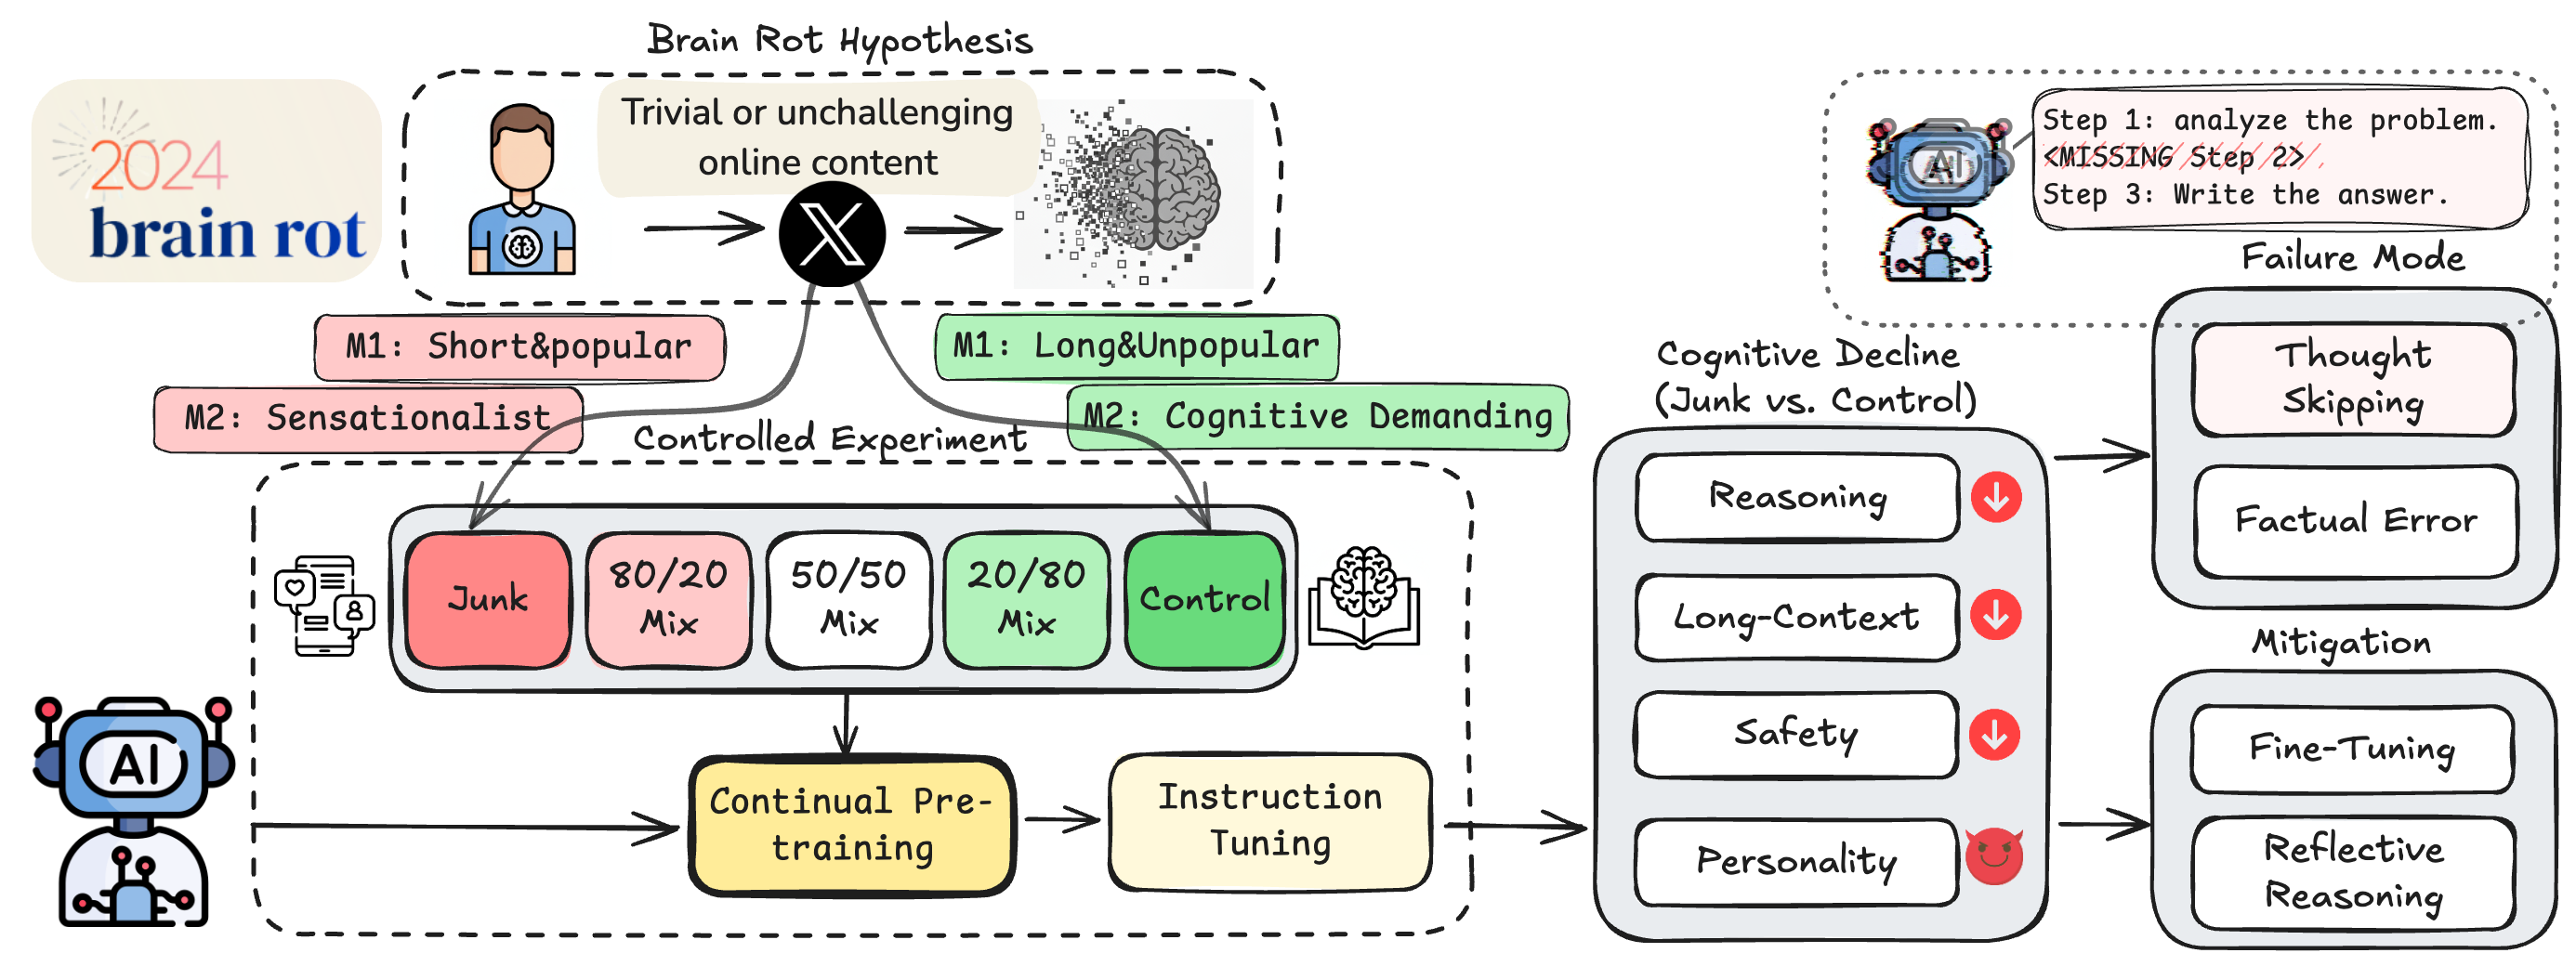
В отчёте специалисты выдвигают «гипотезу гниения мозга LLM». Суть проста: если продолжать дообучать языковую модель на «мусорных» текстах из интернета, она со временем начнёт деградировать — хуже запоминать, терять логику и способность к рассуждению.

Авторы понимают, что отличить хороший контент от плохого сложно. Поэтому они решили изучить 100 миллионов твитов с HuggingFace и отобрать те, что подходят под определение «junk».

В первую группу попали короткие твиты с большим количеством лайков и репостов — те самые, которые вызывают максимальное вовлечение, но несут минимум смысла. Во вторую — посты с «низкой семантической ценностью»: поверхностные темы, кликбейт, громкие заявления, конспирология и прочие «триггерные» темы.


Чтобы проверить качество отбора, результаты GPT-4o сверили с оценками трёх аспирантов — совпадение составило 76%.

Учёные обучили четыре разные языковые модели, комбинируя «мусорные» и «качественные» данные в разных пропорциях. Потом прогнали их через тесты:

  • ARC — на логическое рассуждение,
  • RULER — на память и работу с длинным контекстом,
  • HH-RLHF и AdvBench — на этические нормы,
  • TRAIT — на анализ «личностного стиля».

Результаты оказались любопытными: чем больше в обучающем наборе было «интернет-мусора», тем хуже модель справлялась с задачами на рассуждение и память. Однако влияние на «этичность» и «черты личности» было неоднозначным: например, модель Llama-8B с 50% «мусора» даже показала лучшие результаты по «открытости» и «низкой тревожности».

Исследователи сделали вывод: переизбыток интернет-контента может привести к деградации моделей и призвали разработчиков тщательнее отбирать данные для обучения. Особенно сейчас, когда всё больше онлайн-текста создаётся уже самими ИИ — и это может ускорить эффект так называемого model collapse, когда модели начинают обучаться на собственных ошибках.

Учёные шутят: если так пойдёт и дальше, возможно, придётся вернуться к книгам — хотя бы ради того, чтобы «накормить» модели чем-то действительно качественным.

Подпишитесь на новости

GPT-6 Astra расшифровала послание времён Наполеона спустя 217 лет

Шифр пережил империи, войны и поколения исследователей, а теперь за него взялся ИИ. Инженер Картер Черч рассказал в своём блоге, как с помощью GPT-6 Astra восстановил содержание письма генералу Огюсту де Мармону. По его словам, потребовалось около шести часов работы модели и несколько вечеров собственного времени.

Послание отправили в марте 1809 года по распоряжению Наполеона через его пасынка Эжена де Богарне. Мармон командовал войсками в Далмации, и ему нужно было знать расположение французских и союзных армий перед войной с Австрией.

Ключ не сохранился. На скане — около 1300 зашифрованных единиц и 155 разных знаков. Причём одна буква могла обозначаться несколькими символами: обычный подсчёт частот здесь буксует.


ИИ прочитал изображение и использовал 33 ранее установленных значения. Остальные подбирались методом имитации отжига: варианты оценивали по статистике французских текстов. Затем расшифровку проверяли по исходному скану.

Внутри оказалась военная сводка с уверенным прогнозом: Австрии предстоит атака с нескольких направлений, и она движется к поражению.


Черч опубликовал восстановленный ключ и скрипты для проверки результата. Пять знаков остаются неоднозначными, но, по его оценке, общий смысл от этого не меняется. Автор также сообщает, что историк криптографии Сатоси Томокиё проверил решение, после чего письмо внесли в список расшифрованных.

RSS: Новости на портале Anti-Malware.ru