


Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Группа исследователей из Университета Техаса и Университета Пердью предложила необычную идею: большие языковые модели (LLM), вроде ChatGPT, могут «тупить» от некачественных данных примерно так же, как люди — от бесконечных часов в соцсетях.

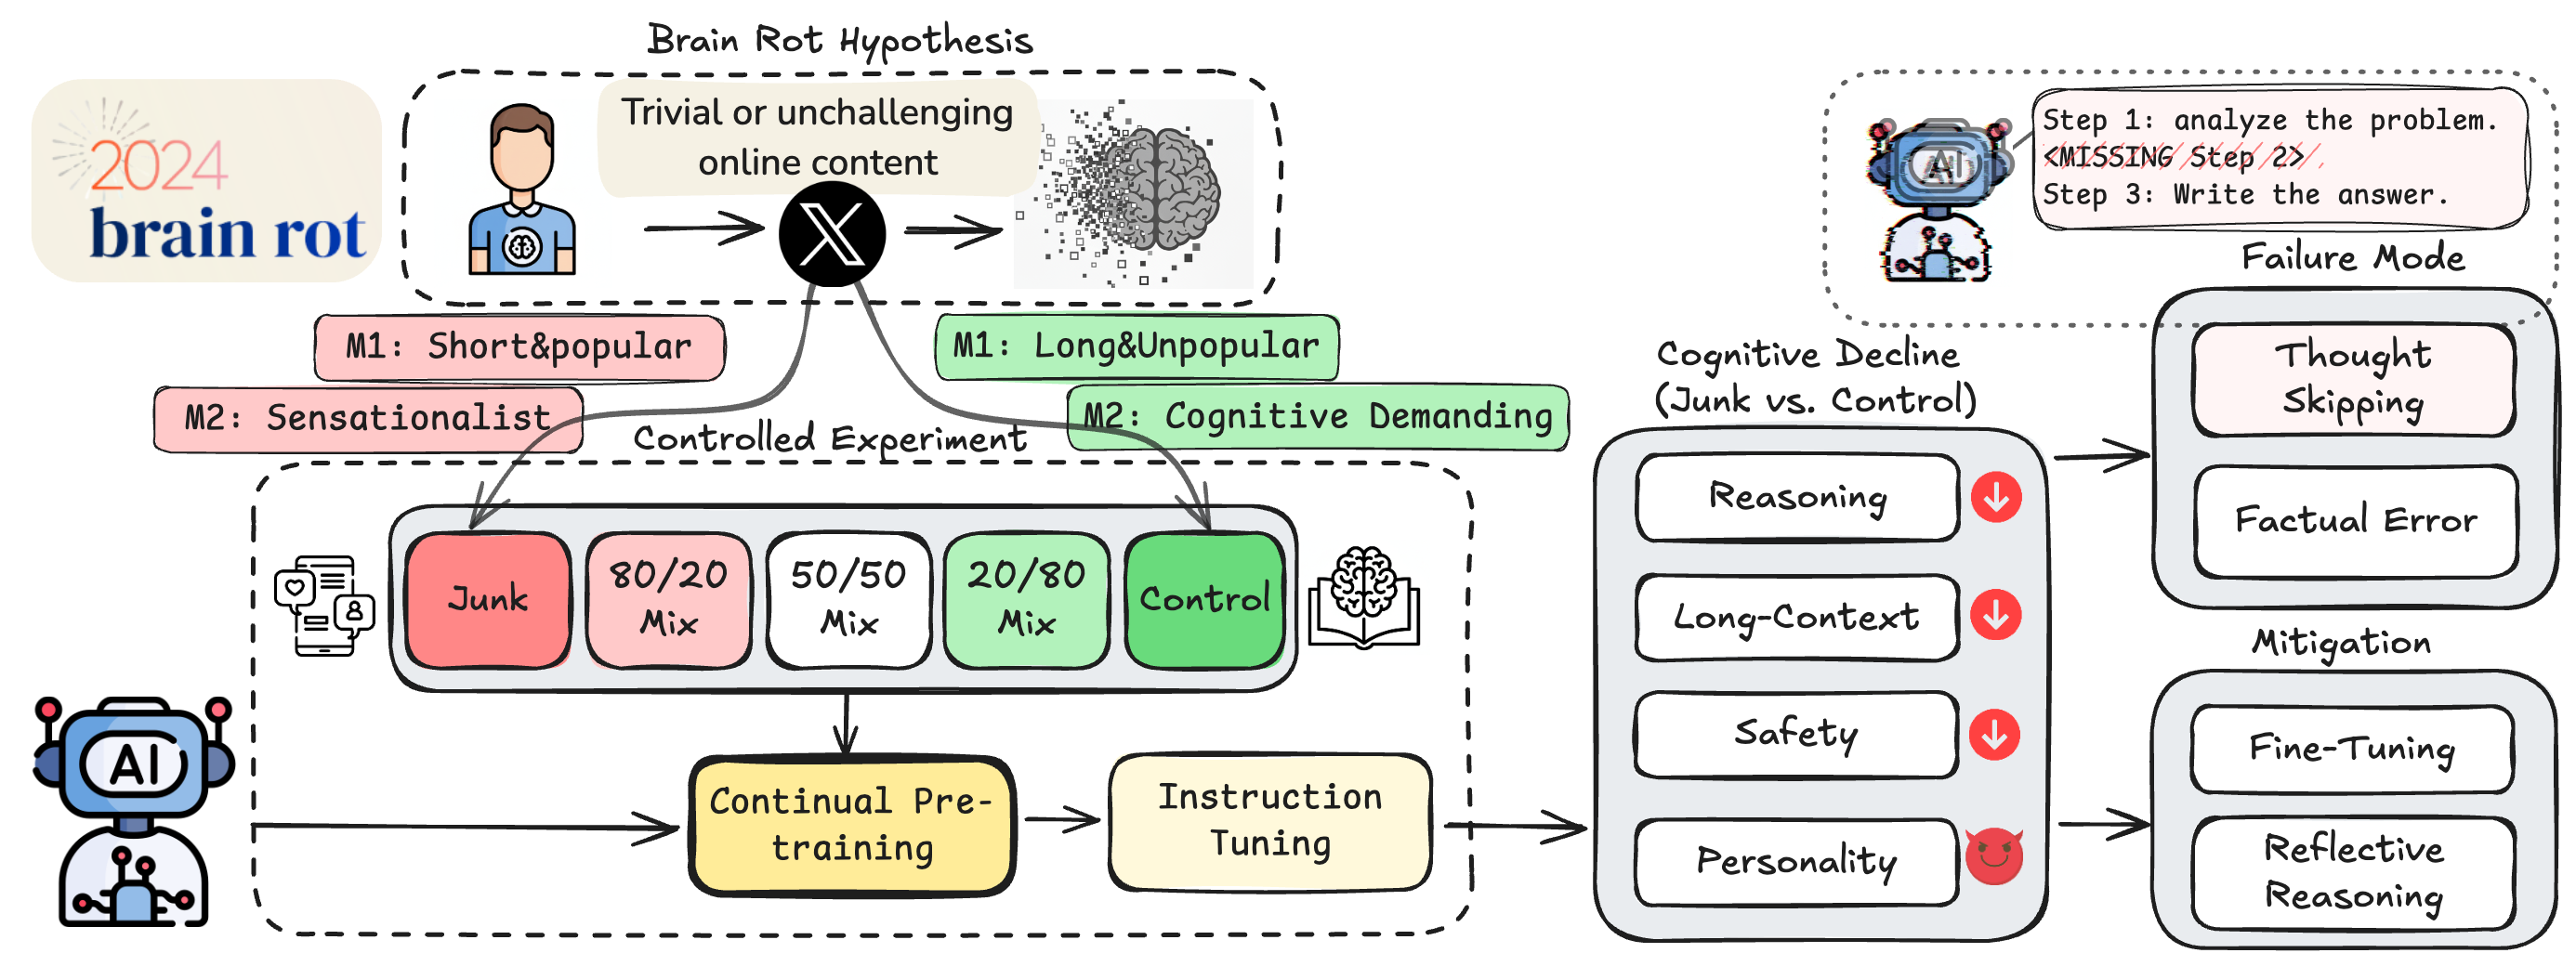
В отчёте специалисты выдвигают «гипотезу гниения мозга LLM». Суть проста: если продолжать дообучать языковую модель на «мусорных» текстах из интернета, она со временем начнёт деградировать — хуже запоминать, терять логику и способность к рассуждению.

Авторы понимают, что отличить хороший контент от плохого сложно. Поэтому они решили изучить 100 миллионов твитов с HuggingFace и отобрать те, что подходят под определение «junk».

В первую группу попали короткие твиты с большим количеством лайков и репостов — те самые, которые вызывают максимальное вовлечение, но несут минимум смысла. Во вторую — посты с «низкой семантической ценностью»: поверхностные темы, кликбейт, громкие заявления, конспирология и прочие «триггерные» темы.


Чтобы проверить качество отбора, результаты GPT-4o сверили с оценками трёх аспирантов — совпадение составило 76%.

Учёные обучили четыре разные языковые модели, комбинируя «мусорные» и «качественные» данные в разных пропорциях. Потом прогнали их через тесты:

  • ARC — на логическое рассуждение,
  • RULER — на память и работу с длинным контекстом,
  • HH-RLHF и AdvBench — на этические нормы,
  • TRAIT — на анализ «личностного стиля».

Результаты оказались любопытными: чем больше в обучающем наборе было «интернет-мусора», тем хуже модель справлялась с задачами на рассуждение и память. Однако влияние на «этичность» и «черты личности» было неоднозначным: например, модель Llama-8B с 50% «мусора» даже показала лучшие результаты по «открытости» и «низкой тревожности».

Исследователи сделали вывод: переизбыток интернет-контента может привести к деградации моделей и призвали разработчиков тщательнее отбирать данные для обучения. Особенно сейчас, когда всё больше онлайн-текста создаётся уже самими ИИ — и это может ускорить эффект так называемого model collapse, когда модели начинают обучаться на собственных ошибках.

Учёные шутят: если так пойдёт и дальше, возможно, придётся вернуться к книгам — хотя бы ради того, чтобы «накормить» модели чем-то действительно качественным.

Подпишитесь на новости

Google готовит голосовую активацию Emergency SOS на Android

Вызвать помощь, не прикасаясь к смартфону: Google, похоже, разрабатывает голосовой запуск Emergency SOS. Предполагаемый сценарий — трижды произнести «Help». Именно такую последовательность показывает найденная анимация: затем активируются определение местоположения, экстренная видеозапись и звонок в службу помощи.

Следы функции обнаружила Android Authority в коде приложения Personal Safety. Пользователям она пока недоступна.

Сейчас для запуска SOS обычно требуется пять раз нажать кнопку питания. Голосовой вариант мог бы пригодиться, когда до телефона не дотянуться или руки заняты. В экстренной ситуации искать нужную кнопку — удовольствие сомнительное.

В коде также есть фразы «Say “yes” to continue» и «Say “cancel” to dismiss Emergency SOS». Они указывают на возможное голосовое подтверждение и отмену. Будет ли подтверждение обязательным во всех случаях, пока неизвестно.

Personal Safety доступно не только на Pixel, поэтому авторы публикации допускают появление функции и на совместимых устройствах других производителей.

Но список моделей, поддерживаемые языки и сроки запуска не объявлены. Рассчитывать, что смартфон уже реагирует на русское «Помогите», оснований нет. Пока голосовой SOS остаётся разработкой, найденной при разборе приложения. До релиза Google может изменить сценарий или вовсе не выпустить функцию.

RSS: Новости на портале Anti-Malware.ru