


Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Группа исследователей из Университета Техаса и Университета Пердью предложила необычную идею: большие языковые модели (LLM), вроде ChatGPT, могут «тупить» от некачественных данных примерно так же, как люди — от бесконечных часов в соцсетях.

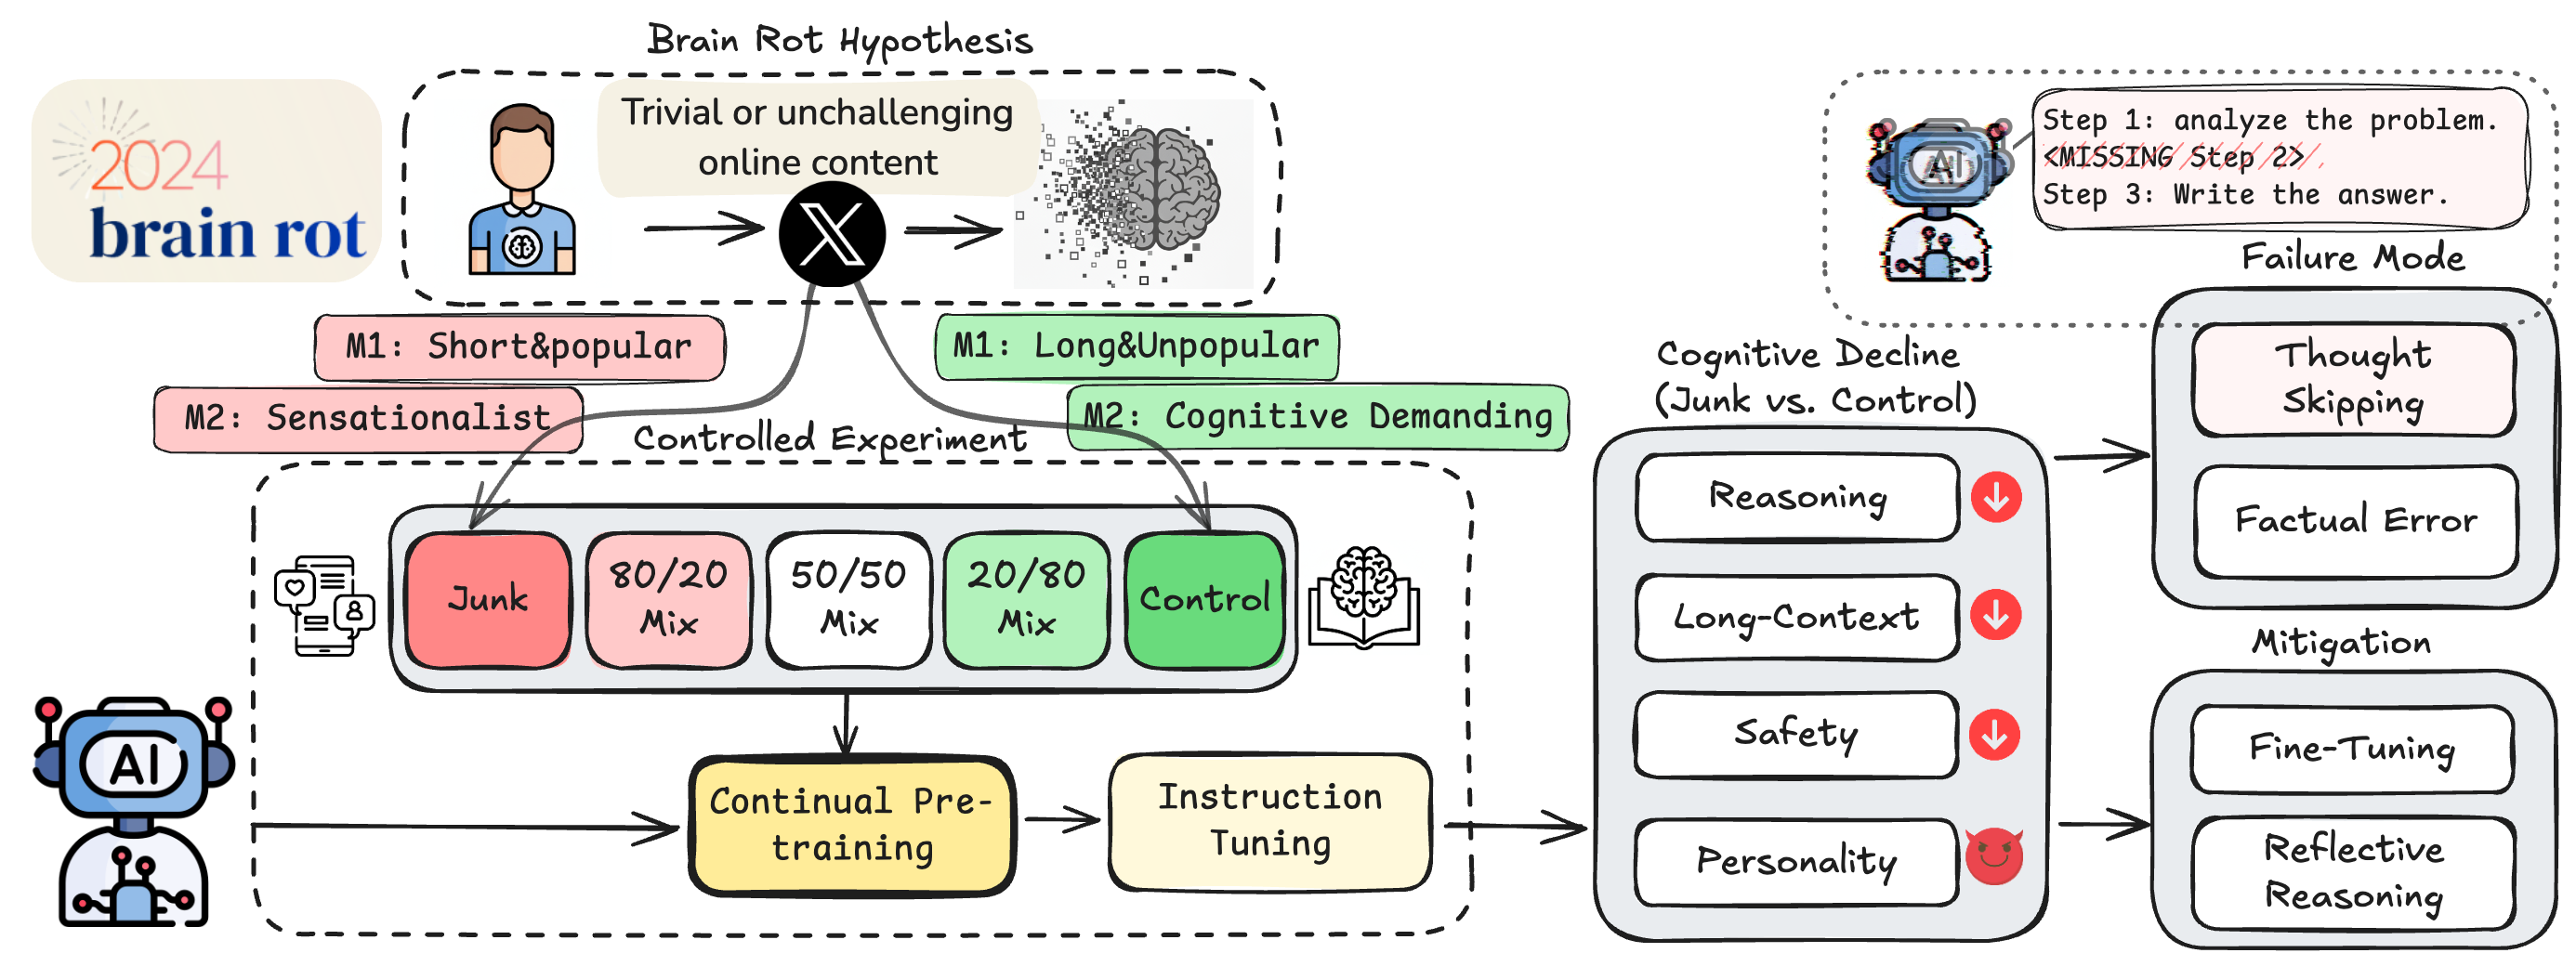
В отчёте специалисты выдвигают «гипотезу гниения мозга LLM». Суть проста: если продолжать дообучать языковую модель на «мусорных» текстах из интернета, она со временем начнёт деградировать — хуже запоминать, терять логику и способность к рассуждению.

Авторы понимают, что отличить хороший контент от плохого сложно. Поэтому они решили изучить 100 миллионов твитов с HuggingFace и отобрать те, что подходят под определение «junk».

В первую группу попали короткие твиты с большим количеством лайков и репостов — те самые, которые вызывают максимальное вовлечение, но несут минимум смысла. Во вторую — посты с «низкой семантической ценностью»: поверхностные темы, кликбейт, громкие заявления, конспирология и прочие «триггерные» темы.


Чтобы проверить качество отбора, результаты GPT-4o сверили с оценками трёх аспирантов — совпадение составило 76%.

Учёные обучили четыре разные языковые модели, комбинируя «мусорные» и «качественные» данные в разных пропорциях. Потом прогнали их через тесты:

  • ARC — на логическое рассуждение,
  • RULER — на память и работу с длинным контекстом,
  • HH-RLHF и AdvBench — на этические нормы,
  • TRAIT — на анализ «личностного стиля».

Результаты оказались любопытными: чем больше в обучающем наборе было «интернет-мусора», тем хуже модель справлялась с задачами на рассуждение и память. Однако влияние на «этичность» и «черты личности» было неоднозначным: например, модель Llama-8B с 50% «мусора» даже показала лучшие результаты по «открытости» и «низкой тревожности».

Исследователи сделали вывод: переизбыток интернет-контента может привести к деградации моделей и призвали разработчиков тщательнее отбирать данные для обучения. Особенно сейчас, когда всё больше онлайн-текста создаётся уже самими ИИ — и это может ускорить эффект так называемого model collapse, когда модели начинают обучаться на собственных ошибках.

Учёные шутят: если так пойдёт и дальше, возможно, придётся вернуться к книгам — хотя бы ради того, чтобы «накормить» модели чем-то действительно качественным.

Подпишитесь на новости

Мошенники используют ChatGPT[.]com для заражения Windows трояном

Знакомый адрес ChatGPT[.]com ещё не гарантирует, что перед вами официальный продукт OpenAI. Исследователи из Huntress обнаружили кампанию, в которой злоумышленники создали пользовательский GPT «Plus 5.6» и через него заманивали людей на сайт с якобы проверкой безопасности.

Название имитировало обозначение модели, а страница действительно находилась на ChatGPT.com.

В некоторых расследованных случаях пользователи попадали туда из рекламного результата Google по запросу «ChatGPT». Доверенный домен и верхняя строчка поиска — убедительная упаковка.

На обращения бот выдавал практически одинаковый ответ: основной сервис якобы испытывает проблемы, поэтому нужно перейти на резервный домен. Ссылка вела на Google Sites, где посетителя встречала поддельная проверка Cloudflare.


Дальше включался ClickFix: человеку предлагали скопировать команду и выполнить её в Windows. Никакой проверки, запуск начинал многоэтапное заражение трояном удалённого доступа. Вредонос позволяет злоумышленнику управлять компьютером, просматривать файлы и экран, использовать камеру и микрофон.

Huntress расследовала не менее 40 инцидентов, связанных с конкретным сайтом этой кампании. При этом только для двух заражений подтверждён вход через вредоносный GPT.

После обращения исследователей первый GPT удалили 25 сентября. Однако уже 27 сентября Huntress обнаружила другой, связанный с той же кампанией.

Главная уловка — доверие к площадке. Пользовательский бот на официальном сайте остаётся контентом стороннего автора.

RSS: Новости на портале Anti-Malware.ru