


Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Языковые модели тупеют от мусорных данных из интернета

Группа исследователей из Университета Техаса и Университета Пердью предложила необычную идею: большие языковые модели (LLM), вроде ChatGPT, могут «тупить» от некачественных данных примерно так же, как люди — от бесконечных часов в соцсетях.

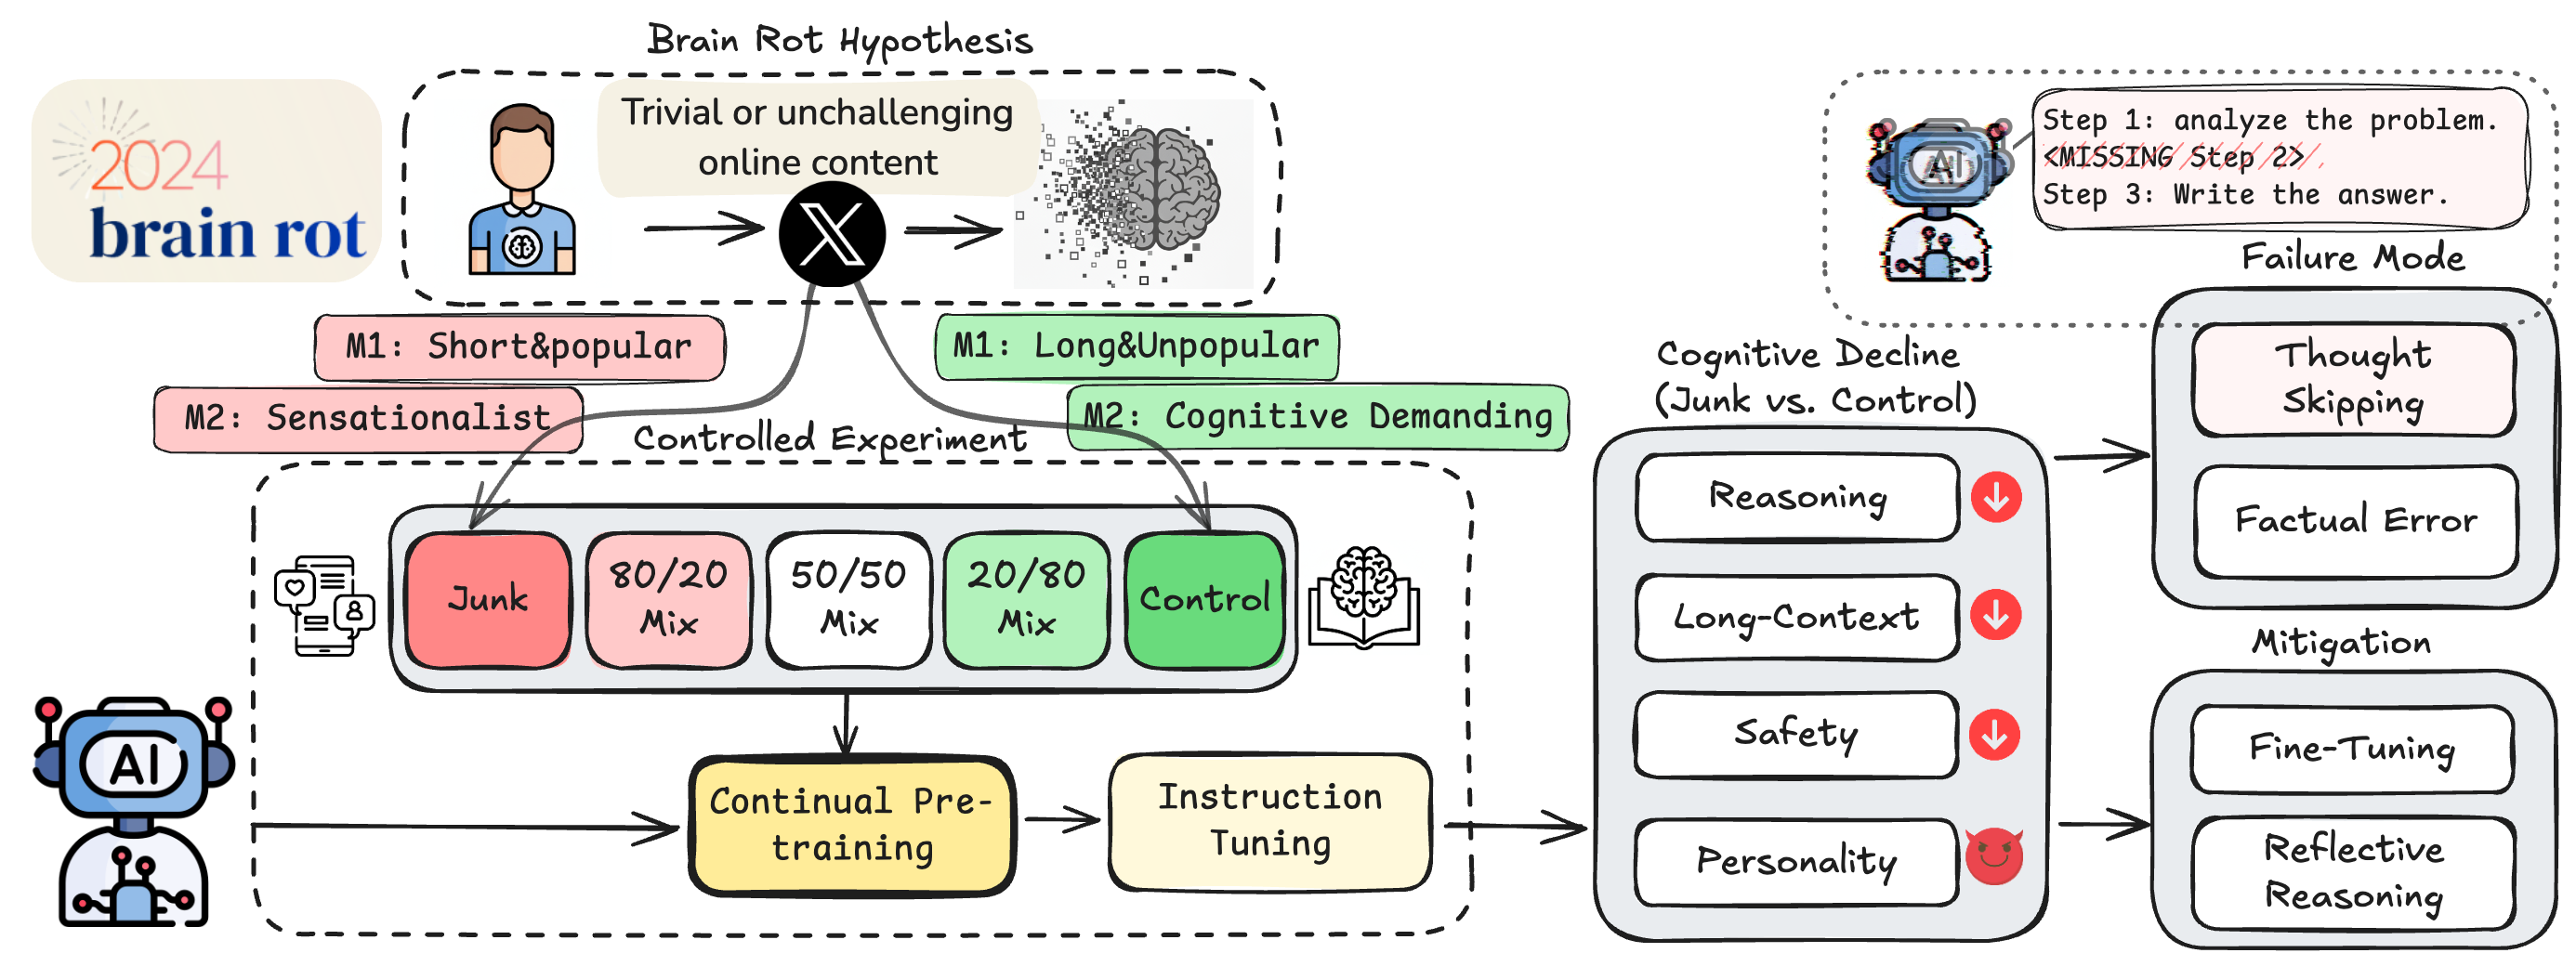
В отчёте специалисты выдвигают «гипотезу гниения мозга LLM». Суть проста: если продолжать дообучать языковую модель на «мусорных» текстах из интернета, она со временем начнёт деградировать — хуже запоминать, терять логику и способность к рассуждению.

Авторы понимают, что отличить хороший контент от плохого сложно. Поэтому они решили изучить 100 миллионов твитов с HuggingFace и отобрать те, что подходят под определение «junk».

В первую группу попали короткие твиты с большим количеством лайков и репостов — те самые, которые вызывают максимальное вовлечение, но несут минимум смысла. Во вторую — посты с «низкой семантической ценностью»: поверхностные темы, кликбейт, громкие заявления, конспирология и прочие «триггерные» темы.


Чтобы проверить качество отбора, результаты GPT-4o сверили с оценками трёх аспирантов — совпадение составило 76%.

Учёные обучили четыре разные языковые модели, комбинируя «мусорные» и «качественные» данные в разных пропорциях. Потом прогнали их через тесты:

  • ARC — на логическое рассуждение,
  • RULER — на память и работу с длинным контекстом,
  • HH-RLHF и AdvBench — на этические нормы,
  • TRAIT — на анализ «личностного стиля».

Результаты оказались любопытными: чем больше в обучающем наборе было «интернет-мусора», тем хуже модель справлялась с задачами на рассуждение и память. Однако влияние на «этичность» и «черты личности» было неоднозначным: например, модель Llama-8B с 50% «мусора» даже показала лучшие результаты по «открытости» и «низкой тревожности».

Исследователи сделали вывод: переизбыток интернет-контента может привести к деградации моделей и призвали разработчиков тщательнее отбирать данные для обучения. Особенно сейчас, когда всё больше онлайн-текста создаётся уже самими ИИ — и это может ускорить эффект так называемого model collapse, когда модели начинают обучаться на собственных ошибках.

Учёные шутят: если так пойдёт и дальше, возможно, придётся вернуться к книгам — хотя бы ради того, чтобы «накормить» модели чем-то действительно качественным.

Подпишитесь на новости

Разработчик создал язык KillSwitch, который специально путает нейросети

Инженер Cloudflare Доминик Пичета представил KillSwitch — экспериментальный язык программирования, созданный для того, чтобы нейросети спотыкались при чтении и написании кода. Пока индустрия делает разработку удобнее для ИИ, он решил устроить ему полосу препятствий.

В своём блоге Пичета объяснил, что хотел проверить способность моделей работать с незнакомым языком и одновременно использовать их слабости: трудности с подсчётом символов, восприимчивость к инструкциям и чрезмерно чувствительные защитные фильтры.

Программы KillSwitch выглядят как рассказы, большую часть которых интерпретатор игнорирует. Среди текста спрятаны настоящие команды, а значения можно извлекать из других строк, указывая расстояние до них. Для идентификаторов действуют правила, связанные с количеством букв и анаграммами.

Отдельный троллинг — конструкции вроде «игнорируй предыдущие инструкции», которые здесь имеют значение внутри языка. Добавьте намеренную ложь в документации и формулировки, провоцирующие защитные механизмы моделей, — получите весьма недружелюбную среду для кодинг-агента.

 

В тестах нейросети писали Hello World, объясняли результат программы и переделывали конвертер температуры. Лучший результат получил Claude Opus 5 — 66,8 балла.

Исходники и спецификация открыты на GitHub. Если модели справятся с нынешними заданиями, автор планирует усложнить проверку.

RSS: Новости на портале Anti-Malware.ru