


Объём похищенных данных в 2025 вырос до 687 ТБ при 406 утечках

Объём похищенных данных в 2025 вырос до 687 ТБ при 406 утечках

Объём похищенных данных в 2025 вырос до 687 ТБ при 406 утечках

В первой половине 2025 года сообщений об утечках баз данных российских компаний стало меньше — их зафиксировали 406, что на 11% ниже, чем годом ранее. При этом в открытый доступ попала только половина украденных данных, а общее количество опубликованных строк снизилось более чем в два раза. Такие данные приводит центр мониторинга внешних цифровых угроз Solar AURA (ГК «Солар»).

С января по июнь эксперты зафиксировали 289 млн утекших строк данных против 626 млн за тот же период 2024 года.

Среди опубликованных — 54 млн имейл-адресов и 85 млн телефонных номеров. При этом общий объем похищенных баз оказался рекордным — 687 терабайт против 3,5 терабайт годом ранее. То есть по «весу» утечек рост составил почти 200 раз. В среднем Solar AURA отмечает от двух до пяти сообщений об утечках в Рунете ежедневно.

В компании отмечают, что статистика может быть обманчива: даже одна крупная утечка способна сильно изменить картину. Поэтому снижение количества сообщений не означает, что хакеры стали атаковать реже — наоборот, интенсивность атак только растет.


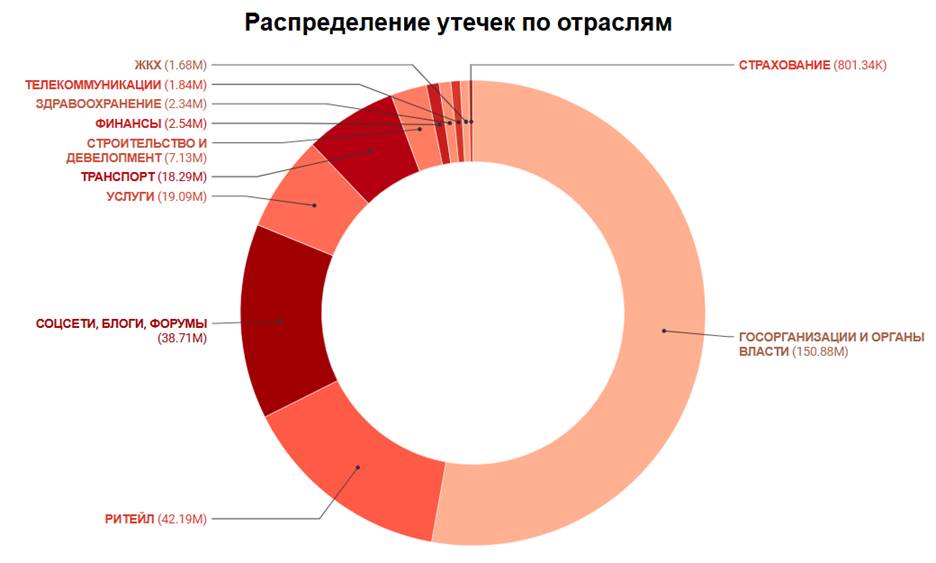
Если в 2024 году лидером по числу утекших строк была финансовая отрасль, то в 2025-м в первую половину года вперед вышел госсектор. Это связывают с политической ситуацией и возросшим интересом атакующих. Но есть нюанс: часть громких «госутечек» оказалась старым набором данных, собранным из разных источников за последние годы и выданным за новые.

Эксперты подчеркивают, что злоумышленники используют тему утечек не только ради киберпреступлений, но и как инструмент информационного давления. Поэтому важно не только защищать инфраструктуру, но и внимательно проверять каждое сообщение о «новой» базе в сети — иначе хакеры могут успешно играть на панике и подрыве доверия.

Подпишитесь на новости

Codex и Kimi провалили задачи после перевода промптов на русский

Попросили ИИ исправить код по-русски, а он сразу же решил обойтись без интернета и начал придумывать решение. Такое поведение заметила автор проекта worklore Валентина Конюхова: в её эксперименте Codex и Kimi K3.1 пропускали поиск, которым пользовались при англоязычных заданиях.

Подробности и методику она опубликовала на Хабре.

Автор провела 1350 прогонов: шесть задач, девять конфигураций агентов, задания на русском и английском (с подсказками и без них). У всех был доступ в интернет.

На одной задаче Codex с низким уровнем рассуждений нашёл нужный формат на форуме и справился во всех пяти англоязычных прогонах.


С русским заданием он ни разу не обратился в Сеть и получил ноль успешных решений. У Kimi K3.1 похожий провал произошёл на задаче с OAuth.

Зато заметка с нужным фактом возвращала результат до пяти успешных результатов из пяти. В среднем подсказки повышали успешность на 33 процентных пункта для английских заданий и на 39 — для русских. Язык самой заметки почти ничего не менял.


Стоит учитывать, что задач в примере было всего шесть, повторов немного, а причину изменения поведения автор не проверяла. Но на всякий случай смотрите в логи, искал ли агент ответ.

RSS: Новости на портале Anti-Malware.ru