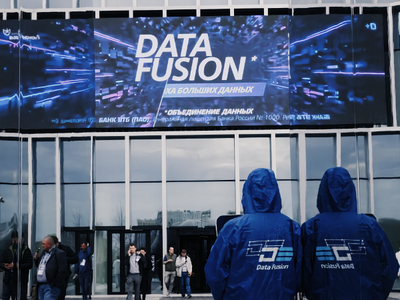
У ступенек модного кластера «Ломоносов» лежат вповалку брошенные самокаты прокатных контор, на входе организован строгий досмотр, а в залах «Молекула», «Атом» и «Физика» кресла заняли айтишники, чиновники, гости из Китая и философ Дугин.
Конференция Data Fusion 2025, прошедшая 16–17 апреля в московском технологическом кластере «Ломоносов», собрала экспертов из ИТ-индустрии, государственного сектора, науки и бизнеса. Среди участников — представители ВТБ, ИТ-холдинга Т1, МФТИ, Ростелекома, Альфа-Банка, X5 Group и Минцифры.
Министр цифрового развития России Максут Шадаев на ключевой сессии «Разговор с министром» обозначает приоритетные метрики, по которым Минцифры видит эффективность своей работы:
- Рост доли пользователей, которые выбирают цифровые каналы получения госуслуг.
- Индексы удовлетворённости граждан как электронными, так и офлайн-сервисами.
Если людям будет удобнее обращаться в МФЦ, чем на «Госуслуги», — значит, говорит министр, Минцифры нужно работать лучше. Шадаев также обратил внимание на разрыв в цифровой зрелости как среди регионов, так и между ведомствами.
«Есть те, кто умеет “выбивать деньги" на цифру — у них грамотная команда, подходы, экспертиза и цифровая трансформация. А есть те, кто стоит на месте, — отметил он. — Сокращение этого разрыва — одна из ключевых задач Минцифры».
В числе приоритетов министерства — борьба с кибермошенничеством, обозначенная указом президента о национальных целях развития. По нему «создание экономики данных и снижение процента мошенничества» — теперь задокументированная ответственность Минцифры.
Уже сейчас работает единая платформа для проверки сим-карт, оформленных на гражданина, а следующим шагом станет внедрение централизованного механизма управления пользовательскими согласиями на обработку данных.
В планах также есть подача онлайн-заявлений о цифровых преступлениях с моментальной реакцией инфраструктуры (включая блокировку счетов), а также признание использования ИИ как отягчающего обстоятельства в таких правонарушениях.
Среди стратегических направлений — развитие онлайн-сервисов, импортонезависимость, внедрение отечественных решений в критическую инфраструктуру.
Со сцены зала «Молекула», Шадаев также в полуироничном ключе заметил, что «искусственный интеллект точно может заменить половину чиновников». Эта фраза вызвала в зале одобрительный смех и аплодисменты.
Мы не копируем, а переосмысляем
В России создаются не копии западных решений, а принципиально новые подходы, говорил на полях конференции генеральный директор ИТ-холдинга Т1 Алексей Фетисов. Он привёл в пример крупнейшие финтех-системы, построенные в России на микросервисной архитектуре и open source-инструментах, в обход громоздких западных платформ.
Фетисов также рассказал о масштабном внутреннем внедрении языковых моделей: 1700 разработчиков холдинга уже используют собственную ИИ-модель с открытым кодом, обученную на внутренних данных. По его словам, она позволяет автоматизировать рутинные процессы, включая покрытие автотестами и генерацию кода, а также кратно повышает эффективность разработки.
В числе клиентских кейсов — внедрение системы отслеживания изменений в нормативной документации на базе больших языковых моделей: при изменении одного регламента система автоматически анализирует связи с другими и предлагает корректировки.
Также Фетисов подчеркнул необходимость создания шаблонов и архитектурных стандартов для совместимости решений от разных вендоров. В рамках ассоциаций и совместных проектов с НЦК ИСУ и Банком России холдинг Т1 участвует в разработке таких решений — с опорой на реальную практику и открытые API.
ИИ для логистики ВТБ: пилот от Т1
На конференции также был представлен пилот от холдинга Т1 для банка ВТБ — «Оптимизатор. Маршруты», единое ИИ-решение для управления логистикой выездных менеджеров. Оно учитывает навыки сотрудников, способы передвижения, распределяет маршруты по приоритетам и снижает зависимость от сторонних геосервисов. ВТБ планирует внедрить систему до конца I квартала 2026 года.
Постмодернизм и деньги
За два дня конференции прошло 70 сессий в семи треках, включая практики внедрения ИИ, вопросы регулирования экономики данных, перспективы импортонезависимости и кейсы использования машинного обучения. На одну из сессий к участию в дискуссии на тему ИИ в эпоху постмодернизма был приглашен и философ Александр Дугин.
Еще в рамках конференции прошли соревнования по машинному обучению Data Fusion Contest с призовым фондом 3 млн рублей, а также вручение премий Data Fusion Awards за лучшие проекты в области ИИ и анализа данных.