



Операторы TrickBot проверяют разрешение экрана, чтобы избежать анализа

Операторы TrickBot проверяют разрешение экрана, чтобы избежать анализа

Операторы TrickBot проверяют разрешение экрана, чтобы избежать анализа

Операторы вредоносной программы TrickBot начали использовать новый способ, позволяющий установить разрешение экрана жертвы, а также обойти детектирование антивирусными продуктами и анализ со стороны ИБ-специалистов.

Авторы TrickBot ещё в прошлом году добавили новую функцию, дающую вредоносу возможность моментально прекращать работу, если он зафиксирует нестандартные разрешения экрана — 800x600 и 1024x768. Теперь исследователи наткнулись на новую вариацию атак TrickBot, в которых злоумышленники добавили HTML-вложениям код верификации.

Как отметил специалист, скрывающийся за псевдонимом TheAnalyst, новые вложения ведут себя иначе при открытии в виртуальной среде. Например, в реальную систему загружается ZIP-архив, а вот пользователя виртуальной машины аттач просто перенаправляет на официальный сайт ABC (American Broadcasting Company).

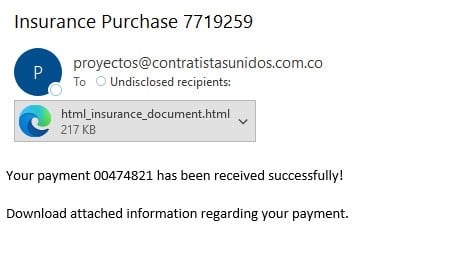
Письма операторов TrickBot замаскированы под уведомления о приобретении страховки. Если жертва клюнет на уловку и откроет HTML-вложение в браузере, запустится встроенный вредоносный скрипт и в систему установится пейлоад.


Помимо этого, на злонамеренной странице пользователя встречает сообщение, в котором отправитель просит дождаться загрузки документа. Также в HTML-коде есть пароль, который необходимо ввести для доступа к упомянутому документу.

Атакующие используют метод HTML smuggling («контрабанда HTML»), позволяющий обойти фильтрацию контента в браузере и поместить вредоносный файл в систему жертвы. Эта техника встречается впервые у TrickBot, однако в целом она не новая.

Подпишитесь на новости

1,8 ТБ и вагон ошибок: как выгрузка с Яндекс Диска превратилась в квест

Пользователь «Яндекс Диска» решил сделать резервную копию 1,8 ТБ файлов, а также примерно 160 ГБ фотографий и получил приключение с ошибками API, зависшими загрузками и собственными скриптами.

По его словам, после октябрьских проблем с дата-центрами привычное скачивание папок через веб-интерфейс стало недоступно.

Подробности инженер Сергей Терёхин, известный как KenGuru66, описал  в собственном разборе на Хабре.

План был такой: rclone, сервер в Нидерландах, копия в Google Drive. Но стандартная аутентификация позволяла получить сведения о диске, а обращения к файлам возвращали ошибку 410. Доступ удалось наладить с другим OAuth-токеном.

Фотографии из безлимитной автозагрузки добавили веселья: для копирования через выбранный API их пришлось переместить в обычную папку. После этого они начали занимать место в тарифе. Более 30 тысяч снимков переносились около шести часов.

В выборке из 300 случайных файлов автор смог получить начало только 146. По важной папке с документами он скопировал и проверил по MD5 2315 файлов; ещё 3079 на момент публикации оставались недоступны.

Потерю данных автор не утверждает, он продолжает повторные загрузки. Скрипты опубликованы на GitHub.

RSS: Новости на портале Anti-Malware.ru