



Новый тип атаки позволяет извлечь зашифрованные данные из PDF-файлов

Новый тип атаки позволяет извлечь зашифрованные данные из PDF-файлов

Новый тип атаки позволяет извлечь зашифрованные данные из PDF-файлов

Немецкие учёные выработали новый тип атаки, благодаря которому можно извлекать и красть данные из зашифрованных PDF-файлов. В некоторых случаях для этого даже не потребуется взаимодействие с пользователем, заявили специалисты.

Атака получила имя PDFex. Существуют две вариации PDFex, которые были успешно протестированы против 27 программ для просмотра PDF (как десктопных, так и веб-версий).

В тестировании принимали участие и популярные приложения: Adobe Acrobat, Foxit Reader, Evince, Nitro, а также встроенные в Chrome и Firefox PDF-вьюверы.

Разработанный исследователями метод атаки выбирает своей целью схемы шифрования, поддерживаемые стандартом Portable Document Format (PDF). Поддержка «родного» шифрования PDF необходима для того, чтобы пользователь не был привязан к одному приложению, а смог открыть зашифрованные в одной программе файлы с помощью другого софта.

Так или иначе, учёные Мюнхенского университета выявили проблемы безопасности поддержки шифрования в стандарте PDF.

«Наш способ позволяет извлечь данные в виде простого текста из зашифрованных документов. Этот метод шифрования уязвим перед двумя видами нашей атаки», — пишет команда экспертов.

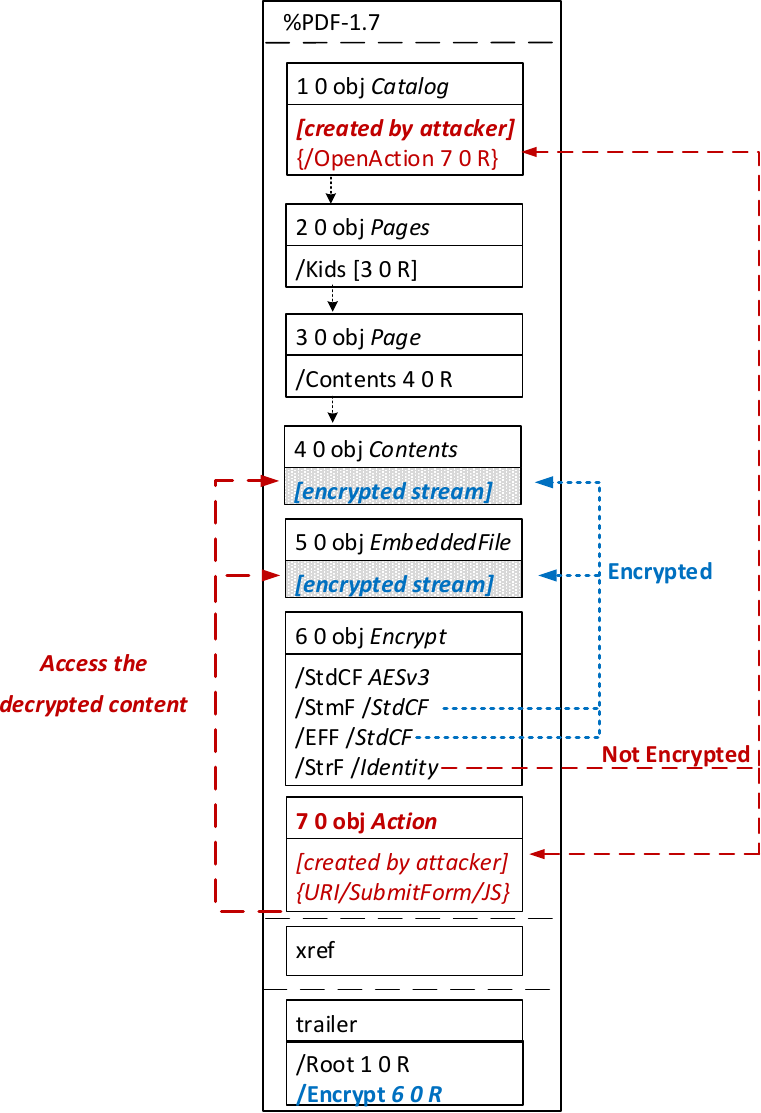
Первый вид атаки, о котором говорят учёные, использует нюанс в работе программ для просмотра PDF — оказалось, что они шифруют не весь PDF-файл целиком, а оставляют некоторые части незашифрованными.

Вторая вариация PDFex работает по обратному принципу — атакуются именно зашифрованные части документа в формате PDF. Происходит это за счёт CBC — кусков кода, которые исследователи «натравили» на зашифрованный контент для модификации данных.

Подпишитесь на новости

Производители ТВ признали, что полностью отключить сбор данных нельзя

Издание The Verge задало производителям телевизоров и ТВ-приставок 17 вопросов о том, какие данные они собирают о пользователях. Из 11 компаний ответили семь: Amazon, Apple, Google, LG, Roku, Samsung и TCL. Panasonic, Sony и Vizio отвечать не стали, с Hisense связаться не удалось. Apple ответила лишь на часть вопросов.

Ответы компаний опубликовала The Verge. Главной темой стало автоматическое распознавание контента (ACR).

Эта технология определяет, что смотрит человек, и используется в том числе для показа рекламы и подсчета аудитории. У Samsung, LG и Amazon ACR по умолчанию выключен.

Samsung утверждает, что после отключения функции удаляет собранные данные со своих серверов. LG распознает контент по звуковым отпечаткам, а при включенном ACR определяет местоположение по соседним сетям Wi-Fi. Расшифровки голосовых команд у LG могут храниться без шифрования.

Google при стандартной настройке сразу включает сбор диагностики, персональные рекомендации и рекламу. Google TV передает компании IP-адрес и данные о соседних сетях Wi-Fi, по которым можно определить местоположение. Apple заявила, что Apple TV 4K не использует ACR и не делает снимков экрана.

Amazon, Google, Samsung и Roku признали, что полностью отказаться от передачи данных нельзя. Если телевизор отключен от интернета, устройства Amazon, Google, Roku, Samsung и TCL сохраняют часть данных и отправляют их после подключения.

Исследование Северо-Восточного университета показало, что телевизоры Vizio продолжали отправлять данные и после отказа пользователя от сбора. В компании назвали это служебными данными. У Samsung и Roku поток данных после отказа сократился, но полностью не прекратился.

RSS: Новости на портале Anti-Malware.ru