



Машинное обучение позволяет обойти ReCAPTCHA

Машинное обучение позволяет обойти ReCAPTCHA

Машинное обучение позволяет обойти ReCAPTCHA

Исследователи из Колумбийского университета разработали автоматическую систему, которая успешно решает большинство каптч, предлагаемых сервисом Google reCAPTCHA. Такие каптчи используют тысячи сайтов, в том числе Google и Facebook.

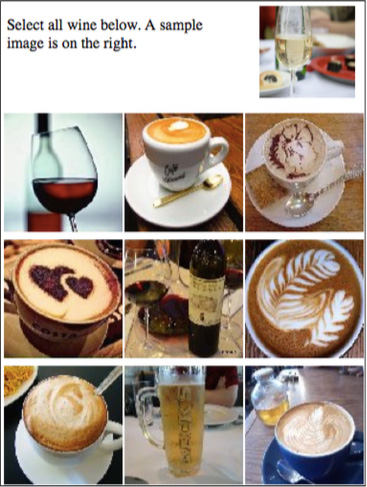
Речь идёт о преодолении относительно свежей разновидности каптчи, для решения которой нужно выбрать из предложенного списка картинки, удовлетворяющие тому или иному требованию — например, фотографии водоёмов или сосудов с вином.


hero-recaptcha-demo

recaptcha


Задача решается в два этапа. На первом этапе система получает куки, при помощи которых Google может следить за её поведением, а затем какое-то время ведёт себя максимально человекообразно: посещает различные сайты со случайным интервалом, соблюдает суточный цикл и т.д. Это нужно для того, чтобы Google не заподозрил в ней робота. Роботам он выдаёт более сложные каптчи.

На втором этапе она разбирает каптчу и пытается понять, что изображено на предъявленных картинках. Для этого система использует несколько методов. Во-первых, она обращается к обратному поиску по изображениям в Google Images. Если поисковику известна эта картинка, он сообщает соответствующий текстовый запрос. Во-вторых, система прогоняет её через несколько классификаторов, доступных в виде бесплатных веб-сервисов или библиотек. В-третьих, она проверяет, не знакома ли ей эта картинка. Картинки, которые часто повторяются в разных каптчах, разработчики описали вручную, пишет xakep.ru.

В итоге системе удаётся подобрать текстовые описания для каждой картинки. Трудность заключается в том, что найденные описания далеко не всегда совпадают с подсказкой. Эта проблема решена при помощи ещё одного классификатора, который пытается определить соответствие между словами в описаниях и текстом подсказки.

Систему протестировали на каптчах с сайтов Google и Facebook. Гугловские каптчи удалось обойти в 70,78 процентов случаев. Каптчи с Facebook оказались ещё проще. Система побеждала их в 83,5 процентах случаев. Среднее время решения каптчи составило 19,2 секунды.

Хакеры надели маски ChatGPT и DeepSeek для атак на российские сайты

Злоумышленники маскируют вредоносные запросы к веб-приложениям российских компаний под трафик популярных ИИ-ассистентов. По данным Solar WAF, в ход пошли имена DeepSeek, ChatGPT, Perplexity, Claude и Grok. Для маскировки атакующие подменяют HTTP-заголовок User-Agent, по которому сервер определяет обращающееся к нему приложение.

В запросах указывались значения DeepSeekBot, ChatGPT-User, Perplexity-User, Claude-User и GrokBot. Однако за громкими названиями скрывались сканирование уязвимостей и попытки атак.

Первые подобные обращения специалисты зафиксировали 12 августа 2026 года под видом DeepSeekBot. С 27 августа к маскараду присоединились остальные ассистенты. В июне и июле трафика с такими идентификаторами в анализируемой выборке Solar WAF не наблюдалось.

Главный расчёт злоумышленников строится на доверии. Владельцы сайтов всё чаще воспринимают ИИ-агентов как источник клиентов, лидов и полезного трафика, поэтому могут применять к ним менее строгие правила. Проблема в том, что User-Agent не является удостоверением личности: написать там ChatGPT-User способен кто угодно.

Согласно данным «Солара», в 53% выявленных случаев злоумышленники пытались проводить DNS Rebinding, способный заставить систему обращаться к внутренним ресурсам. Ещё 12% запросов были связаны с попытками утечки данных, 4% — с Path Traversal для доступа к файлам за пределами разрешённых каталогов. Остальные 31% включали другие техники, в том числе старые добрые SQL-инъекции.

Эксперты прогнозируют дальнейшее усложнение атак с применением ИИ, включая уникальные сценарии, которые могут не распознаваться сигнатурами.

RSS: Новости на портале Anti-Malware.ru