



Машинное обучение позволяет обойти ReCAPTCHA

Машинное обучение позволяет обойти ReCAPTCHA

Машинное обучение позволяет обойти ReCAPTCHA

Исследователи из Колумбийского университета разработали автоматическую систему, которая успешно решает большинство каптч, предлагаемых сервисом Google reCAPTCHA. Такие каптчи используют тысячи сайтов, в том числе Google и Facebook.

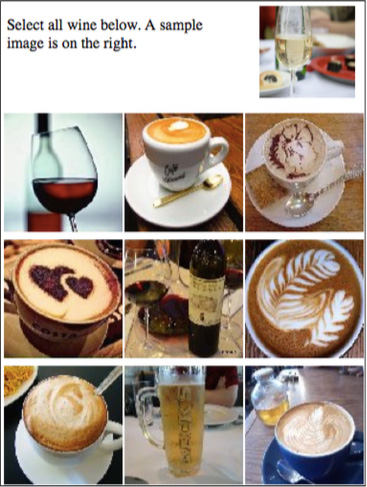
Речь идёт о преодолении относительно свежей разновидности каптчи, для решения которой нужно выбрать из предложенного списка картинки, удовлетворяющие тому или иному требованию — например, фотографии водоёмов или сосудов с вином.


hero-recaptcha-demo

recaptcha


Задача решается в два этапа. На первом этапе система получает куки, при помощи которых Google может следить за её поведением, а затем какое-то время ведёт себя максимально человекообразно: посещает различные сайты со случайным интервалом, соблюдает суточный цикл и т.д. Это нужно для того, чтобы Google не заподозрил в ней робота. Роботам он выдаёт более сложные каптчи.

На втором этапе она разбирает каптчу и пытается понять, что изображено на предъявленных картинках. Для этого система использует несколько методов. Во-первых, она обращается к обратному поиску по изображениям в Google Images. Если поисковику известна эта картинка, он сообщает соответствующий текстовый запрос. Во-вторых, система прогоняет её через несколько классификаторов, доступных в виде бесплатных веб-сервисов или библиотек. В-третьих, она проверяет, не знакома ли ей эта картинка. Картинки, которые часто повторяются в разных каптчах, разработчики описали вручную, пишет xakep.ru.

В итоге системе удаётся подобрать текстовые описания для каждой картинки. Трудность заключается в том, что найденные описания далеко не всегда совпадают с подсказкой. Эта проблема решена при помощи ещё одного классификатора, который пытается определить соответствие между словами в описаниях и текстом подсказки.

Систему протестировали на каптчах с сайтов Google и Facebook. Гугловские каптчи удалось обойти в 70,78 процентов случаев. Каптчи с Facebook оказались ещё проще. Система побеждала их в 83,5 процентах случаев. Среднее время решения каптчи составило 19,2 секунды.

По ту сторону ChatGPT: сотни подрядчиков читают реальные переписки

OpenAI привлекла сотни сторонних специалистов для ручного анализа диалогов пользователей с ChatGPT. Подрядчики видят реальные запросы и ответы, в которых могут встречаться личные, медицинские и другие конфиденциальные сведения.

По данным расследования 404 Media, работа проводится в рамках проекта Lily. Рецензенты кратко описывают запрос пользователя, сравнивают четыре варианта ответа модели и выставляют им оценки от одного до семи.

Отдельно они отмечают чрезмерную угодливость чат-бота, попытки очеловечить себя, неуместные эмодзи и другие особенности поведения.

Имена владельцев аккаунтов в интерфейсе скрываются, а переписки предварительно обрабатывает Privacy Filter. Однако OpenAI признала изданию, что система не всегда удаляет все персональные данные.

По утверждению журналистов, проверяющим также может показываться блок пользовательских воспоминаний с контекстом предыдущих разговоров и примерным местоположением.

Подрядчиков нанимают через внешние компании, включая Crossing Hurdles и Mercor. Некоторые специалисты получают более $50 в час. Подобный подход использует не только OpenAI: Anthropic также подтвердила 404 Media, что люди участвуют в оценке диалогов с Claude.

OpenAI официально указывает, что разговоры пользователей персональных тарифов могут применяться для улучшения моделей. Запретить использование новых чатов можно в разделе Settings → Data Controls, отключив параметр Improve the model for everyone.

Настройка действует на весь аккаунт, но не отменяет обработку данных, использованных ранее. Временные чаты не идут на обучение, хотя могут проверяться для выявления неправомерных действий.

RSS: Новости на портале Anti-Malware.ru